Logits、Softmax 与概率:模型如何选择下一个 Token?
在上一篇文章中,我们了解了 Prompt、Context 和 Chat Template 如何共同组成模型真正看到的输入。
输入经过 Transformer 多层计算后,模型会得到上下文相关的隐藏状态。但隐藏状态还不是文字,也不是 Token ID。模型需要回答一个核心问题:
在当前上下文之后,词表中的哪个 Token 最适合作为下一个输出?
为此,模型会依次完成:
1 | 隐藏状态 |
本文将重点介绍 Logits、Softmax 和概率的含义,以及 Temperature、Top-k、Top-p 等生成参数如何改变最终选择。
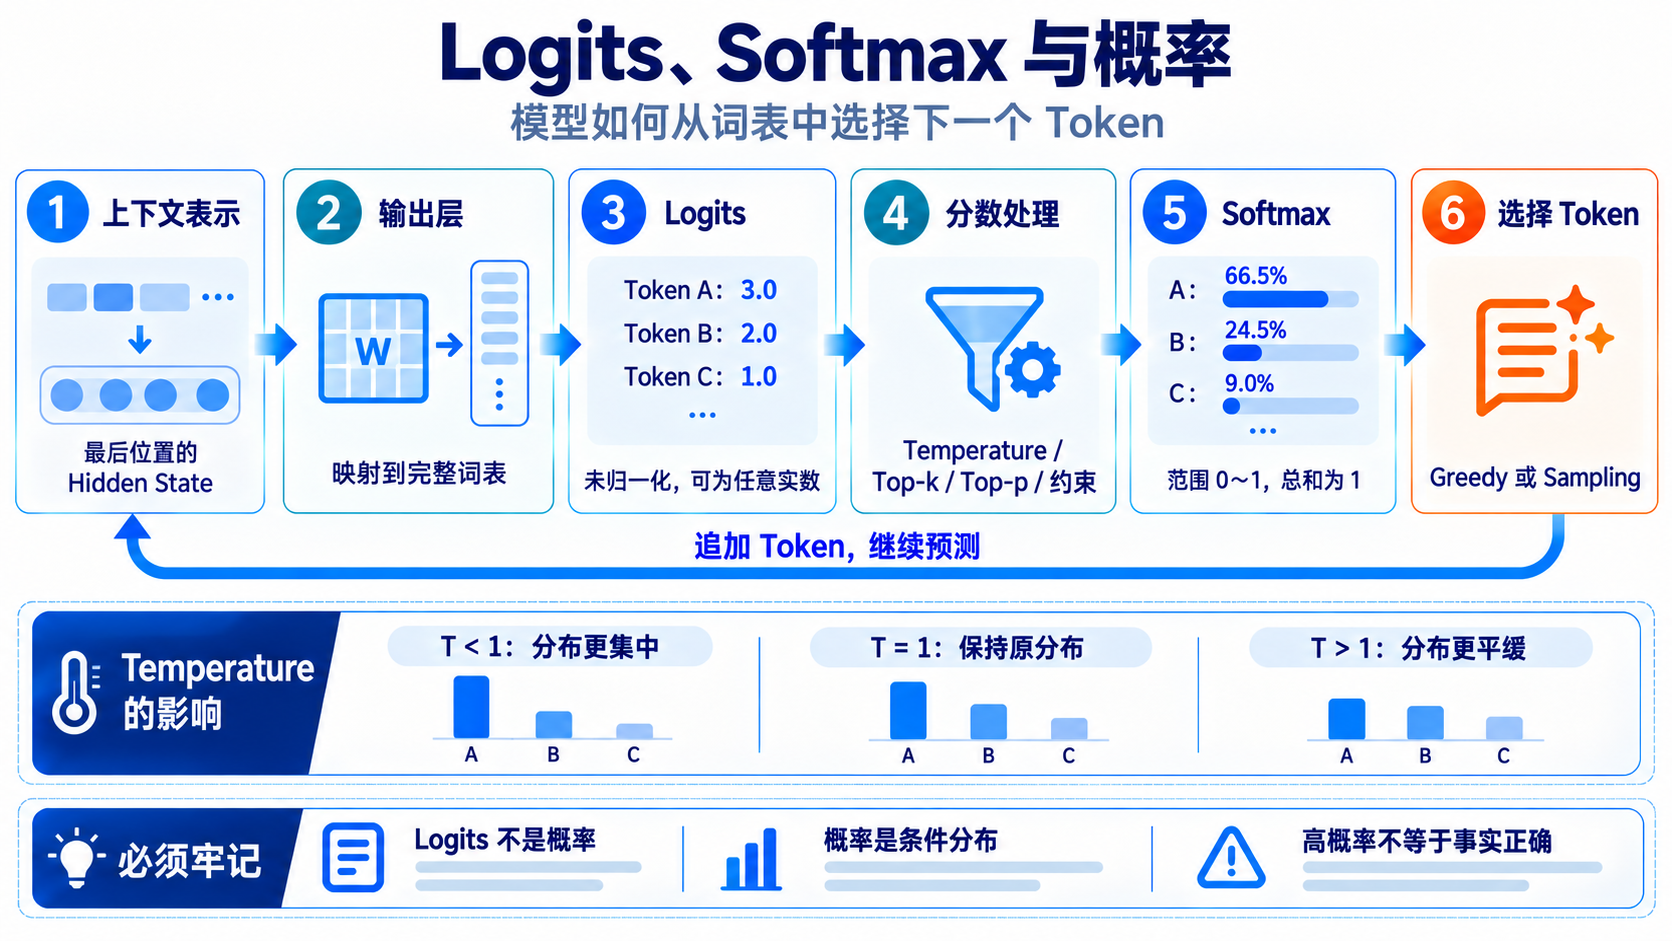
先理解三个核心概念
| 概念 | 含义 | 关键特点 |
|---|---|---|
| Logits | 模型对词表中每个候选 Token 产生的原始分数 | 未归一化,可以是任意实数 |
| Softmax | 将一组分数转换为概率分布的函数 | 每项介于 0 和 1,总和为 1 |
| Probability | 某个 Token 在当前上下文和生成规则下被选择的相对概率 | 不是事实正确率 |
三者之间的关系是:
1 | Logits 决定候选 Token 的相对偏好 |
从隐藏状态到完整词表
假设模型输入经过 Transformer 后得到隐藏状态:
1 | hidden_states shape = [batch_size, sequence_length, hidden_size] |
对于 Qwen2.5-0.5B-Instruct,隐藏维度是 896,词表大小是 151,936。模型需要把长度为 896 的隐藏向量映射为词表中 151,936 个 Token 的分数。
这个映射通常由 Language Model Head 完成:
1 | 最后位置的 Hidden State |
从数学上看,可以简化理解为:
1 | logits = hidden_state × W + b |
其中:
hidden_state是当前位置的隐藏状态;W是把隐藏维度映射到词表维度的权重矩阵;b是可选的偏置项;logits的长度等于词表大小。
具体模型可能让输出层权重与输入 Embedding 权重共享,也可能没有单独的偏置项。因此,这里是帮助理解的通用形式,不代表所有模型完全相同。
Logits 是什么?
Logits 是模型输出的未归一化分数。
例如,当前上下文之后有三个候选 Token:
| Token | Logit |
|---|---|
| A | 3.0 |
| B | 2.0 |
| C | 1.0 |
这组数字表达:
1 | A 比 B 更受模型偏好 |
但不能直接说:
1 | A 的概率是 3 |
原因是 Logits:
- 可以是负数;
- 不要求小于 1;
- 总和不要求等于 1;
- 主要通过相对差值表达模型偏好。
例如:
1 | [3, 2, 1] |
与:
1 | [103, 102, 101] |
经过 Softmax 后会得到相同的概率分布,因为三个分数都增加了相同常数,彼此之间的差值没有改变。
Softmax:把分数转换为概率
Softmax 会先对每个 Logit 取指数,再除以所有指数值之和:
1 | softmax(zᵢ) = exp(zᵢ) / Σ exp(zⱼ) |
对于:
1 | logits = [3, 2, 1] |
计算结果约为:
| Token | Logit | exp(Logit) | Softmax 概率 |
|---|---|---|---|
| A | 3 | 20.09 | 66.5% |
| B | 2 | 7.39 | 24.5% |
| C | 1 | 2.72 | 9.0% |
Softmax 结果具有以下特点:
- 每个值都在 0 和 1 之间;
- 所有候选概率之和为 1;
- Logit 越大,概率通常越高;
- Logit 之间的差值会被指数运算放大;
- 保持 Logit 差值不变并整体平移,不会改变概率分布。
为什么要减去最大 Logit?
直接计算 exp(logit) 可能发生数值溢出。例如:
1 | logits = [1000, 999, 998] |
exp(1000) 已经远远超出普通浮点数能够安全表示的范围。
由于 Softmax 对整体平移不敏感,可以先减去最大值:
1 | [1000, 999, 998] - 1000 |
然后计算:
1 | softmax([0, -1, -2]) |
即可得到相同概率,同时避免指数值过大。
成熟框架中的 torch.softmax()、log_softmax() 和交叉熵实现已经处理了数值稳定性。实际代码中应优先使用框架函数,而不是手写朴素指数计算。
这是一个条件概率分布
语言模型预测的并不是 Token 的固定概率,而是给定当前上下文后的条件概率:
1 | P(next_token | context) |
例如:
1 | 中国的首都是 |
与:
1 | 日本的首都是 |
最后一个位置的隐藏状态不同,Logits 和概率分布也会不同。
同一个 Token 在不同 Context 下的概率可能有巨大差异。因此,“某个词的概率是多少”这个问题缺少完整上下文时通常没有确定答案。
概率不是事实正确率
假设模型给某个 Token 80% 的概率,它表达的是:
在模型参数、当前 Context 和生成配置下,该 Token 在候选分布中占据较大概率质量。
它不表示:
这个 Token 所表达的事实有 80% 的概率正确。
模型可能因为以下原因高概率地产生错误内容:
- 训练数据包含错误或过时信息;
- 问题超出模型知识范围;
- Context 提供了错误前提;
- 多个事实在语言形式上容易混淆;
- 模型学会了流畅表达,但没有可靠的事实验证机制;
- 解码过程早期选择了错误 Token,后续继续沿错误方向生成。
因此,Token 概率不应直接解释为事实置信度、答案可靠性或模型是否“确定”。
Temperature 如何改变概率分布?
Temperature 会在 Softmax 前缩放 Logits:
1 | P(tokenᵢ) = softmax(logitᵢ / T) |
其中 T 是大于 0 的温度参数。
Temperature 小于 1
1 | logits / 0.5 |
会放大 Logit 之间的差异,使概率分布更加集中。高分 Token 更占优势,输出通常更加稳定。
Temperature 等于 1
1 | logits / 1 |
保持原始 Softmax 分布。
Temperature 大于 1
1 | logits / 2 |
会缩小 Logit 之间的差异,使概率分布更加平缓,低分候选获得更多机会,输出通常更加多样。
以 [3, 2, 1] 为例:
| Temperature | A | B | C | 分布特点 |
|---|---|---|---|---|
| 0.5 | 86.7% | 11.7% | 1.6% | 更集中 |
| 1.0 | 66.5% | 24.5% | 9.0% | 原始分布 |
| 2.0 | 50.6% | 30.7% | 18.6% | 更平缓 |
Temperature 并不会向模型添加新知识,也不会自动提高事实准确率。它只改变候选概率之间的相对差异。
Temperature 为 0 吗?
数学公式中的 logits / T 不能令 T = 0。
一些产品界面会把“Temperature 0”理解为尽可能确定的生成,但具体行为由服务实现决定。在 Transformers 中需要确定性输出时,通常使用:
1 | do_sample=False |
也就是 Greedy Decoding,而不是实际计算 logits / 0。
Top-k 和 Top-p 发生在哪里?
生成时,原始 Logits 可能先经过一系列处理,再用于 Softmax 和采样:
1 | 原始 Logits |
具体处理顺序和实现细节取决于推理框架,不能假设所有系统都完全相同。
Top-k
Top-k 只保留分数最高的 k 个候选 Token,其余候选被过滤。
例如 top_k=3:
1 | 完整词表 151,936 个候选 |
Top-p
Top-p,也称 Nucleus Sampling,会从概率最高的候选开始累加,保留累计概率达到阈值 p 所需的最小候选集合。
例如候选概率为:
1 | A: 0.50 |
当 top_p=0.80 时,可能保留:
1 | A + B + C = 0.90 |
候选集合大小会随着当前概率分布变化,并不是固定数量。
推理模型中,这三个参数不起作用吗?
先说结论:这个说法不准确,不能把它当成所有推理模型的共同规律。
这里的“推理模型”容易产生两种理解:
- 如果指所有正在执行推理(Inference)的语言模型,那么说法显然不对。Temperature、Top-k 和 Top-p 本来就是推理阶段的解码参数;
- 如果指会进行多步思考的 Reasoning Model,那么也不能一概而论。参数是否可用、是否生效以及是否建议修改,取决于具体模型、推理框架和 API 服务。
推理模型并没有绕过 Logits。它通常仍然按照自回归方式生成 Token:
1 | 当前上下文 |
只要解码器启用了随机采样,并实际应用 Temperature、Top-k 或 Top-p,这些参数就会改变候选 Token 的概率分布或候选集合,因而可能同时影响推理过程和最终答案。
例如,Qwen3 官方文档不仅支持这些参数,还针对思考模式推荐 temperature=0.6、top_p=0.95、top_k=20,并明确不建议使用 Greedy Decoding。这说明“推理模型天然不受采样参数影响”并不成立。
哪种情况下它们确实不起作用?
1. 使用 Greedy Decoding
当本地推理设置为:
1 | do_sample=False |
解码器每一步都直接选择分数最高的 Token。此时这三个参数通常没有实际作用:
- 正温度只缩放 Logit 差值,不改变候选 Token 的排名,因此最高分 Token 仍然相同;
- Top-k 和 Top-p 即使执行过滤,最高分 Token 通常仍被保留;
- 最终又不进行随机采样,所以候选集合中的其他 Token 没有被选中的机会。
因此,在 Transformers 等框架中,do_sample=False 时同时设置采样参数,往往会被忽略或产生“采样参数无效”的警告。
2. 托管 API 不支持或忽略参数
有些云端推理服务会:
- 不提供某个参数;
- 接收到参数后直接报错;
- 为特定模型固定解码配置;
- 接受参数,但在特定模式下限制其取值或不采用它。
这属于产品接口和服务实现的限制,并不表示推理模型在原理上没有 Logits 或概率采样。
尤其需要注意:三个参数不一定同时受到支持。例如某个 API 可能开放 Temperature 和 Top-p,却不开放 Top-k。Google 的模型接口会分别声明模型支持哪些采样参数;如果模型的 topK 字段为空,就表示该模型不使用 Top-k,并且请求中也不允许设置它。
3. 产品将主要控制权交给“推理强度”
部分推理模型会提供类似 reasoning_effort、思考预算或 Thinking Mode 的参数。它们控制的是模型在回答前投入多少推理计算,并不等同于 Temperature:
1 | 推理强度 / 思考预算 |
服务提供方可能为了保证复杂推理的稳定性、评测可复现性以及安全策略的一致性,固定采样配置,只让用户调整推理强度。此时用户不能控制采样参数,不代表这些机制在服务内部不存在。
为什么推理模型通常不建议随意调整?
多步推理是一条连续的 Token 生成轨迹。早期一个不合适的随机选择,可能让后续推理沿着错误分支继续展开:
1 | 早期候选选择发生变化 |
因此,推理模型往往对解码配置更敏感。温度过高可能增加不稳定分支,温度过低也不一定更好:它可能放大局部最高概率选项,导致重复、循环或过早锁定错误路径。
例如,Gemini 官方文档允许配置 Temperature、Top-p 和 Top-k,但建议 Gemini 3 系列保持默认 Temperature;文档指出,将其调低可能导致循环或性能下降,复杂数学和推理任务尤其如此。这里表达的是“建议不要随意修改”,而不是“参数不起作用”。
不同场景下的准确结论
| 场景 | 是否生效 | 原因 |
|---|---|---|
本地模型,do_sample=True |
通常生效 | 解码器会执行温度缩放、候选过滤和随机采样 |
本地推理模型,do_sample=True |
通常生效 | 原理相同,但应优先采用模型官方推荐值 |
本地模型,do_sample=False |
通常没有实际作用 | 每一步直接选择最高分 Token,不进行随机采样 |
| 托管 API 明确支持参数 | 生效,但可能有取值限制 | 具体行为由 API 契约决定 |
| 托管 API 拒绝或忽略参数 | 不生效 | 服务端固定了解码策略 |
| API 未提供 Top-k | 用户无法控制 Top-k | 不应由此推断 Temperature 和 Top-p 也无效 |
实际使用时怎么判断?
不要根据“推理模型”这个名称猜测,可以依次检查:
- 查看模型卡或 API 文档是否明确支持这些参数;
- 确认当前是否启用了 Sampling,例如 Transformers 中的
do_sample=True; - 区分“不支持”“被忽略”“不建议修改”和“建议使用默认值”;
- 优先采用模型官方给出的 Generation Config;
- 如果服务提供推理强度或思考预算,先用它控制推理深度;
- 做参数实验时固定 Prompt,并使用多组随机种子比较正确率、重复率和稳定性,不要只观察一次输出。
所以,更准确的表述应该是:
Temperature、Top-k 和 Top-p 对推理模型并非天然无效。启用随机采样且推理框架实际采用这些参数时,它们仍会影响生成;在 Greedy Decoding 或服务端固定解码策略时,它们才可能没有作用。部分推理模型虽然支持这些参数,但为了保证推理质量,官方会建议保持默认配置。
Logits Processor 与 Logits Warper
推理框架可能在选择 Token 前修改分数。常见处理包括:
| 处理方式 | 对分数的影响 | 目的 |
|---|---|---|
| Repetition Penalty | 调整已出现 Token 的分数 | 减少重复 |
| Min Length | 在长度不足时压低或屏蔽 EOS | 避免过早结束 |
| Bad Words | 将禁止候选设置为不可选 | 阻止指定 Token 序列 |
| Temperature | 缩放 Logits | 调整分布集中程度 |
| Top-k | 过滤到固定数量候选 | 限制候选范围 |
| Top-p | 过滤到累计概率候选集合 | 动态限制候选范围 |
被过滤的 Token 常被设置为负无穷:
1 | logit = -∞ |
经过 Softmax 后,它的概率就是 0。
因此,需要区分:
- Raw Logits:模型前向计算直接产生的原始分数;
- Processed Scores:经过生成规则处理后的分数;
- Probabilities:对当前候选分数归一化后的概率。
Greedy 与 Sampling
Greedy Decoding
Greedy Decoding 通常翻译为贪心解码。它是最简单的 Token 选择策略:模型每生成一步,都选择当前 Logit 最大、也就是当前概率最高的 Token。
1 | 计算下一个 Token 的 Logits |
假设模型在某一步给出以下概率:
| 候选 Token | 概率 |
|---|---|
北京 |
65% |
上海 |
25% |
深圳 |
10% |
Greedy 不会按照这组概率抽签,而是直接选择概率最高的 北京。下一步,模型会在加入 北京 的新上下文上重新计算 Logits,再选择新的最高分 Token。
因为 Softmax 不改变候选的大小顺序,所以不必先计算完整概率,也可以直接对 Logits 使用 argmax:
1 | next_token_id = torch.argmax(logits, dim=-1) |
在 Hugging Face Transformers 中,通常这样启用 Greedy Decoding:
1 | output_ids = model.generate( |
这里的 do_sample=False 表示不进行随机采样。输入、模型和其他生成条件相同时,Greedy 的输出通常相同,因此适合需要结果稳定、便于复现的场景。
为什么叫“贪心”?
因为它只关心当前这一步最好的选择,不会提前搜索这个选择对后续完整句子的影响。
假设第一步有两条路径:
1 | 第一步选择 A:P(A) = 0.60 |
Greedy 会在第一步选择概率更高的 A,最终得到概率为 0.36 的路径。但如果选择第一步概率稍低的 B,完整路径概率反而是 0.396。
这就是局部最优不一定等于全局最优。Greedy 只选择当前最优 Token,不保证找到概率最高的完整序列,也不保证答案在事实性、逻辑性或表达质量上最好。
Greedy 与三个采样参数的关系
Greedy 的核心是“选最大值”,而不是“按概率抽样”:
| 参数 | Greedy 下通常是否影响结果 | 原因 |
|---|---|---|
| Temperature | 不影响 | 正温度缩放不会改变 Logit 排名 |
| Top-k | 不影响 | 最高分 Token 一定在保留的前 k 个候选中 |
| Top-p | 不影响 | 最高分 Token 会被保留,最终仍由 argmax 选中 |
因此,使用 do_sample=False 时,不应该再依靠 Temperature、Top-k 或 Top-p 控制生成风格;很多推理框架会直接忽略这些参数或给出警告。
Greedy 的优点与局限
| 优点 | 局限 |
|---|---|
| 算法简单,生成速度快 | 容易产生机械或重复的表达 |
| 通常可以稳定复现 | 缺少多样性 |
| 不需要维护多个候选序列 | 可能过早选中错误的推理路径 |
| 适合结构化输出和确定性任务 | 不保证完整序列的整体概率最高 |
需要稳定输出时,Greedy 是很自然的基线;需要创意、多样性或希望探索不同推理路径时,通常会考虑 Sampling 或 Beam Search。
Sampling
Sampling 按概率分布随机选择 Token:
1 | next_token_id = torch.multinomial(probabilities, num_samples=1) |
高概率候选更容易被选中,但低概率候选也可能出现。Temperature、Top-k 和 Top-p 通常用于控制采样范围和随机程度。
一个回答的概率如何计算?
自回归模型把完整回答分解成一系列条件概率:
1 | P(y₁, y₂, ..., yₙ | context) |
因为许多小于 1 的概率连续相乘会快速接近 0,工程中通常使用 Log Probability:
1 | log P(sequence) |
直接累加 Log Probability 更稳定,也更便于比较。
但不同长度序列的总 Log Probability 不宜直接简单比较,因为更长序列包含更多负的 Log Probability 项。Beam Search 等算法通常还会使用长度惩罚或归一化策略。
Softmax 与训练损失的关系
语言模型训练时,目标是提高真实下一个 Token 的概率。
假设正确 Token 是 B:
1 | P(B) = 0.245 |
对应的负对数似然损失为:
1 | loss = -log P(B) |
正确 Token 概率越高,损失越小;概率越低,损失越大。
PyTorch 的 Cross Entropy 通常直接接收原始 Logits 和目标 Token ID,内部以数值稳定的方式组合 Log Softmax 与负对数似然计算:
1 | loss = torch.nn.functional.cross_entropy( |
训练时不需要先手动调用 Softmax,再把概率传给 cross_entropy()。
实战一:手动观察 Softmax
下面先用三个候选分数验证公式、平移不变性和 Temperature 的影响。
1 | import torch |
实战二:查看 Qwen 的真实 Logits
下面继续使用前几篇文章中的本地模型:
1 | ./models/Qwen2.5-0.5B-Instruct |
程序会展示:
- 原始 Logits 的形状和取值范围;
- 第一个待生成位置的 Top-10 Token;
- 不同 Temperature 下的概率变化;
- 不同 Context 如何改变候选分布;
- Greedy 生成过程中每个 Token 的 Log Probability。
示例代码:将下面代码保存为 qwen_logits_walkthrough.py:
1 | import math |
执行结果
1 | /Users/jean/.pyenv/shims/uv run /Users/jean/PycharmProjects/llm-base/.venv/bin/python /Users/jean/PycharmProjects/llm-base/qwen_logits_walkthrough.py |
如何阅读输出
Logits Shape
如果输出类似:
1 | Logits shape: (1, 151936) |
表示当前 Batch Size 为 1,模型为词表中的 151,936 个 Token 分别生成了一个分数。
模型完整前向输出通常是:
1 | [batch_size, sequence_length, vocabulary_size] |
示例只取最后一个位置:
1 | outputs.logits[:, -1, :] |
因为这个位置负责预测下一个 Token。
Top-10 概率之和通常小于 1
打印出的只是概率最高的 10 个 Token。剩余概率分布在词表中的其他候选上,因此 Top-10 概率之和不一定等于 1。
代码中打印的:
1 | probabilities.sum() |
才是完整词表概率之和,应接近 1。
outputs.logits 与 generation_output.scores
直接调用模型前向传播得到的 outputs.logits 是原始模型 Logits。
generate() 返回的 scores 是生成过程每一步使用的预测分数,可能已经经过部分 Logits Processor 或生成规则处理。两者不能在所有配置下视为完全相同。
Transition Score
compute_transition_scores(..., normalize_logits=True) 可以计算实际选中 Token 的 Log Probability。
通过:
1 | math.exp(log_probability) |
可以得到该 Token 在对应生成步骤中的概率。
概率分布还能告诉我们什么?
分布集中程度
如果一个 Token 占据绝大部分概率,说明模型在当前分布下明显偏向该候选。
如果许多 Token 概率接近,说明当前生成位置存在多种语言上合理的延续方式。
可以使用熵衡量概率分布的不确定程度:
1 | H(P) = -Σ pᵢ log pᵢ |
一般来说:
- 分布越集中,熵越低;
- 分布越平缓,熵越高。
但熵较低仍不表示事实一定正确,只表示概率质量更加集中。
候选 Token 的边界
一个人类可读词语可能由多个 Token 组成。因此,查看下一 Token 概率只能分析当前一步,不能直接等同于完整词语或完整答案的概率。
例如“北京”可能被表示为一个 Token,也可能被拆成多个 Token,具体取决于 Tokenizer。
常见误区
误区一:Logits 就是概率
Logits 是未归一化分数,可以为负数或大于 1。只有经过适当归一化后才得到概率分布。
误区二:最高概率等于事实正确
Token 概率反映模型的条件生成分布,不是事实验证结果。
误区三:Softmax 前必须先让 Logits 变成正数
Softmax 可以直接处理负 Logits。指数值为正,归一化后自然得到合法概率。
误区四:Temperature 越低,答案一定越准确
低 Temperature 让分布更集中,减少随机性,但不会修复模型知识错误或错误 Context。
误区五:Temperature 越高,模型越聪明
高 Temperature 只是增加低概率候选被选中的机会,可能提升多样性,也可能增加不连贯和错误。
误区六:Temperature 为 0 就是执行 Softmax(logits / 0)
数学上不能除以 0。框架通常通过关闭采样、使用 Greedy 等方式提供确定性行为。
误区七:Top-k 与 Top-p 会增加模型知识
它们只过滤或调整现有候选分布,不能让模型获得训练时没有学到的信息。
误区八:Greedy 能找到概率最高的完整回答
Greedy 只在每一步选择当前最高分 Token,不会回头比较完整序列的全局得分。
误区九:逐 Token 概率可以直接相加
序列概率需要相乘;工程上通常累加 Log Probability。直接把普通概率相加没有对应的序列概率含义。
小结
Logits、Softmax 与概率之间的关系可以总结为:
- Transformer 为每个输入位置计算上下文相关的隐藏状态;
- Language Model Head 将最后位置的隐藏状态映射到完整词表;
- 每个候选 Token 得到一个原始 Logit;
- Logits 是未归一化分数,主要通过相对差值表达偏好;
- Softmax 将分数转换为总和为 1 的条件概率分布;
- Temperature 改变分布的集中程度,但不增加模型知识;
- Top-k、Top-p 和其他处理器会过滤或修改候选分数;
- Greedy 选择当前最高分 Token,Sampling 按概率随机选择;
- 完整序列概率由一系列条件概率相乘得到,通常使用 Log Probability 计算;
- Token 概率不是事实正确率,也不是模型可靠性的直接证明。
- 推理模型仍然会产生 Logits;采样参数是否生效,要看解码模式和服务接口,不能仅凭“推理模型”这个名称判断。
理解概率分布之后,下一篇将介绍上下文窗口与 KV Cache,解释模型能够处理多少 Token,以及逐 Token 生成时如何避免重复计算全部历史内容。