Prompt、Context 与 Chat Template:模型真正看到了什么?
在前两篇文章中,我们已经了解了一次 LLM 请求的完整过程,以及 Tokenizer 如何把文本转换为 Token ID。
接下来会遇到三个经常一起出现、也最容易混淆的概念:
- Prompt;
- Context;
- Chat Template。
用户可能只输入了一句话,但模型真正接收到的内容还可能包括 System Message、历史对话、工具结果、检索资料、角色标记和特殊 Token。
因此:
用户输入的文字,不一定等于模型最终看到的完整输入。
本文将从消息结构开始,介绍 Prompt、Context 和 Chat Template 各自解决什么问题,以及它们如何共同组成模型真正接收的 Token 序列。
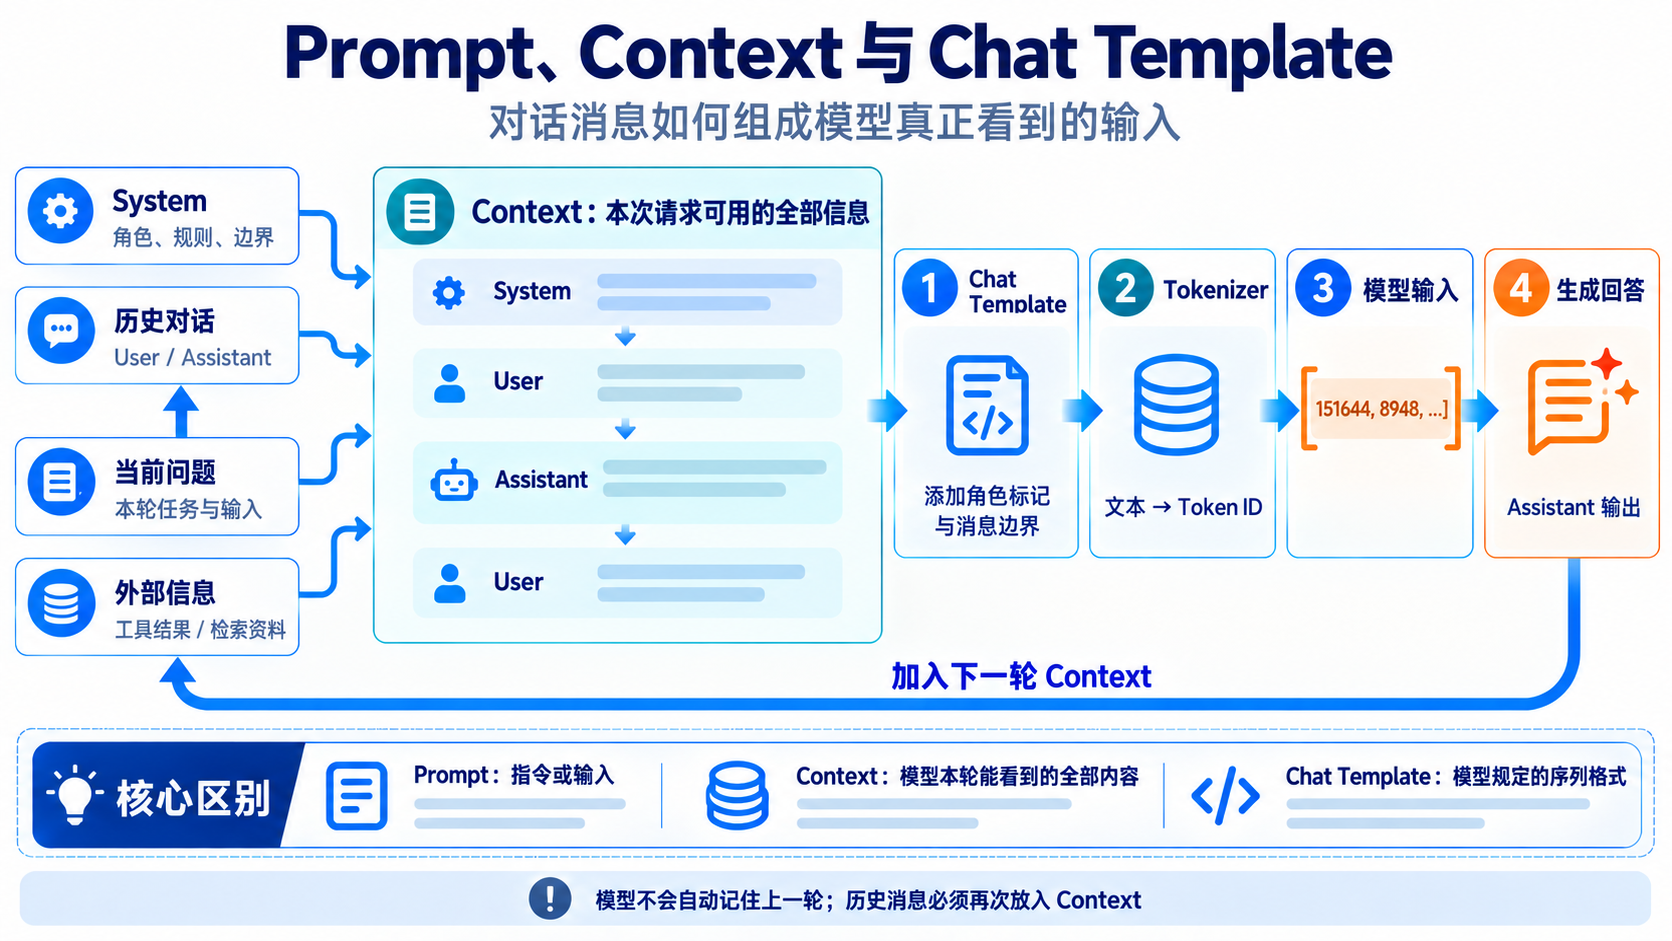
先理解三个核心概念
| 概念 | 核心含义 | 典型内容 |
|---|---|---|
| Prompt | 提供给模型的指令、问题或输入 | 当前问题、任务描述、Few-shot 示例 |
| Context | 模型在本次推理中能够利用的全部信息 | System、历史对话、当前问题、工具结果、检索资料 |
| Chat Template | 将结构化消息转换为模型约定序列的格式规则 | 角色标记、消息边界、生成起始标记 |
三者之间的关系可以概括为:
1 | Prompt 与其他信息 |
Prompt 到底是什么?
Prompt 通常翻译为“提示词”,但在不同语境中,它的范围并不完全一致。
狭义 Prompt
狭义 Prompt 指用户当前提供的指令或问题:
1 | 请用三个要点解释什么是大语言模型。 |
广义 Prompt
有些文档会把发送给模型的全部输入统称为 Prompt,包括:
- System 指令;
- 用户问题;
- 历史对话;
- Few-shot 示例;
- 检索到的文档;
- 工具说明;
- 输出格式要求。
因此,看到“Prompt 长度”“Prompt Token”或“Prompt Engineering”时,需要结合上下文判断这里的 Prompt 指当前用户输入,还是指模型的完整输入。
在本文中,为了便于区分:
- Prompt 主要表示任务指令或输入内容;
- Context 表示模型本次请求能够看到的全部内容。
Context:模型本轮能够看到的全部信息
Context 可以理解为模型本次推理的“临时工作区”。典型 Context 由以下部分组成:
1 | System Message |
这些内容经过 Chat Template 和 Tokenizer 处理后,共同占用模型的上下文窗口。
Context 不等于长期记忆
模型不会因为上一轮回答过某个问题,就自动永久记住那次对话。
无状态推理可以简化理解为:
1 | 第一轮请求:System + User 1 |
每一轮都需要重新提供模型需要参考的历史消息。
一些聊天产品或 API 看起来“记住”了对话,是因为应用或服务端替用户保存了历史,并在下一次调用时重新组装 Context;也可能使用摘要、数据库或其他外部记忆机制。模型本身只能利用当前请求实际提供给它的信息。
Context Window 是容量上限
Context Window(上下文窗口)表示模型一次推理能够处理的 Token 范围。通常需要同时容纳:
1 | 输入 Token + 新生成 Token |
但具体限制方式由模型和推理服务决定。有的服务分别限制最大输入和最大输出,有的服务限制二者总和。
上下文窗口越大,不代表模型就能同等有效地利用其中所有内容。过长 Context 可能带来:
- 更高的 Prefill 延迟;
- 更大的 KV Cache;
- 更高的调用费用;
- 更多无关信息和冲突信息;
- 重要内容被埋在大量文本中;
- 输入被截断的风险。
消息角色分别表示什么?
聊天接口通常使用 role 和 content 表示一条消息:
1 | { |
常见角色包括:
| 角色 | 典型作用 | 常见内容 |
|---|---|---|
| System | 提供整体行为要求和任务背景 | 身份、边界、风格、约束 |
| User | 表示用户指令或输入 | 问题、数据、修改意见 |
| Assistant | 表示模型此前的回答 | 对话历史、Few-shot 目标回答 |
| Tool | 表示工具执行结果 | 搜索结果、数据库记录、函数返回值 |
角色是否被支持、具体名称以及序列化方式取决于模型和 Chat Template。不能假设所有模型都原生支持完全相同的角色集合。
System Message
System Message 常用于描述:
- 模型扮演什么角色;
- 任务目标是什么;
- 回答风格和语言;
- 输出格式;
- 不允许执行的操作;
- 可使用的背景信息。
例如:
1 | { |
System Message 可以引导模型,但不是不可突破的程序级权限边界。模型如何响应冲突指令,与训练方式、模板、服务端规则和安全机制都有关系。
因此,真正的安全控制不能只依赖一句 System Prompt,还需要权限校验、工具白名单、参数验证、沙箱和人工确认等机制。
User Message
User Message 表示当前用户提供的问题、要求或数据。例如:
1 | { |
用户输入可能包含不可信内容。在 RAG、网页浏览或文件处理场景中,外部文档中的文字也不能自动被当成可信指令。
Assistant Message
Assistant Message 通常保存模型此前的回答:
1 | { |
多轮对话中,历史 Assistant Message 会再次进入 Context,使模型知道自己之前说过什么。
Assistant Message 也可用于 Few-shot 示例:人为提供理想回答,让模型模仿任务格式和风格。
Tool Message
支持工具调用的模型可能使用 Tool Message 表示外部程序的执行结果。例如:
1 | { |
完整工具调用通常还涉及工具名称、调用 ID、参数和模型生成的 Tool Call。具体数据结构因模型、模板和 API 而异。
工具结果属于 Context 中的数据,而不是天然可信的高优先级指令。应用应防范工具输出或外部网页中夹带的 Prompt Injection。
消息顺序为什么重要?
语言模型处理的是一个有顺序的 Token 序列。下面两个消息列表包含相同文字,但含义不同:
1 | User:我的名字是小明。 |
与:
1 | User:我叫什么名字? |
Chat Template 会按照消息列表中的顺序进行序列化。打乱顺序、遗漏消息或错误标注角色,都可能让模型得到不同的上下文。
不过,角色优先级不是由消息在列表中的位置单独保证的。模型是否遵循某种角色层级,取决于模型训练、模板设计和推理服务的控制机制。
Chat Template 解决了什么问题?
聊天模型本质上仍然是在继续一段 Token 序列。messages 这样的 Python 列表或 JSON 数组只是应用层结构,Transformer 并不能直接读取。
Chat Template 负责将结构化消息转换成模型训练时使用的文本格式。
例如,应用层消息:
1 | messages = [ |
可能被转换成类似 ChatML 的序列:
1 | <|im_start|>system |
其中包含:
- 角色起始标记;
- 消息内容;
- 消息结束标记;
- Assistant 回答的起始标记。
不同模型可能使用完全不同的格式。例如,有的模型使用 ChatML 风格,有的使用 [INST]...[/INST],还有的使用自己的 Header Token。
即使消息内容相同,使用错误模板也可能导致:
- 模型继续复述用户内容;
- System Message 失效;
- 角色混乱;
- 输出异常的特殊标记;
- 指令遵循能力下降;
- 工具调用格式错误。
Chat Template 必须尽量匹配模型训练或后训练时使用的格式。
Chat Template 本质上是什么?
在 Transformers 中,Chat Template 通常是一段保存在 Tokenizer 配置中的 Jinja 模板。
一个简化模板可能类似:
1 | {%- for message in messages %} |
它完成三件事:
- 遍历消息列表;
- 将角色、内容和消息边界按固定格式拼接;
- 必要时在末尾添加 Assistant 生成起始标记。
可以直接查看 Tokenizer 使用的模板:
1 | print(tokenizer.chat_template) |
复杂模型的模板可能还会处理:
- 工具定义;
- Tool Call 与 Tool Result;
- 检索文档;
- 多模态内容;
- 模型特有的推理字段;
- 当前日期等附加信息。
add_generation_prompt 有什么作用?
add_generation_prompt=True 会让模板在序列末尾添加“接下来由 Assistant 回答”的标记——前提是该模板定义了这种标记。
1 | without_prompt = tokenizer.apply_chat_template( |
对于 ChatML 风格,差异可能是末尾多出:
1 | <|im_start|>assistant |
如果模型需要生成起始标记却没有添加,它可能把最后一条 User Message 当作尚未结束的内容继续补全,而不是开始回答。
但并非所有模型都需要独立的 Assistant 起始标记,因此该参数的实际效果取决于具体模板。
continue_final_message 是什么?
通常情况下,我们希望模型在最后一条 User Message 后开始新的 Assistant Message。
另一种情况是:消息列表最后已经包含一个尚未写完的 Assistant Message,希望模型继续完成它。例如:
1 | messages = [ |
continue_final_message=True 会让模型续写最后一条消息,而不是创建新的 Assistant Message。这种方式有时称为 Prefill Response。
需要注意:
不要同时设置
add_generation_prompt=True和continue_final_message=True。
前者要求开始一条新消息,后者要求继续最后一条消息,语义互相冲突,Transformers 会拒绝这种组合。
为什么推荐让 Chat Template 直接 Token 化?
最安全的常见写法是:
1 | model_inputs = tokenizer.apply_chat_template( |
这样 Chat Template 可以直接返回:
input_ids;attention_mask;- 其他模型可能需要的字段。
如果先获得字符串,再单独调用 Tokenizer:
1 | formatted_text = tokenizer.apply_chat_template( |
通常应设置 add_special_tokens=False,因为 Chat Template 已经加入了它需要的特殊 Token。再次自动添加 BOS、EOS 等 Token,可能造成重复标记并影响模型表现。
Context 中还可能包含什么?
Few-shot 示例
可以在 Context 中放入几个输入与理想输出示例,让模型模仿任务:
1 | messages = [ |
模型不是在这次请求中更新参数,而是根据 Context 中展示的模式继续生成。
RAG 检索资料
RAG 应用会先检索与问题相关的文档,再把文档片段放入 Context:
1 | System 指令 |
模型只能依据实际放入 Context 的片段生成回答。资料没有被检索到、被截断或内容本身错误,都会影响最终结果。
工具定义
支持 Function Calling 的模型可能还需要在 Context 中接收工具名称、说明和参数 Schema。工具越多、Schema 越长,占用的输入 Token 也越多。
多轮对话如何管理 Context?
最直接的方法是保存全部历史:
1 | messages.append({"role": "user", "content": user_input}) |
但历史会越来越长,最终触及上下文窗口。常见策略包括:
| 策略 | 优点 | 风险 |
|---|---|---|
| 保留全部历史 | 信息最完整 | Token 持续增长 |
| 只保留最近 N 轮 | 简单、成本可控 | 较早信息丢失 |
| 摘要旧消息 | 节省 Token | 摘要可能遗漏细节 |
| 提取关键事实 | 适合用户偏好和状态 | 需要额外的数据结构 |
| 外部记忆检索 | 按需取回相关信息 | 检索可能不准确 |
无论使用哪种方式,最终都要把选中的信息重新放入本轮 Context。
Context 冲突时会发生什么?
Context 中可能出现互相矛盾的内容:
1 | System:使用简体中文回答。 |
模型最终如何响应取决于:
- 模型的后训练方式;
- Chat Template 对角色的表示;
- 推理服务施加的规则;
- 指令的清晰度与位置;
- 模型自身能力。
应用设计时不应只期待模型“自己判断正确优先级”。外部文档和工具结果应当与可信指令分离,并通过程序执行权限控制。
实战:观察 Qwen 的真实 Chat Template
下面继续使用本地模型:
1 | ./models/Qwen2.5-0.5B-Instruct |
程序将展示:
- Qwen 保存的 Chat Template;
- 单轮与多轮消息的格式化结果;
- System Message 和历史对话增加的 Token 数;
add_generation_prompt的影响;- Assistant Prefill;
- 完整的两轮对话生成过程。
示例代码:将下面代码保存为 qwen_chat_template_walkthrough.py:
1 | import torch |
如何阅读运行结果
System Message 会占用 Token
System Message 不是隐藏在模型参数之外的免费配置。经过 Chat Template 后,它会成为输入序列的一部分,占用上下文窗口并增加 Prefill 计算量。
一些托管服务可能还会加入用户看不到的服务端指令,因此客户端估算 Token 数时可能无法复现完整结果。
历史对话会被完整重新编码
第二轮请求中,程序重新发送:
1 | System |
如果不把第一轮消息加入 conversation,模型就无法从本次 Context 中知道之前发生了什么。
add_generation_prompt 改变末尾结构
比较两段格式化结果,可以看到添加生成提示后,序列末尾出现了模型所需的 Assistant 起始结构。
Assistant Prefill 不是新消息
continue_final_message=True 会继续最后一条 Assistant Message。它适合控制回答开头,但不能与 add_generation_prompt=True 一起使用。
按 Token 预算保留最近对话
下面的示例把历史记录组织成完整轮次,在不超过输入 Token 预算的情况下,从最近的对话开始保留:
1 | def count_chat_tokens(messages: list[dict[str, str]]) -> int: |
这个示例有意保留完整的 User/Assistant 轮次,避免简单删除单条消息后留下角色错位。
真实应用还需要考虑:
- 必须始终保留的安全指令;
- 当前用户问题的最大长度;
- 工具定义和检索文档占用的 Token;
- 给模型输出预留多少 Token;
- 旧对话是否需要摘要;
- 哪些用户事实应保存到外部记忆。
常见错误
错误一:把 Prompt 和 Context 当成完全相同的概念
广义用法中 Prompt 可以指完整输入,但在分析系统时,区分当前指令和全部 Context 更清晰。
错误二:认为模型会自动记住聊天历史
模型只能利用当前请求实际包含的消息。所谓“对话记忆”通常由应用保存、筛选和重新注入。
错误三:手动拼接 User: 和 Assistant: 就能适配所有模型
不同模型使用不同角色标记、消息边界和特殊 Token。应优先使用模型自带 Chat Template。
错误四:模板化后再次自动添加特殊 Token
Chat Template 通常已经包含所需特殊 Token。先格式化为字符串再 Tokenize 时,应根据模型文档设置 add_special_tokens=False,避免重复 BOS 或 EOS。
错误五:同时启用 add_generation_prompt 和 continue_final_message
一个表示开始新的 Assistant Message,另一个表示继续最后一条消息,两者语义冲突。
错误六:System Prompt 可以代替程序权限控制
System Prompt 只能引导模型行为,不能代替身份验证、授权、参数校验、沙箱和人工确认。
错误七:把检索文档或工具结果当成可信指令
外部内容可能错误、过时或包含 Prompt Injection。应将其作为数据处理,并限制其影响范围。
错误八:无限保留所有历史消息
历史越长,Token、延迟和成本越高,也可能引入噪声。需要根据任务设计裁剪、摘要或外部记忆策略。
小结
Prompt、Context 和 Chat Template 的关系可以总结为:
- Prompt 是提供给模型的指令、问题或输入,但有时也被广义地用于表示全部输入;
- Context 是模型本次推理能够看到的全部内容;
- System、历史对话、当前问题、检索资料和工具结果都可能进入 Context;
- 模型不会自动保留上一轮对话,应用需要重新发送所需历史;
- Chat Template 把结构化消息转换为模型训练时使用的序列格式;
add_generation_prompt通常用于开始新的 Assistant 回答;continue_final_message用于续写最后一条消息,两者不能同时使用;- Chat Template 与 Tokenizer 共同决定模型最终接收的 Token ID;
- 所有进入 Context 的内容都会占用 Token 预算,并影响延迟、内存和费用;
- System Prompt 不是程序级安全边界,外部内容也不是天然可信指令。
理解模型到底看到了什么之后,下一步就可以学习如何组织更清晰、稳定且可验证的 Prompt。