Token 与 Tokenizer:文字如何变成模型能够计算的数字?
在上一篇文章中,我们完整走读了一次 LLM 请求:消息经过 Chat Template 和 Tokenizer 转换为 Token ID,再由模型执行 Prefill 和 Decode,逐步生成回答。
其中,Tokenizer 位于自然语言与神经网络之间:
人类输入文字,模型处理数字,而 Tokenizer 负责在两者之间进行转换。
Tokenizer 看似只是一个文本切分工具,实际上它会直接影响:
- 模型如何观察文字;
- 一段文本占用多少上下文;
- API 按 Token 计费时的用量;
- 文本是否会被截断;
- 模型与输入格式是否兼容;
- 多语言、代码和特殊字符的处理效率。
本文将从 Token、Vocabulary 和 Token ID 开始,逐步介绍 Tokenizer 的编码流程、常见子词算法、特殊 Token、Padding、Truncation 和 Chat Template,并通过本地 Qwen Tokenizer 查看真实的切分结果。
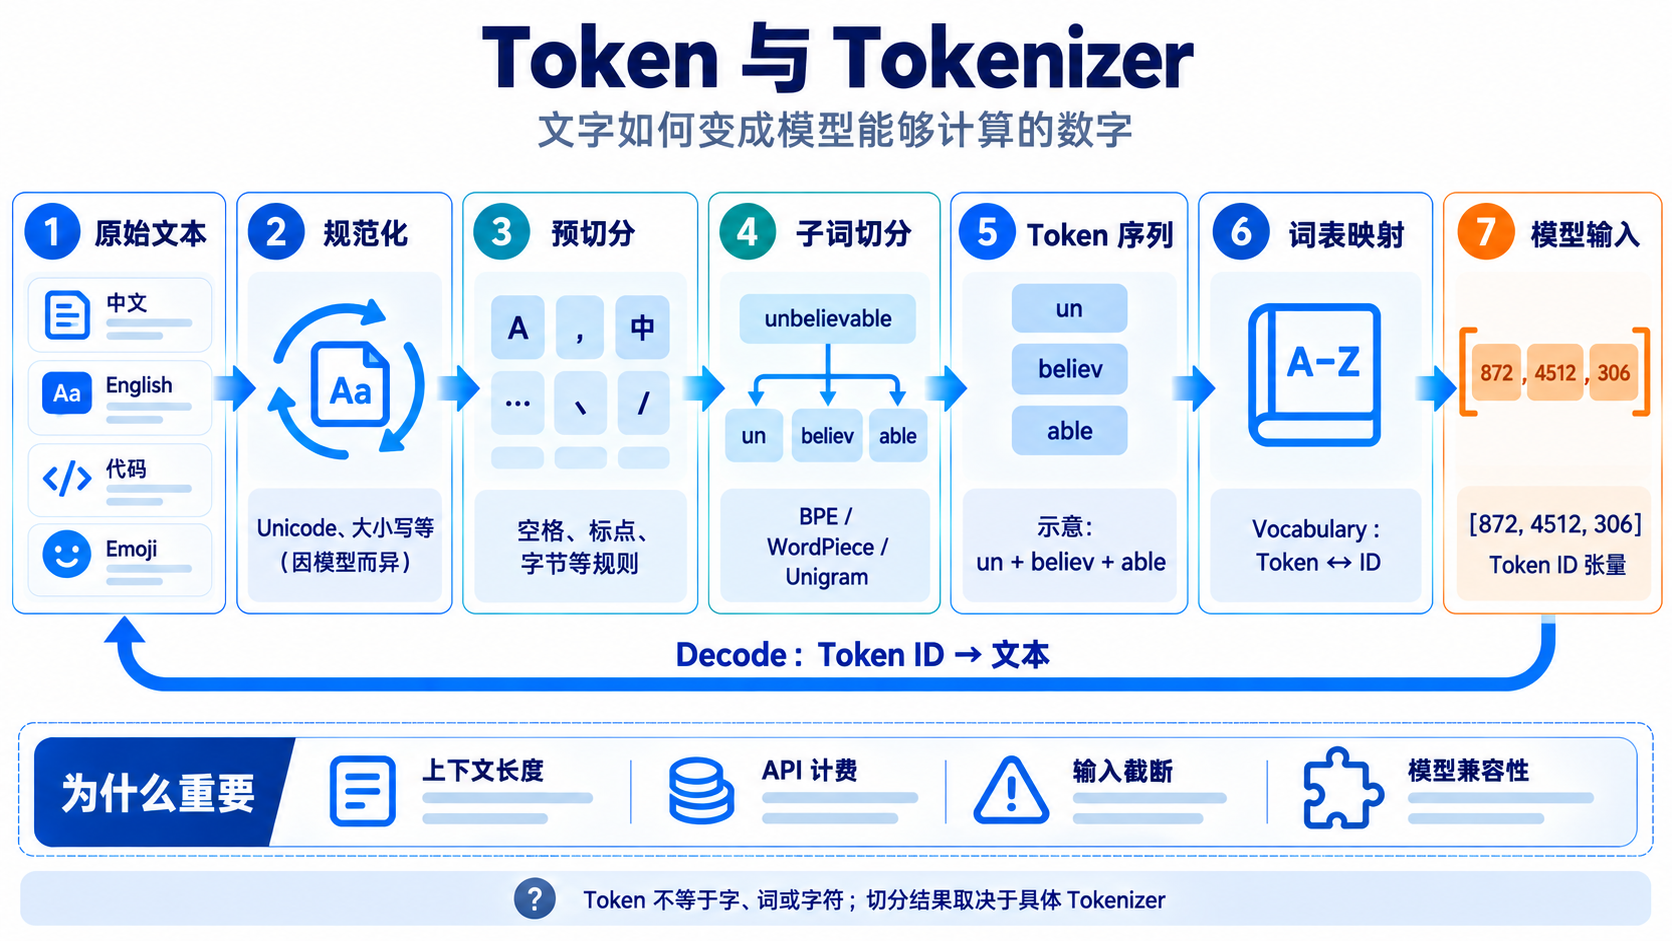
Token 是什么?
Token 是模型处理序列时使用的基本离散单元,也可以翻译为“词元”。
Token 不一定是一个完整单词,也不一定是一个汉字。根据具体 Tokenizer 和输入文本,一个 Token 可能是:
- 一个完整单词;
- 一个子词;
- 一个汉字或多个汉字;
- 标点符号;
- 空格与单词的组合;
- 一个或多个字节;
- 控制消息结构的特殊标记。
例如,下面只是用于理解概念的示意,并不是所有模型的真实切分结果:
| 原始文本 | 可能的 Token 切分示意 |
|---|---|
hello |
hello |
unbelievable |
un、believ、able |
人工智能 |
人工、智能 |
print("你好") |
print、(、"、你好、"、) |
😊 |
一个 Token,或者多个字节相关 Token |
同一段文字交给不同 Tokenizer,得到的切分结果和 Token 数量可能完全不同。因此不能脱离具体模型说“一句话固定等于多少个 Token”。
为什么不直接按字或单词切分?
如果把每个完整单词都作为 Token,会遇到几个问题:
- 自然语言中的单词数量非常庞大;
- 新词、人名、拼写变化和专业术语不断出现;
- 中文等语言并不依靠空格分隔所有词语;
- 代码、URL、Emoji 和混合语言很难用统一的“单词”定义处理;
- 词表过大会增大 Embedding 和输出层的参数量。
如果完全按字符或字节切分,虽然几乎可以覆盖所有输入,但序列会变得很长,增加上下文占用和推理成本。
子词 Tokenization 在两者之间折中:
1 | 常见内容 → 尽量使用较长 Token |
这样既能控制词表大小,又能表示训练时没有完整出现过的新词。
Token、Vocabulary 与 Token ID
理解 Tokenizer,需要区分三个概念:
| 概念 | 含义 | 示例 |
|---|---|---|
| Token | 文本被切分后的离散单元 | hello、ing、。 |
| Vocabulary | Tokenizer 可以使用的 Token 集合 | 模型对应的完整词表 |
| Token ID | Token 在词表中的整数编号 | hello → 15339(仅为示意) |
Tokenizer 会维护 Token 与 Token ID 的映射关系:
1 | Token Token ID |
需要注意:Token ID 没有跨模型的统一含义。
在一个 Tokenizer 中,ID 1000 可能表示某个英文子词;在另一个 Tokenizer 中,它可能表示汉字、标点或特殊 Token。模型的 Embedding 矩阵按照自己的词表顺序训练,因此不能随意把一个 Tokenizer 生成的 ID 交给另一个模型。
模型权重与 Tokenizer 是配套的。更换 Tokenizer 不只是更换文本预处理方式,还会改变每个 ID 所代表的内容。
Tokenizer 的完整编码流程
一个 Tokenizer 的实现可以包含多个组件。典型流程如下:
1 | 原始文本 |
不同模型会采用不同组件和规则,并不是每个 Tokenizer 都会执行完全相同的步骤。
1. Normalization:文本规范化
Normalization 会按照既定规则对输入文本进行规范化,例如:
- Unicode 规范化;
- 大小写转换;
- 重音符号处理;
- 空白字符处理;
- 模型定义的字符替换。
例如,某些 Tokenizer 可能把:
1 | HELLO → hello |
但大小写是否保留取决于具体 Tokenizer。现代生成模型通常需要严格使用模型原有的规范化规则,不能在应用层想当然地先把文本全部转为小写或删除标点。
规范化还可能是有损的。如果两个不同输入经过规范化后变成相同形式,解码时就不一定能够恢复最初的原始文本。
2. Pre-Tokenization:预切分
预切分根据空格、标点、数字、字节等规则,把文本拆成较小的候选片段。
例如,一个简单的空格与标点预切分器可能把:
1 | Hello, world! |
拆成:
1 | Hello | , | world | ! |
有些 Byte-Level Tokenizer 会先把文本映射到字节表示,因此可以覆盖任意 Unicode 输入,但内部 Token 字符串可能不再适合直接阅读。
预切分只是中间步骤,最终 Token 还要由后续子词模型决定。
3. Subword Model:子词切分
子词模型根据训练好的词表或统计规则决定最终如何切分片段。常见方法包括 BPE、WordPiece 和 Unigram。
4. Post-Processing:添加结构信息
后处理可以在序列中添加模型需要的特殊 Token,例如:
1 | [CLS] sentence [SEP] |
对于聊天模型,System、User、Assistant 等消息结构通常由 Chat Template 组织。Chat Template 可能插入角色边界和消息结束 Token,因此要避免随后再次错误添加重复的特殊 Token。
常见子词算法
BPE:Byte Pair Encoding
BPE 的基本思想是:从较小的基础单元开始,反复合并语料中高频出现的相邻单元。
假设训练语料经过初始拆分后包含:
1 | l o w |
如果 l + o 经常一起出现,就可以学习合并为 lo;随后 lo + w 又可能合并为 low。
最终效果是:
- 高频词或片段更可能形成较长 Token;
- 低频词可以拆成多个较小 Token;
- 词表大小可以控制在指定范围内。
实际模型可能使用字符级 BPE、Byte-Level BPE 或其他变体,不能仅凭“使用 BPE”推断所有预处理细节。
WordPiece
WordPiece 同样使用子词词表,但其训练目标与 BPE 的简单高频相邻合并并不相同。编码时通常使用从当前位置开始、词表中能够匹配的较长子词。
在一些 WordPiece 词表中,## 表示 Token 是一个单词的后续部分。例如:
1 | playing → play + ##ing |
## 是特定实现中的内部标记,不是原始文本的一部分。
Unigram
Unigram 从一个较大的候选子词集合开始,为每个子词建立概率模型,再逐步移除影响较小的候选。
同一段文本可能存在多种切分方式,Unigram 会根据训练得到的概率选择整体上更合适的 Token 序列。
SentencePiece 是什么?
SentencePiece 是一个 Tokenization 工具与训练框架,而不是与 BPE、Unigram 完全同层级的单一算法。它可以训练 BPE 或 Unigram 模型,并且通常可以直接在原始 Unicode 文本上工作。
部分 SentencePiece Tokenizer 使用类似 ▁ 的符号表示空格或词边界。这是内部表示,Decoder 会在解码时将其恢复为正常文本。
| 名称 | 核心特点 | 常见内部表现 |
|---|---|---|
| BPE | 逐步合并高频相邻单元 | 高频片段形成较长 Token |
| WordPiece | 基于词表与目标函数建立子词 | 某些实现使用 ## 标记续接子词 |
| Unigram | 从多个候选切分中选择高概率组合 | 基于子词概率模型 |
| SentencePiece | Tokenizer 训练与执行框架 | 可支持 BPE、Unigram 等模型 |
Encode:从文本到 Token ID
编码过程通常包含两步:
1 | 文本 → Token 序列 → Token ID 序列 |
在 Transformers 中,可以使用:
1 | token_ids = tokenizer.encode( |
也可以直接调用 Tokenizer,获得更完整的输出:
1 | encoding = tokenizer( |
encode() 适合只需要 ID 列表的场景;直接调用 Tokenizer 则可以同时获得 Attention Mask、Offset Mapping 等信息。
Decode:从 Token ID 回到文本
解码是编码的反向过程:
1 | text = tokenizer.decode( |
其中:
skip_special_tokens=True:不在结果中显示特殊 Token;clean_up_tokenization_spaces=False:尽量避免额外调整空格。
需要注意,Encode 与 Decode 不一定永远严格还原为逐字符完全相同的原始输入,原因可能包括:
- Tokenizer 执行了有损规范化;
- 解码时跳过了特殊 Token;
- Decoder 进行了空格清理;
- 输入中包含不同但规范化后等价的 Unicode 表示。
对于多数现代生成模型的普通文本,整体编码后再整体解码通常可以得到预期内容。但逐个 Token 分别解码再拼接,不一定等价于对整个 Token 序列统一解码,特别是使用字节级编码时。
特殊 Token
特殊 Token 不一定对应用户可见的普通文字,而是用于表示结构、控制边界或填充位置。
| 特殊 Token | 常见作用 | 是否所有模型都有 |
|---|---|---|
| BOS | 表示序列开始 | 否 |
| EOS | 表示序列结束 | 否,但生成模型中很常见 |
| PAD | 将批次中的序列补齐到相同长度 | 否,有些模型会复用其他 Token |
| UNK | 表示词表无法覆盖的内容 | 否,字节级方案可能不需要 |
| MASK | 掩码语言模型的训练标记 | 否,自回归模型通常不依赖它 |
| 角色 Token | 表示 System、User、Assistant 等消息边界 | 取决于聊天模板 |
可以通过下面的代码查看具体 Tokenizer 的特殊 Token:
1 | print(tokenizer.special_tokens_map) |
不要根据 Token 的名称猜测用途,应以模型配置、Tokenizer 配置和 Chat Template 为准。
Chat Template 为什么会增加 Token 数?
用户看到的可能只有一句话:
1 | 请介绍一下你自己。 |
但聊天模型实际接收的内容还可能包含:
- System Message;
- User 角色起始标记;
- 消息结束标记;
- Assistant 角色起始标记;
- 历史对话中的全部角色和内容。
因此,下面两个结果通常不同:
1 | raw_ids = tokenizer.encode( |
在估算上下文长度或 API 使用量时,应统计实际发送给模型的完整序列,而不是只统计用户可见的问题文本。
Padding 与 Truncation
Padding:补齐批次长度
批量推理时,不同文本包含的 Token 数可能不同。为了组成形状规则的张量,通常需要把较短序列补齐:
1 | 序列 A: [11, 25, 90, 36] |
Attention Mask 用来标识有效 Token 与 Padding:
1 | 序列 A: [1, 1, 1, 1] |
Padding 在左侧还是右侧取决于 Tokenizer 配置和任务要求。对生成模型进行批量推理时,Padding Side 可能影响结果,应该遵循模型文档和推理框架的要求。
Truncation:截断过长输入
当输入超过指定长度时,可以启用截断:
1 | encoding = tokenizer( |
截断不是无损操作。被删除的 Token 不会被模型看到,而且不一定总是从读者认为“不重要”的位置删除。
因此,真实应用需要明确:
- 最大允许输入长度;
- 输入和输出如何共享上下文预算;
- 从左侧还是右侧截断;
- System Prompt、用户问题和检索资料谁应该优先保留。
Token 数为什么重要?
1. 决定上下文占用
模型限制的是 Token 数量,不是字符数或字数。一篇字符数相同的中文、英文或代码文本,Token 数可能不同。
2. 影响推理延迟
输入 Token 越多,Prefill 需要处理的内容越多;输出 Token 越多,Decode 循环次数越多。
3. 影响内存占用
在自回归生成中,KV Cache 通常会随已缓存 Token 数增长。长上下文可能显著增加显存或内存占用。
4. 影响 API 费用
许多模型服务按照输入 Token 和输出 Token 分别计费。具体计费规则和 Tokenizer 由服务提供方决定,应以对应模型的最新文档为准。
5. 影响多语言效率
如果某种语言在 Tokenizer 的训练语料中覆盖不足,常见文字可能被切成更多、更小的 Token,导致相同信息需要更长的序列。
实战:走读 Qwen Tokenizer
下面继续使用前两篇文章中的本地模型目录:
1 | ./models/Qwen2.5-0.5B-Instruct |
本章只加载 Tokenizer,不加载模型权重,因此运行速度更快,也不需要 GPU。
示例代码:将下面代码保存为 qwen_tokenizer_walkthrough.py:
1 | from transformers import AutoTokenizer |
执行结果
1 | /Users/jean/.pyenv/shims/uv run /Users/jean/PycharmProjects/llm-base/.venv/bin/python /Users/jean/PycharmProjects/llm-base/qwen_tokenizer_walkthrough.py |
如何阅读输出
convert_ids_to_tokens() 与 decode() 不同
convert_ids_to_tokens() 返回 Tokenizer 的内部 Token 字符串。对于 Byte-Level Tokenizer,结果可能包含看起来奇怪的字符。
decode() 会经过对应 Decoder,把 Token ID 序列恢复为人类可读文本。因此,判断最终输出时应该观察完整序列的 decode() 结果,而不是把内部 Token 字符串直接拼接起来。
Offset Mapping
Fast Tokenizer 可以返回每个 Token 对应原始文本中的字符区间:
1 | offset=(start, end) |
这对于以下任务很有用:
- 命名实体识别;
- 文本高亮;
- 将模型预测位置映射回原文;
- 检查 Token 切分边界。
特殊 Token 的 Offset 可能是 (0, 0),因为它们不是直接来自原始文本。
为什么单个 Token 解码可能出现异常字符?
如果一个 Unicode 字符的 UTF-8 字节被分布在多个 Token 中,单独解码其中一个 Token 可能出现替代字符或空内容;把相关 Token 放在一起整体解码后,才能恢复正确文字。
这也是为什么流式输出实现不能总是假设“生成一个 Token 就一定得到一个完整可显示字符”。
如何统计真实请求的 Token 数?
对于普通文本,可以直接统计:
1 | def count_text_tokens(text: str) -> int: |
对于聊天请求,应应用相同的 Chat Template:
1 | def count_chat_tokens(messages: list[dict[str, str]]) -> int: |
这种方式可以统计发送到本地模型的输入序列。对于远程 API,服务端可能使用不同版本的 Tokenizer、隐藏的系统消息或额外工具定义,因此客户端估算结果可能与最终账单存在差异,应以服务端返回的 Usage 数据为准。
常见误区
误区一:一个汉字等于一个 Token
有些常见汉字可能单独成为 Token,有些词语可能合并为一个 Token,少见字符也可能被拆成多个字节相关 Token。只有实际运行对应 Tokenizer 才能确定。
误区二:一个英文单词等于一个 Token
常见单词可能是一个 Token,少见单词、复合词和词形变化可能被拆成多个子词。单词前的空格也可能属于 Token 表示的一部分。
误区三:Tokenizer 在理解文本语义
Tokenizer 主要按照词表和算法规则编码文本。语境相关的表示和复杂模式计算发生在后续神经网络中。
误区四:不同模型可以共用 Token ID
Token ID 只在对应词表中有意义。即使两个模型都采用 BPE,也不代表它们具有相同词表、合并规则或特殊 Token。
误区五:Token 越长越好
较长 Token 可以缩短序列,但需要更大的词表,也可能降低对新词的组合能力。Tokenizer 设计是在词表大小、序列长度、多语言覆盖和模型能力之间进行权衡。
误区六:Decode 一定逐字符还原原文
规范化、特殊 Token 跳过和空格清理都可能改变结果。需要严格保留原文的系统不应只依赖“编码后再解码”保存文本。
误区七:字符数量可以代替 Token 数量
不同语言、代码、数字、空格和特殊符号的切分效率不同。字符数量只能用于非常粗略的估计,不能替代真实 Tokenizer 统计。
小结
Token 与 Tokenizer 的核心关系可以概括为:
- Token 是模型处理序列时使用的离散单元,不固定等于字、词或字符;
- Tokenizer 按照自己的规范化、预切分和子词规则生成 Token;
- Vocabulary 保存 Token 集合以及 Token 与 ID 的映射关系;
- Token ID 只对配套模型有意义,不能在不同模型之间随意复用;
- Encode 把文本转换为 Token ID,Decode 把 Token ID 序列恢复为文本;
- 特殊 Token 用于表示序列、消息角色、Padding 等结构;
- Token 数会影响上下文、推理延迟、内存占用、截断和 API 费用;
- 统计聊天请求时,需要计算 Chat Template 处理后的完整序列。
理解 Tokenizer 后,我们就能进一步回答一个重要问题:System、User、Assistant 和历史消息是如何共同组成模型上下文的。下一篇将继续介绍 Prompt、Context 与 Chat Template。