从 Prompt 到回答:一次 LLM 请求经历了什么?
在上一篇文章中,我们已经知道:大语言模型会根据已有上下文不断预测下一个 Token。
但当我们在聊天框中输入一句话,或者调用一次模型 API 时,这句话并不会直接进入 Transformer,模型也不会一次性在内部“写出”整段回答。
一次典型的 LLM 请求,需要依次经历:
消息输入 → 聊天模板 → Token 化 → Prefill → Logits → 解码策略 → Decode 循环 → 停止与文本输出
本文将沿着这条链路,完整走读一次请求从自然语言输入到模型回答的过程,并使用 Qwen/Qwen2.5-0.5B-Instruct 编写一个可以本地执行的示例。
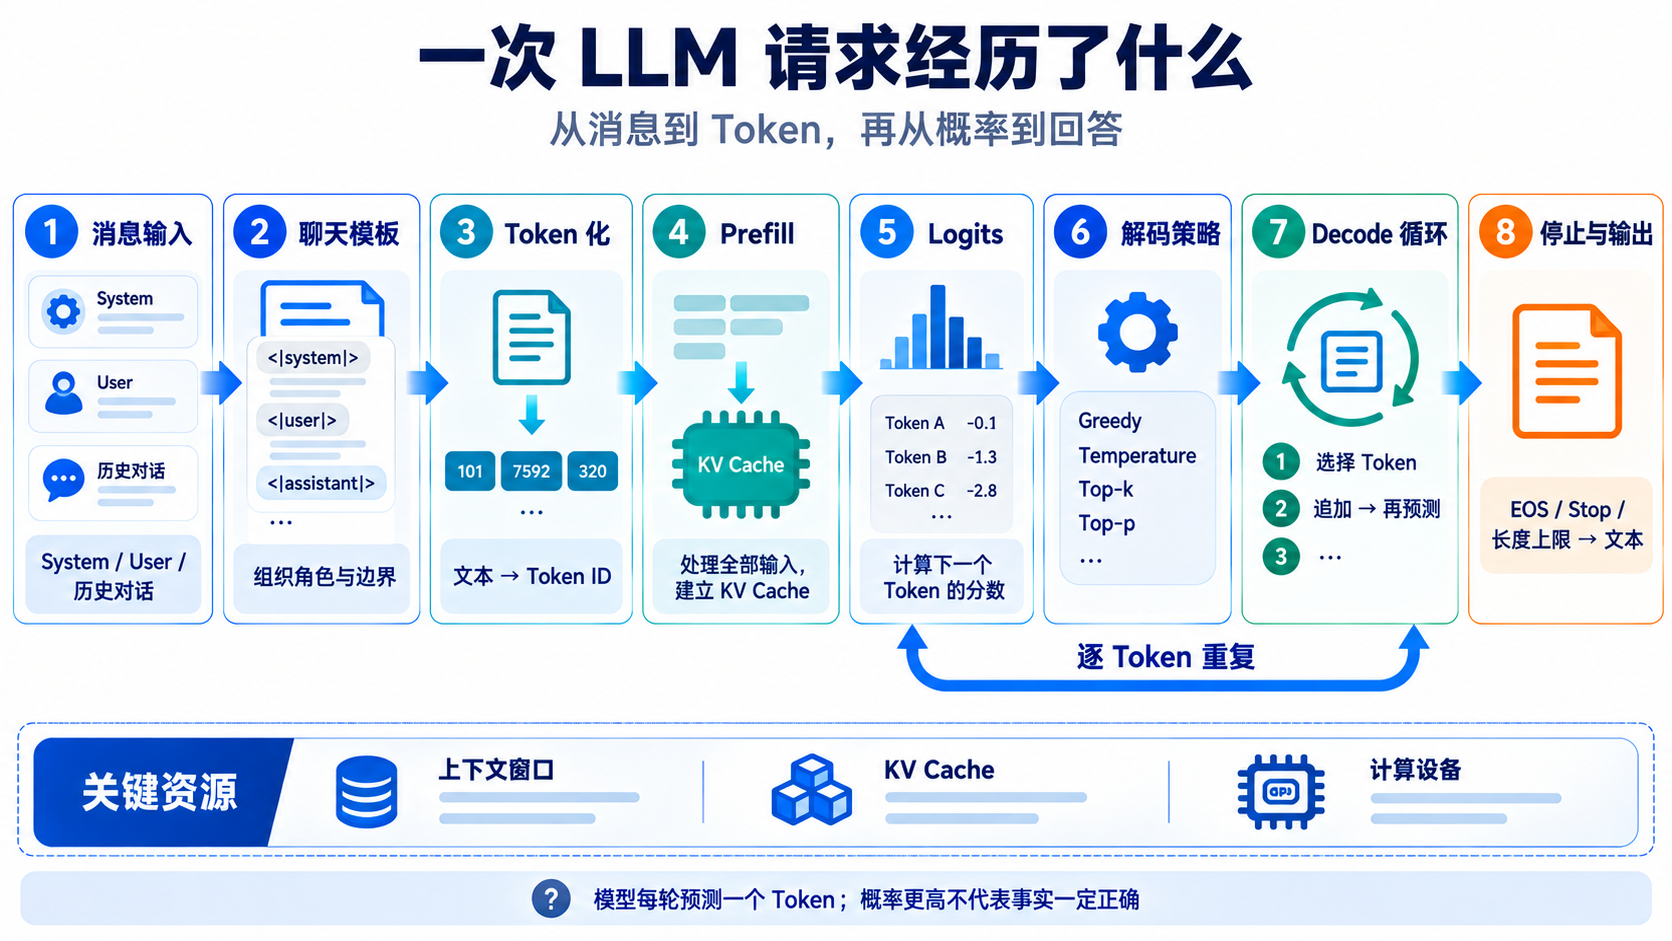
从两个层次理解一次 LLM 请求
“LLM 请求”通常包含两个不同层次:
- 应用层请求:客户端将消息、生成参数等内容发送给本地程序或远程推理服务;
- 模型推理过程:推理服务把消息转换成 Token,调用模型计算,并逐个生成输出 Token。
以常见的聊天接口为例,应用层提交的内容可能类似:
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
| {
"model": "Qwen/Qwen2.5-0.5B-Instruct",
"messages": [
{
"role": "system",
"content": "你是一名耐心的人工智能老师。"
},
{
"role": "user",
"content": "请用一句话解释什么是 Token。"
}
],
"temperature": 0.7,
"max_tokens": 128
}
|
这些字段本身不是 Transformer 可以直接处理的输入。推理服务还需要完成消息模板化、Token 化、张量构造、模型计算和结果解码。
| 层次 |
处理内容 |
常见工作 |
| 客户端 |
用户问题与调用参数 |
构造请求、身份验证、发送请求、接收流式结果 |
| 推理服务 |
请求调度与预处理 |
校验参数、选择模型、批处理、应用聊天模板 |
| Tokenizer |
文本与 Token ID 转换 |
编码输入、插入特殊 Token、解码输出 |
| 模型 |
数值张量 |
Prefill、计算隐藏状态、输出 Logits |
| 解码器 |
Logits 与生成参数 |
Greedy、Sampling、Top-k、Top-p、停止判断 |
下面重点介绍推理服务接收到消息之后,模型内部发生的过程。
第一步:接收消息与生成参数
一次对话请求通常不只有当前问题,还可能包括:
- System Message:规定模型角色、行为边界和输出要求;
- 历史对话:此前的 User 与 Assistant 消息;
- 当前问题:用户本轮输入;
- Tool Message:工具调用返回的结果;
- 生成参数:最大输出长度、Temperature、Top-k、Top-p 等。
例如:
1
2
3
4
5
6
7
8
9
10
| messages = [
{
"role": "system",
"content": "你是一名耐心的人工智能老师。",
},
{
"role": "user",
"content": "请用一句话解释什么是 Token。",
},
]
|
这里的 role 和 content 是应用层的数据结构。模型本身接收的是 Token ID 张量,并不会直接读取 Python 字典或 JSON。
第二步:Chat Template 将消息组织成模型格式
不同聊天模型使用的消息格式可能不同。Chat Template(聊天模板)负责把结构化消息转换成模型训练时熟悉的文本序列。
以 ChatML 风格为例,转换结果可能类似:
1
2
3
4
5
| <|im_start|>system
你是一名耐心的人工智能老师。<|im_end|>
<|im_start|>user
请用一句话解释什么是 Token。<|im_end|>
<|im_start|>assistant
|
最后的 Assistant 起始标记非常重要,它相当于告诉模型:
前面的消息已经结束,接下来应该继续生成 Assistant 的回答。
在 Transformers 中,可以通过以下代码查看格式化结果:
1
2
3
4
5
6
7
| formatted_prompt = tokenizer.apply_chat_template(
messages,
tokenize=False,
add_generation_prompt=True,
)
print(formatted_prompt)
|
其中:
tokenize=False:先返回格式化后的文本,方便观察;add_generation_prompt=True:在末尾添加开始生成 Assistant 消息所需的标记。
需要注意:不是所有模型都使用相同的角色标记,也不是所有模板都会因为 add_generation_prompt=True 而添加相同内容。因此,不应该手动假设某个模型一定使用 <|im_start|>。
第三步:Tokenizer 将文本转换为 Token ID
Transformer 不能直接处理文字,需要先由 Tokenizer 将文本编码成一串整数:
1
2
3
| 文本
↓ Tokenizer
[151644, 8948, 198, 56568, ..., 151645, 198, 151644, 77091, 198]
|
这里的每一个整数都是词表中某个 Token 的编号。
Tokenizer 还会返回 attention_mask:
| 字段 |
作用 |
input_ids |
输入 Token 对应的整数编号 |
attention_mask |
标识哪些位置是有效输入、哪些位置是 Padding |
推荐直接让 Chat Template 完成 Token 化:
1
2
3
4
5
6
7
| model_inputs = tokenizer.apply_chat_template(
messages,
tokenize=True,
add_generation_prompt=True,
return_dict=True,
return_tensors="pt",
)
|
这样可以避免格式化文本中已经包含特殊 Token,后续再次 Token 化时又重复添加特殊 Token。
此时,input_ids 的形状通常是:
1
| [batch_size, sequence_length]
|
如果当前只有一条请求,并且模板化后的输入包含 35 个 Token,那么形状就是:
第四步:Embedding 与位置信息
Token ID 只是词表编号,不能直接表达语义。模型首先通过 Embedding 层把每个 Token ID 映射为高维向量。
1
2
3
| Token ID: 8948
↓ Embedding
[0.12, -0.08, 0.31, ..., 0.04]
|
模型还需要知道每个 Token 在序列中的位置。现代 LLM 通常会使用 RoPE 等位置机制,将位置信息引入注意力计算。
经过这一步,模型处理的已经不再是文字或整数编号,而是多维数值张量。
第五步:Prefill 处理全部输入
Prefill(预填充)阶段会一次处理输入上下文中的全部 Token。
假设输入长度为 35 个 Token,模型会对这 35 个位置进行 Transformer 计算,得到每个位置的隐藏状态,并根据最后一个位置的隐藏状态计算第一个待生成 Token 的 Logits。
Prefill 同时会建立 KV Cache,缓存每一层注意力中已经计算出的 Key 和 Value。
1
2
3
4
5
| 35 个输入 Token
↓
Transformer 多层计算
├── 最后位置的隐藏状态 → Logits
└── 历史 Key / Value → KV Cache
|
需要区分:
- Prefill 可以并行处理输入中的多个 Token;
- 后续 Decode 具有自回归依赖,通常需要逐个生成 Token。
输入越长,Prefill 需要处理的 Token 越多,首个输出 Token 出现前的等待时间通常也越长。这段时间常用 TTFT(Time To First Token,首 Token 延迟)衡量。
第六步:模型输出 Logits
模型最后一层的隐藏状态会经过 Language Model Head,映射成与词表大小相同的一组分数。
假设模型词表有 151,936 个 Token,那么每次预测都会产生 151,936 个 Logits:
1
2
3
| 隐藏状态
↓ Language Model Head
[2.31, -0.82, 1.47, ..., 0.36]
|
Logits 是未经归一化的原始分数,不是概率。对 Logits 应用 Softmax 后,才能得到总和为 1 的概率分布:
1
| P(token_i) = softmax(logits)_i
|
例如:
| 候选 Token |
Logit |
概率示意 |
| “Token” |
4.8 |
52% |
| “词元” |
4.1 |
26% |
| “模型” |
3.2 |
11% |
这些数字只用于说明概念。真实结果会受到完整上下文、模型参数以及生成配置的影响。
还要再次强调:某个 Token 的生成概率更高,只代表它更符合模型学到的语言分布,不代表它表达的事实一定正确。
第七步:解码策略选择下一个 Token
模型产生概率分布之后,还要由解码策略决定实际输出哪个 Token。
| 解码方法 |
工作方式 |
结果特点 |
| Greedy |
始终选择分数最高的 Token |
确定性强,但可能缺乏多样性 |
| Sampling |
按概率随机选择 Token |
结果更加多样 |
| Temperature |
调整概率分布的集中程度 |
越高通常越随机 |
| Top-k |
只在概率最高的 k 个候选中采样 |
限制候选数量 |
| Top-p |
在累计概率达到 p 的候选集合中采样 |
候选规模随分布变化 |
如果使用 Greedy Decoding,可以直接选择 Logits 最大的位置:
1
| next_token_id = torch.argmax(next_token_logits, dim=-1, keepdim=True)
|
如果启用采样,则通常还需要进行 Temperature 缩放、Top-k 或 Top-p 过滤,然后从处理后的概率分布中抽样。
第八步:Decode 循环与 KV Cache
选择出第一个输出 Token 后,生成还没有结束。这个 Token 会被追加到已有序列中,模型继续预测下一个 Token:
1
2
3
4
5
6
7
8
9
10
11
| 已有上下文
↓
预测 Token A
↓ 追加
已有上下文 + Token A
↓
预测 Token B
↓ 追加
已有上下文 + Token A + Token B
↓
继续循环
|
如果没有 KV Cache,模型每生成一个新 Token,都需要重新计算整个历史序列。KV Cache 保存了历史 Token 在各注意力层中的 Key 和 Value,使后续步骤可以复用这些结果。
典型 Decode 步骤如下:
- 输入上一轮选出的新 Token;
- 读取历史 KV Cache;
- 计算新 Token 对应的 Query、Key 和 Value;
- 将新的 Key、Value 追加到缓存;
- 得到下一 Token 的 Logits;
- 使用解码策略选择 Token;
- 重复以上过程。
KV Cache 减少了重复计算,但会随着上下文增长占用更多内存。因此,长上下文不仅受到上下文窗口限制,也会带来更高的显存或内存消耗。
第九步:判断是否停止生成
生成循环不会无限进行。常见停止条件包括:
| 停止条件 |
说明 |
| EOS Token |
模型生成了序列结束标记 |
| Stop Sequence |
输出命中了应用配置的停止字符串或 Token 序列 |
max_new_tokens |
达到允许新增的最大 Token 数 |
| 自定义规则 |
业务代码定义的停止条件 |
需要注意,max_new_tokens 限制的是新生成 Token 的数量,不包含原始输入长度。
生成结束后,Tokenizer 会把输出 Token ID 解码为文本:
1
2
3
| [104165, 100158, 1773, ...]
↓ tokenizer.decode()
“Token 是模型处理文本时使用的基本单位。”
|
如果接口启用了流式输出,服务端通常会在生成过程中逐步将新内容发送给客户端,而不是等待完整回答生成后一次性返回。
完整流程总结
| 阶段 |
输入 |
输出 |
核心作用 |
| 消息输入 |
System、User、历史消息 |
消息列表 |
提供任务和上下文 |
| Chat Template |
消息列表 |
格式化序列 |
添加角色和消息边界 |
| Tokenizer |
格式化序列 |
Token ID、Attention Mask |
转换为模型输入 |
| Embedding |
Token ID |
高维向量 |
提供数值表示 |
| Prefill |
全部输入向量 |
首次 Logits、KV Cache |
理解输入并建立缓存 |
| 解码策略 |
Logits |
下一个 Token |
决定本轮实际输出 |
| Decode |
新 Token、KV Cache |
新 Logits、更新后的缓存 |
逐 Token 生成 |
| 停止与解码 |
生成 Token 序列 |
文本回答 |
结束生成并返回结果 |
实战:完整走读一次本地推理
下面继续使用上一篇文章下载的 Qwen/Qwen2.5-0.5B-Instruct。示例会展示:
- Chat Template 转换结果;
- 输入 Token 与 Token ID;
- Prefill 输出的张量形状;
- 第一个待生成位置的 Top-5 候选;
- 使用 KV Cache 手动执行 Greedy Decode;
- EOS 与最大长度停止条件;
- 最终文本解码。
将下面代码保存为 qwen_inference_walkthrough.py:
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
62
63
64
65
66
67
68
69
70
71
72
73
74
75
76
77
78
79
80
81
82
83
84
85
86
87
88
89
90
91
92
93
94
95
96
97
98
99
100
101
102
103
104
105
106
107
108
109
110
111
112
113
114
115
116
117
118
119
120
121
122
123
124
125
126
127
128
129
130
131
132
133
134
135
136
137
138
139
140
141
142
143
144
145
146
147
148
149
150
151
152
153
154
155
156
157
158
159
160
161
162
163
164
165
166
167
168
169
170
171
172
173
174
175
176
177
178
179
180
181
182
183
184
| import torch
from transformers import AutoModelForCausalLM, AutoTokenizer
MODEL_PATH = "./models/Qwen2.5-0.5B-Instruct"
MAX_NEW_TOKENS = 64
def select_device_and_dtype():
if torch.cuda.is_available():
return "cuda", torch.float16
if torch.backends.mps.is_available():
return "mps", torch.float32
return "cpu", torch.float32
device, dtype = select_device_and_dtype()
print(f"运行设备: {device},数据类型: {dtype}")
tokenizer = AutoTokenizer.from_pretrained(
MODEL_PATH,
local_files_only=True,
)
model = AutoModelForCausalLM.from_pretrained(
MODEL_PATH,
local_files_only=True,
dtype=dtype,
).to(device)
model.eval()
messages = [
    {
        "role": "system",
        "content": "你是一名耐心的人工智能老师。",
    },
    {
        "role": "user",
        "content": "请用一句话解释什么是 Token。",
    },
]
formatted_prompt = tokenizer.apply_chat_template(
messages,
tokenize=False,
add_generation_prompt=True,
)
print("\n=== 1. Chat Template ===")
print(formatted_prompt)
model_inputs = tokenizer.apply_chat_template(
messages,
tokenize=True,
add_generation_prompt=True,
return_dict=True,
return_tensors="pt",
).to(device)
input_ids = model_inputs["input_ids"]
attention_mask = model_inputs["attention_mask"]
print("\n=== 2. Token 化结果 ===")
print("input_ids shape:", tuple(input_ids.shape))
print("attention_mask shape:", tuple(attention_mask.shape))
print("输入 Token 数:", input_ids.shape[1])
print("\n前 20 个 Token:")
tokens = tokenizer.convert_ids_to_tokens(input_ids[0])
for index, (token_id, token) in enumerate(
zip(input_ids[0].tolist(), tokens)
):
if index >= 20:
break
print(f"{index:>2}: id={token_id:<6} token={token!r}")
with torch.inference_mode():
outputs = model(
input_ids=input_ids,
attention_mask=attention_mask,
use_cache=True,
)
next_token_logits = outputs.logits[:, -1, :]
past_key_values = outputs.past_key_values
print("\n=== 3. Prefill ===")
print("全部 Logits shape:", tuple(outputs.logits.shape))
print("下一 Token Logits shape:", tuple(next_token_logits.shape))
print("KV Cache 层数:", len(past_key_values))
probabilities = torch.softmax(next_token_logits.float(), dim=-1)
top_probabilities, top_token_ids = torch.topk(probabilities, k=5, dim=-1)
print("\n=== 4. 第一个待生成 Token 的 Top-5 候选 ===")
for probability, token_id in zip(
top_probabilities[0].tolist(),
top_token_ids[0].tolist(),
):
token_text = tokenizer.decode([token_id])
print(
f"id={token_id:<6} "
f"probability={probability:.4%} "
f"text={token_text!r}"
)
eos_token_ids = model.generation_config.eos_token_id
if isinstance(eos_token_ids, int):
eos_token_ids = {eos_token_ids}
else:
eos_token_ids = set(eos_token_ids or [])
generated_token_ids = []
next_token_id = torch.argmax(next_token_logits, dim=-1, keepdim=True)
print("\n=== 5. Decode 循环 ===")
for step in range(MAX_NEW_TOKENS):
token_id = next_token_id.item()
generated_token_ids.append(token_id)
token_piece = tokenizer.decode(
[token_id],
skip_special_tokens=False,
)
print(f"step={step + 1:>2} id={token_id:<6} piece={token_piece!r}")
if token_id in eos_token_ids:
print("停止原因: 生成 EOS Token")
break
attention_mask = torch.cat(
[
attention_mask,
torch.ones(
(attention_mask.shape[0], 1),
dtype=attention_mask.dtype,
device=device,
),
],
dim=1,
)
with torch.inference_mode():
outputs = model(
input_ids=next_token_id,
attention_mask=attention_mask,
past_key_values=past_key_values,
use_cache=True,
)
past_key_values = outputs.past_key_values
next_token_logits = outputs.logits[:, -1, :]
next_token_id = torch.argmax(
next_token_logits,
dim=-1,
keepdim=True,
)
else:
print("停止原因: 达到 MAX_NEW_TOKENS")
response = tokenizer.decode(
generated_token_ids,
skip_special_tokens=True,
)
print("\n=== 6. 最终回答 ===")
print(response)
|
执行结果
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
62
63
64
65
66
67
68
69
70
71
72
73
74
75
76
77
| /Users/jean/.pyenv/shims/uv run /Users/jean/PycharmProjects/llm-base/.venv/bin/python /Users/jean/PycharmProjects/llm-base/qwen_inference_walkthrough.py
运行设备: mps,数据类型: torch.float32
Loading weights: 100%|██████████| 290/290 [00:01<00:00, 235.18it/s]
=== 1. Chat Template ===
<|im_start|>system
你是一名耐心的人工智能老师。<|im_end|>
<|im_start|>user
请用一句话解释什么是 Token。<|im_end|>
<|im_start|>assistant
=== 2. Token 化结果 ===
input_ids shape: (1, 28)
attention_mask shape: (1, 28)
输入 Token 数: 28
前 20 个 Token:
0: id=151644 token='<|im_start|>'
1: id=8948 token='system'
2: id=198 token='Ċ'
3: id=56568 token='ä½ł'
4: id=110124 token='æĺ¯ä¸ĢåIJį'
5: id=105779 token='èĢIJå¿ĥ'
6: id=100623 token='çļĦ人'
7: id=48692 token='å·¥'
8: id=100168 token='æĻºèĥ½'
9: id=101049 token='èĢģå¸Ī'
10: id=1773 token='ãĢĤ'
11: id=151645 token='<|im_end|>'
12: id=198 token='Ċ'
13: id=151644 token='<|im_start|>'
14: id=872 token='user'
15: id=198 token='Ċ'
16: id=14880 token='请'
17: id=11622 token='çĶ¨'
18: id=105321 token='ä¸Ģåı¥è¯Ŀ'
19: id=104136 token='解éĩĬ'
=== 3. Prefill ===
全部 Logits shape: (1, 28, 151936)
下一 Token Logits shape: (1, 151936)
KV Cache 层数: 24
=== 4. 第一个待生成 Token 的 Top-5 候选 ===
id=3323 probability=90.9217% text='Token'
id=18493 probability=7.5234% text='在'
id=29300 probability=0.2645% text='Tokens'
id=5839 probability=0.2221% text='token'
id=1 probability=0.1813% text='"'
=== 5. Decode 循环 ===
step= 1 id=3323 piece='Token'
step= 2 id=54851 piece=' 是'
step= 3 id=101053 piece='一种'
step= 4 id=18493 piece='在'
step= 5 id=102182 piece='机器'
step= 6 id=100134 piece='学习'
step= 7 id=33108 piece='和'
step= 8 id=99795 piece='自然'
step= 9 id=102064 piece='语言'
step=10 id=54542 piece='处理'
step=11 id=15946 piece='中'
step=12 id=100751 piece='用于'
step=13 id=51463 piece='表示'
step=14 id=108704 piece='文本'
step=15 id=9370 piece='的'
step=16 id=108872 piece='符号'
step=17 id=1773 piece='。'
step=18 id=151645 piece='<|im_end|>'
停止原因: 生成 EOS Token
=== 6. 最终回答 ===
Token 是一种在机器学习和自然语言处理中用于表示文本的符号。
Process finished with exit code 0
|
关键输出如何理解
Chat Template
程序首先打印模型实际看到的消息格式。你可以观察 System、User 和 Assistant 起始标记是如何进入上下文的。
Token 化结果
程序打印前 20 个 Token 的 ID 和词表表示。部分 Token 可能看起来不像完整汉字或单词,这是正常现象,因为 Token 可以是字符、子词、字节片段或特殊标记。
Logits 形状
如果输出为:
1
| 全部 Logits shape: (1, 35, 151936)
|
表示:
- Batch Size 为 1;
- 输入序列包含 35 个 Token;
- 每个位置都产生了 151,936 个词表候选分数。
生成下一个 Token 时,只需要使用最后一个位置的 Logits:
1
| next_token_logits = outputs.logits[:, -1, :]
|
KV Cache
past_key_values 保存各 Transformer 层已经计算的 Key 和 Value。Decode 时只输入最新生成的 Token,同时传回缓存,从而避免重新处理全部历史 Token。
手动 Decode
代码使用 argmax 实现 Greedy Decoding,因此在相同模型、输入和运行环境下,结果通常是确定的。
这段手动循环主要用于学习模型的生成机制。实际项目通常直接使用经过优化的 model.generate():
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
| with torch.inference_mode():
output_ids = model.generate(
**model_inputs,
max_new_tokens=64,
do_sample=False,
)
input_length = model_inputs["input_ids"].shape[1]
generated_ids = output_ids[0, input_length:]
response = tokenizer.decode(
generated_ids,
skip_special_tokens=True,
)
print(response)
|
generate() 会帮助处理 KV Cache、停止条件、批处理以及不同解码策略,通常比手写循环更安全。
流式输出是如何实现的?
模型内部仍然是逐 Token 生成。所谓流式输出,是推理服务在生成过程中不断把已经解码的新增内容发送给客户端。
1
2
3
4
5
6
7
| 模型生成 Token
↓
增量解码
↓
服务端发送数据块
↓
客户端立即显示
|
因此,流式输出通常不会让模型更早完成整段回答,但可以让用户更早看到首个结果,改善交互体验。
流式输出还需要处理一个细节:单独一个 Token 不一定能立即解码成完整字符。一些实现会暂存尚未形成完整文本的字节片段,再将可显示内容发送给客户端。
一次请求中的时间都花在哪里?
一次 LLM 请求的延迟大致来自以下部分:
| 阶段 |
可能的耗时来源 |
| 网络传输 |
请求体大小、网络距离、连接建立 |
| 排队与调度 |
并发请求数量、批处理策略、服务负载 |
| Token 化 |
输入长度、Tokenizer 实现 |
| Prefill |
输入 Token 数、模型规模、计算设备 |
| Decode |
输出 Token 数、KV Cache、解码策略 |
| 文本后处理 |
增量解码、内容检查、格式校验 |
常见性能指标包括:
| 指标 |
含义 |
| TTFT |
从请求开始到产生首个输出 Token 的时间 |
| TPOT |
生成阶段平均每个输出 Token 所需时间 |
| Tokens/s |
每秒生成的 Token 数量 |
| End-to-End Latency |
从发送请求到完整响应结束的总时间 |
通常来说:输入越长,Prefill 成本越高;输出越长,Decode 循环次数越多。
常见误区
误区一:模型直接读取了用户输入的文字
模型实际处理的是经过 Chat Template 和 Tokenizer 转换后的 Token ID 与数值向量。角色标记、特殊 Token 和消息边界都会影响最终输入。
误区二:模型一次生成完整回答
典型自回归 LLM 每轮只预测一个新 Token。完整回答来自不断“预测—选择—追加—再预测”的循环。
误区三:概率最高的 Token 就一定正确
概率描述的是模型认为某个 Token 在当前上下文中有多合适,不是事实正确率。语言流畅与事实可靠是两个不同问题。
误区四:KV Cache 是模型的长期记忆
KV Cache 只是一次推理过程中复用注意力计算的缓存。请求结束后,它通常会被释放;它不等于用户记忆、知识库或模型参数。
误区五:上下文越长,模型理解得越好
加入上下文会增加可用信息,也可能引入噪声、冲突信息和更高延迟。上下文窗口表示容量上限,不代表模型能够同等有效地使用窗口中的所有内容。
小结
一次 LLM 请求的核心流程可以概括为:
- 应用将 System、User 和历史消息组织成消息列表;
- Chat Template 将消息转换成模型约定的序列;
- Tokenizer 将文本编码为 Token ID;
- Prefill 处理全部输入,计算首轮 Logits 并建立 KV Cache;
- 解码策略从候选分布中选择下一个 Token;
- Decode 利用 KV Cache 逐 Token 生成后续内容;
- 命中 EOS、Stop Sequence 或长度限制后停止;
- Tokenizer 将输出 Token ID 解码为最终文本。
理解这条链路之后,后续学习 Tokenizer、解码参数、上下文窗口、结构化输出和模型推理优化时,就能知道每个概念位于整条请求链路的什么位置。
参考资料