什么是大语言模型(LLM)?
大语言模型(Large Language Model,LLM)通常可以理解为一种基于上下文预测下一个 Token 的概率模型:给定一段文本,模型计算词表中各个候选 Token 的分数,再根据解码策略选择下一个 Token。新 Token 被加入序列后,模型继续预测,直到生成结束标记、命中停止条件或达到长度上限。
这个机制听起来简单,但模型的能力来自多个因素的共同作用:大规模训练数据、模型架构、参数规模、训练方法和推理机制。模型在海量文本、代码等数据中学习语言规律、知识关联和部分推理模式,因此能够完成问答、摘要、翻译、代码生成等任务。
需要注意,模型能力并不只取决于参数规模,也不是模型一旦变大就必然出现某种能力。训练数据质量、训练目标、后训练方法和评测任务都会影响最终表现。
LLM = Transformer 等模型架构 + 大规模训练与后训练 + 基于上下文的 Token 预测
这里的公式是帮助理解的概念总结,并非严格的数学等式。
LLM 不等于 AI Agent。LLM 可以充当 Agent 的语言理解、推理和决策核心;而 Agent 通常还需要工具调用、状态管理、记忆、规划、执行循环和结果验证等机制,才能完成更复杂的任务。
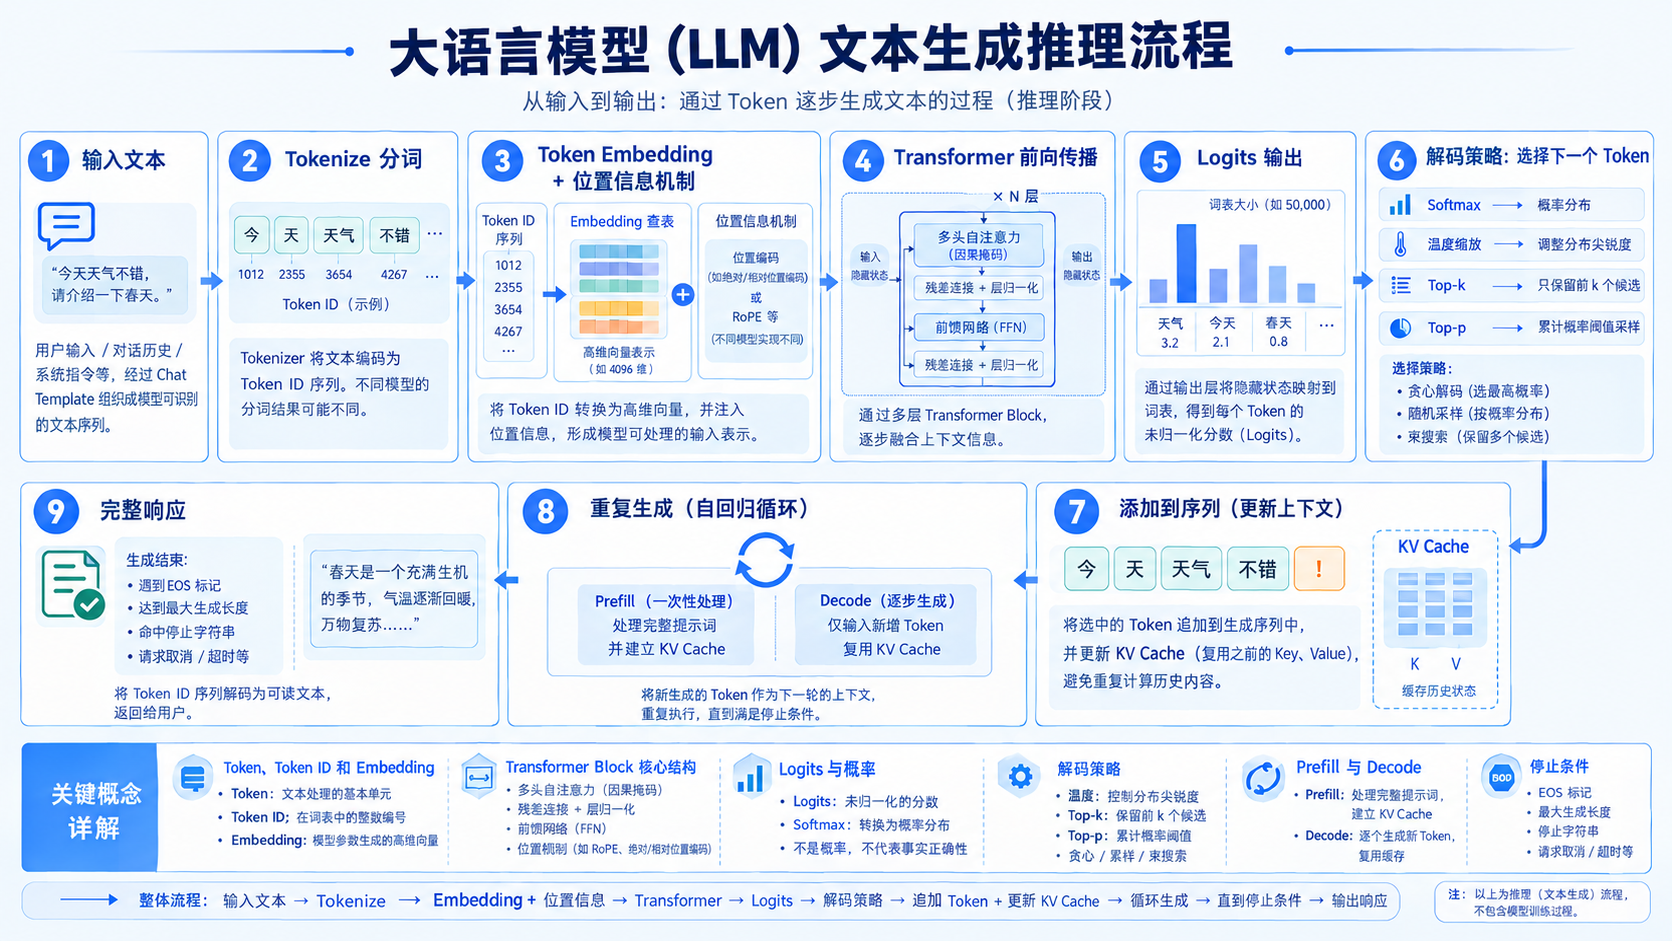
| 流程阶段 | 核心概念 | 通俗解释 | 主要作用 |
|---|---|---|---|
| 输入文本 | Prompt / Context | 告诉模型要做什么,以及它可以参考哪些信息 | 提供生成依据 |
| 文本分词 | Tokenizer | 把文本切分并转换成模型认识的离散编号 | 将文本转化为模型输入 |
| 向量化 | Token Embedding | 把离散编号映射成高维数字向量 | 形成神经网络可处理的表示 |
| 上下文计算 | Transformer | 让模型结合上下文理解当前 Token 的含义 | 提取上下文关联并计算隐藏状态 |
| 预测打分 | Logits | 给词表里的每个候选 Token 打分 | 评估下一步的候选结果 |
| 选择 Token | 解码策略 | 根据分数和生成参数决定选哪个 Token | 确定下一个输出单元 |
| 更新序列 | Token 追加 / KV Cache | 把新 Token 加到序列中,并复用历史计算 | 为后续生成准备上下文 |
| 循环生成 | 自回归生成 | 根据已有内容继续预测下一个 Token | 逐步形成完整回答 |
| 输出响应 | 停止判断 / 文本解码 | 满足结束条件后,把 Token 序列还原为文本 | 返回最终回答 |
整体可以概括为:
输入文本 → Token 化 → 向量表示 → Transformer 计算 → 预测下一个 Token → 追加并循环 → 输出文本。
核心概念讲解
输入文本与 Tokenizer:模型如何读取文字?
| 概念 | 专业解释 | 通俗理解 | 示例 / 说明 |
|---|---|---|---|
| Prompt(提示词) | 提供给模型的指令、问题或输入内容 | 给模型布置的任务 | “请解释什么是人工智能” |
| Context(上下文) | 模型当前生成时可以利用的输入信息和已有序列 | 模型回答问题时能看到的内容 | 系统指令、历史对话、当前问题 |
| Chat Template(聊天模板) | 将多轮消息组织成模型约定格式的规则 | 把对话整理成模型能识别的格式 | 区分 system、user、assistant 等角色 |
| Tokenizer(分词器) | 将文本编码为 Token ID 序列的组件 | 把文字转换成模型的输入编号 | 一句话可能被切分成多个 Token |
| Token(词元) | 文本编码中的基本离散单元 | 模型处理文字时使用的基本单位 | 可能是词、子词、字符片段或特殊标记 |
| Token ID | Token 在特定词表中的整数编号 | 每个 Token 对应的编号 | 1012 只是示意编号,并非通用固定编码 |
| Vocabulary(词表) | Tokenizer 所使用的全部 Token 集合 | 模型可识别的 Token 编号表 | 不同模型的词表可能不同 |
| Special Token(特殊 Token) | 用于标识边界、角色或控制信息的特殊符号 | 给模型提供结构和控制信号 | EOS、消息边界标记等 |
关键理解:Tokenizer 并不负责理解文字的语义,而是按照特定规则对文本进行编码。真正的上下文建模主要由后续神经网络完成。
Embedding:模型如何把文字变成数字?
| 概念 | 专业解释 | 通俗理解 | 关键作用 |
|---|---|---|---|
| Token Embedding | 将 Token ID 映射为可训练的稠密向量 | 将编号转换成一串数字 | 为神经网络提供数值输入 |
| Embedding Dimension(向量维度) | 每个 Token 向量包含的数值数量 | 一串数字有多长 | 例如某模型的隐藏维度为 4096 |
| Position Information(位置信息) | 通过位置编码、旋转位置编码等机制注入序列位置信息 | 告诉模型 Token 在序列中的位置 | 帮助模型区分先后顺序 |
| Hidden State(隐藏状态) | 神经网络内部随计算逐层更新的向量表示 | 模型当前对某个位置形成的内部表示 | 融合 Token 信息和上下文信息 |
| Contextual Representation(上下文表示) | 经上下文计算后得到的、依赖具体序列的表示 | 同一个词在不同句子中可以有不同的内部表示 | 支持语境相关的预测与理解 |
这里要区分两个容易混淆的概念:
- Embedding:Token ID 对应的初始向量表示。
- Hidden State:向量经过 Transformer 等网络层计算后得到的中间表示。
例如,“苹果”出现在“我吃了一个苹果”和“苹果发布了新手机”中时,输入 Token 的初始 Embedding 可以相同,但经过上下文计算后,模型形成的隐藏状态可以不同。
Transformer:大模型为什么能够结合上下文?
Transformer 是现代许多 LLM 的核心架构。它通过注意力机制和神经网络层,逐步计算上下文相关的表示。
| 概念 | 全称 / 含义 | 通俗解释 | 主要作用 |
|---|---|---|---|
| Transformer | 一种基于注意力机制的神经网络架构 | 大模型处理上下文的核心计算框架 | 建立序列中不同位置的信息关联 |
| Self-Attention | 自注意力机制 | 判断当前 Token 应参考上下文中的哪些信息 | 聚合相关信息 |
| Query(Q) | 查询向量 | 当前 Token 想寻找什么信息 | 参与计算注意力权重 |
| Key(K) | 键向量 | 每个位置可以提供什么信息 | 与 Query 计算匹配程度 |
| Value(V) | 值向量 | 每个位置实际提供的内容表示 | 按注意力权重聚合信息 |
| Multi-Head Attention | 多头注意力 | 多组注意力机制并行提取不同关联 | 增强信息建模能力 |
| Causal Mask | 因果掩码 | 禁止当前位置看到不允许访问的未来 Token | 保证自回归预测的因果约束 |
| FFN / MLP | 前馈网络 | 对每个位置的表示进行进一步变换 | 增强网络的非线性表达能力 |
| Residual Connection | 残差连接 | 为信息传递提供直接路径 | 改善深层网络的训练与信息传播 |
| Layer Normalization | 层归一化 | 对中间表示进行归一化处理 | 帮助稳定训练和计算 |
| Transformer Block | Transformer 基本层 | 注意力、前馈网络等组件组成的计算单元 | 逐层更新隐藏状态 |
| N 层堆叠 | 多个 Transformer Block 依次连接 | 一层层进行更复杂的计算 | 逐步形成更丰富的上下文表示 |
以“苹果发布了新手机”为例,模型可以通过上下文关联,学习“苹果”与“发布”“新手机”等词语之间的关系。这里的注意力权重并不是一份可直接等同于人类思维过程的解释,而是网络内部进行信息计算的机制。
一个重要区别:Transformer 不等于 LLM。Transformer 是一种架构;LLM 还涉及具体模型参数、训练数据、训练目标和训练方法。现代 LLM 也并非全部采用完全相同的 Transformer 结构。
Logits、Softmax 与概率:模型如何预测下一个 Token?
| 概念 | 专业解释 | 通俗理解 | 注意事项 |
|---|---|---|---|
| Language Model Head(语言模型输出头) | 将隐藏状态映射到词表对应的预测分数 | 把内部表示转换成候选 Token 的分数 | 输出维度通常与词表大小相关 |
| Logits | 未归一化的预测分数 | 每个候选 Token 的原始打分 | 不是概率,也不要求介于 0 和 1 之间 |
| Softmax | 将一组分数转换为概率分布的函数 | 把分数转换成总和为 1 的概率 | 常见生成流程中的概率转换方式 |
| Probability Distribution | 概率分布 | 每个候选 Token 被选择的相对概率 | 不等于事实正确率 |
| Next-Token Prediction | 下一个 Token 预测 | 根据已有上下文计算下一步输出 | 是典型自回归 LLM 的核心任务之一 |
| Decoding(解码) | 根据预测分数及生成规则选择输出 Token | 决定下一步实际输出什么 | 可以是贪心选择,也可以是采样等方法 |
例如,假设词表中有 50,000 个 Token,模型对当前预测位置可以产生 50,000 个 Logits。以下只展示三个候选项:
| 候选 Token | Logits | Softmax 概率(约) |
|---|---|---|
| A | 3 | 66.5% |
| B | 2 | 24.5% |
| C | 1 | 9.0% |
这组示例说明,Logits 经 Softmax 后可以形成概率分布。模型随后根据所采用的解码策略选择 Token。
需要牢记:模型认为某个 Token 更可能出现,不代表这个 Token 所表达的事实一定正确。语言生成概率与事实可靠性不是一回事。
Temperature、Top-k、Top-p:如何控制生成结果?
| 概念 | 工作机制 | 对生成结果的影响 | 常见用途 |
|---|---|---|---|
| Temperature(温度) | 对 Logits 进行温度缩放,再进行概率转换 | 较低温度通常让分布更集中;较高温度通常让分布更平缓 | 控制生成的随机性 |
| Greedy Decoding(贪心解码) | 每一步选择分数最高的候选 Token | 通常更确定,但可能缺乏多样性 | 稳定输出、基线对比 |
| Sampling(随机采样) | 按处理后的概率分布选择 Token | 允许不同候选项被选中 | 开放式文本生成 |
| Top-k | 只保留排名最高的 k 个候选项 | 限制候选范围 | 控制候选数量 |
| Top-p(核采样) | 保留累计概率达到阈值 p 所需的候选集合 | 候选集合大小随分布变化 | 在多样性与候选质量间折中 |
| Beam Search(束搜索) | 同时保留多个候选序列并进行搜索 | 关注多个序列的整体得分 | 部分翻译、结构化生成等任务 |
Temperature、Top-k 和 Top-p 并不必然同时启用,具体顺序及行为取决于推理框架。它们主要控制“如何选择输出”,并不会直接增加模型训练时学到的知识。
自回归生成、Prefill、Decode 与 KV Cache
| 概念 | 专业解释 | 通俗理解 | 为什么重要 |
|---|---|---|---|
| Autoregressive Generation(自回归生成) | 根据已有序列预测下一个 Token,并将结果加入序列 | 写一个 Token,再根据已有内容继续写 | 形成逐步生成完整回答的循环 |
| Prefill(预填充) | 并行处理输入提示词中的 Token,建立 KV Cache,并得到下一 Token 的预测分数 | 先把题目和上下文读一遍 | 建立生成所需的初始状态 |
| Decode(逐步解码) | 每轮利用已有缓存处理新 Token,并预测下一个 Token | 开始一个 Token 接一个 Token 地回答 | 完成后续文本生成 |
| KV Cache | 缓存注意力层已计算的 Key 和 Value | 保存历史计算结果,避免重复计算 | 提升生成效率,尤其适用于较长上下文 |
| Context Window(上下文窗口) | 模型在一次处理过程中能够利用的 Token 范围 | 模型当前能参考的上下文容量 | 限制单次可处理的上下文长度 |
| EOS(End of Sequence) | 序列结束标记 | 告诉生成流程可以结束 | 是常见的停止条件之一 |
| Stop Sequence(停止序列) | 服务端配置的触发停止的字符串或 Token 序列 | 遇到指定内容就停止 | 支持应用层的生成控制 |
| Max New Tokens | 本次生成允许新增的 Token 数上限 | 限制回答最多生成多长 | 控制长度、延迟与资源消耗 |
一个典型的推理过程可以这样理解:
- Prefill:处理输入提示词,建立 KV Cache,并计算第一个待生成 Token 的分数。
- 选择:根据解码策略选择下一个 Token。
- Decode:将新 Token 加入序列,利用缓存计算下一步的预测分数。
- 判断:检查是否出现 EOS、停止序列或达到长度上限;若没有,则继续生成。
- 输出:满足停止条件后,将生成的 Token ID 序列解码为文本。
实际系统可能采用分块预填充、投机解码或其他优化方式,因此上述流程是便于理解的典型模式,而不是所有推理引擎唯一的执行实现。
实战:在本地运行 Qwen2.5-0.5B-Instruct
理解基本原理后,下面以 Qwen/Qwen2.5-0.5B-Instruct 为例,演示如何下载模型并在本地完成一次对话。下载前,建议先阅读模型卡,了解模型能力、使用方式、许可证和限制。
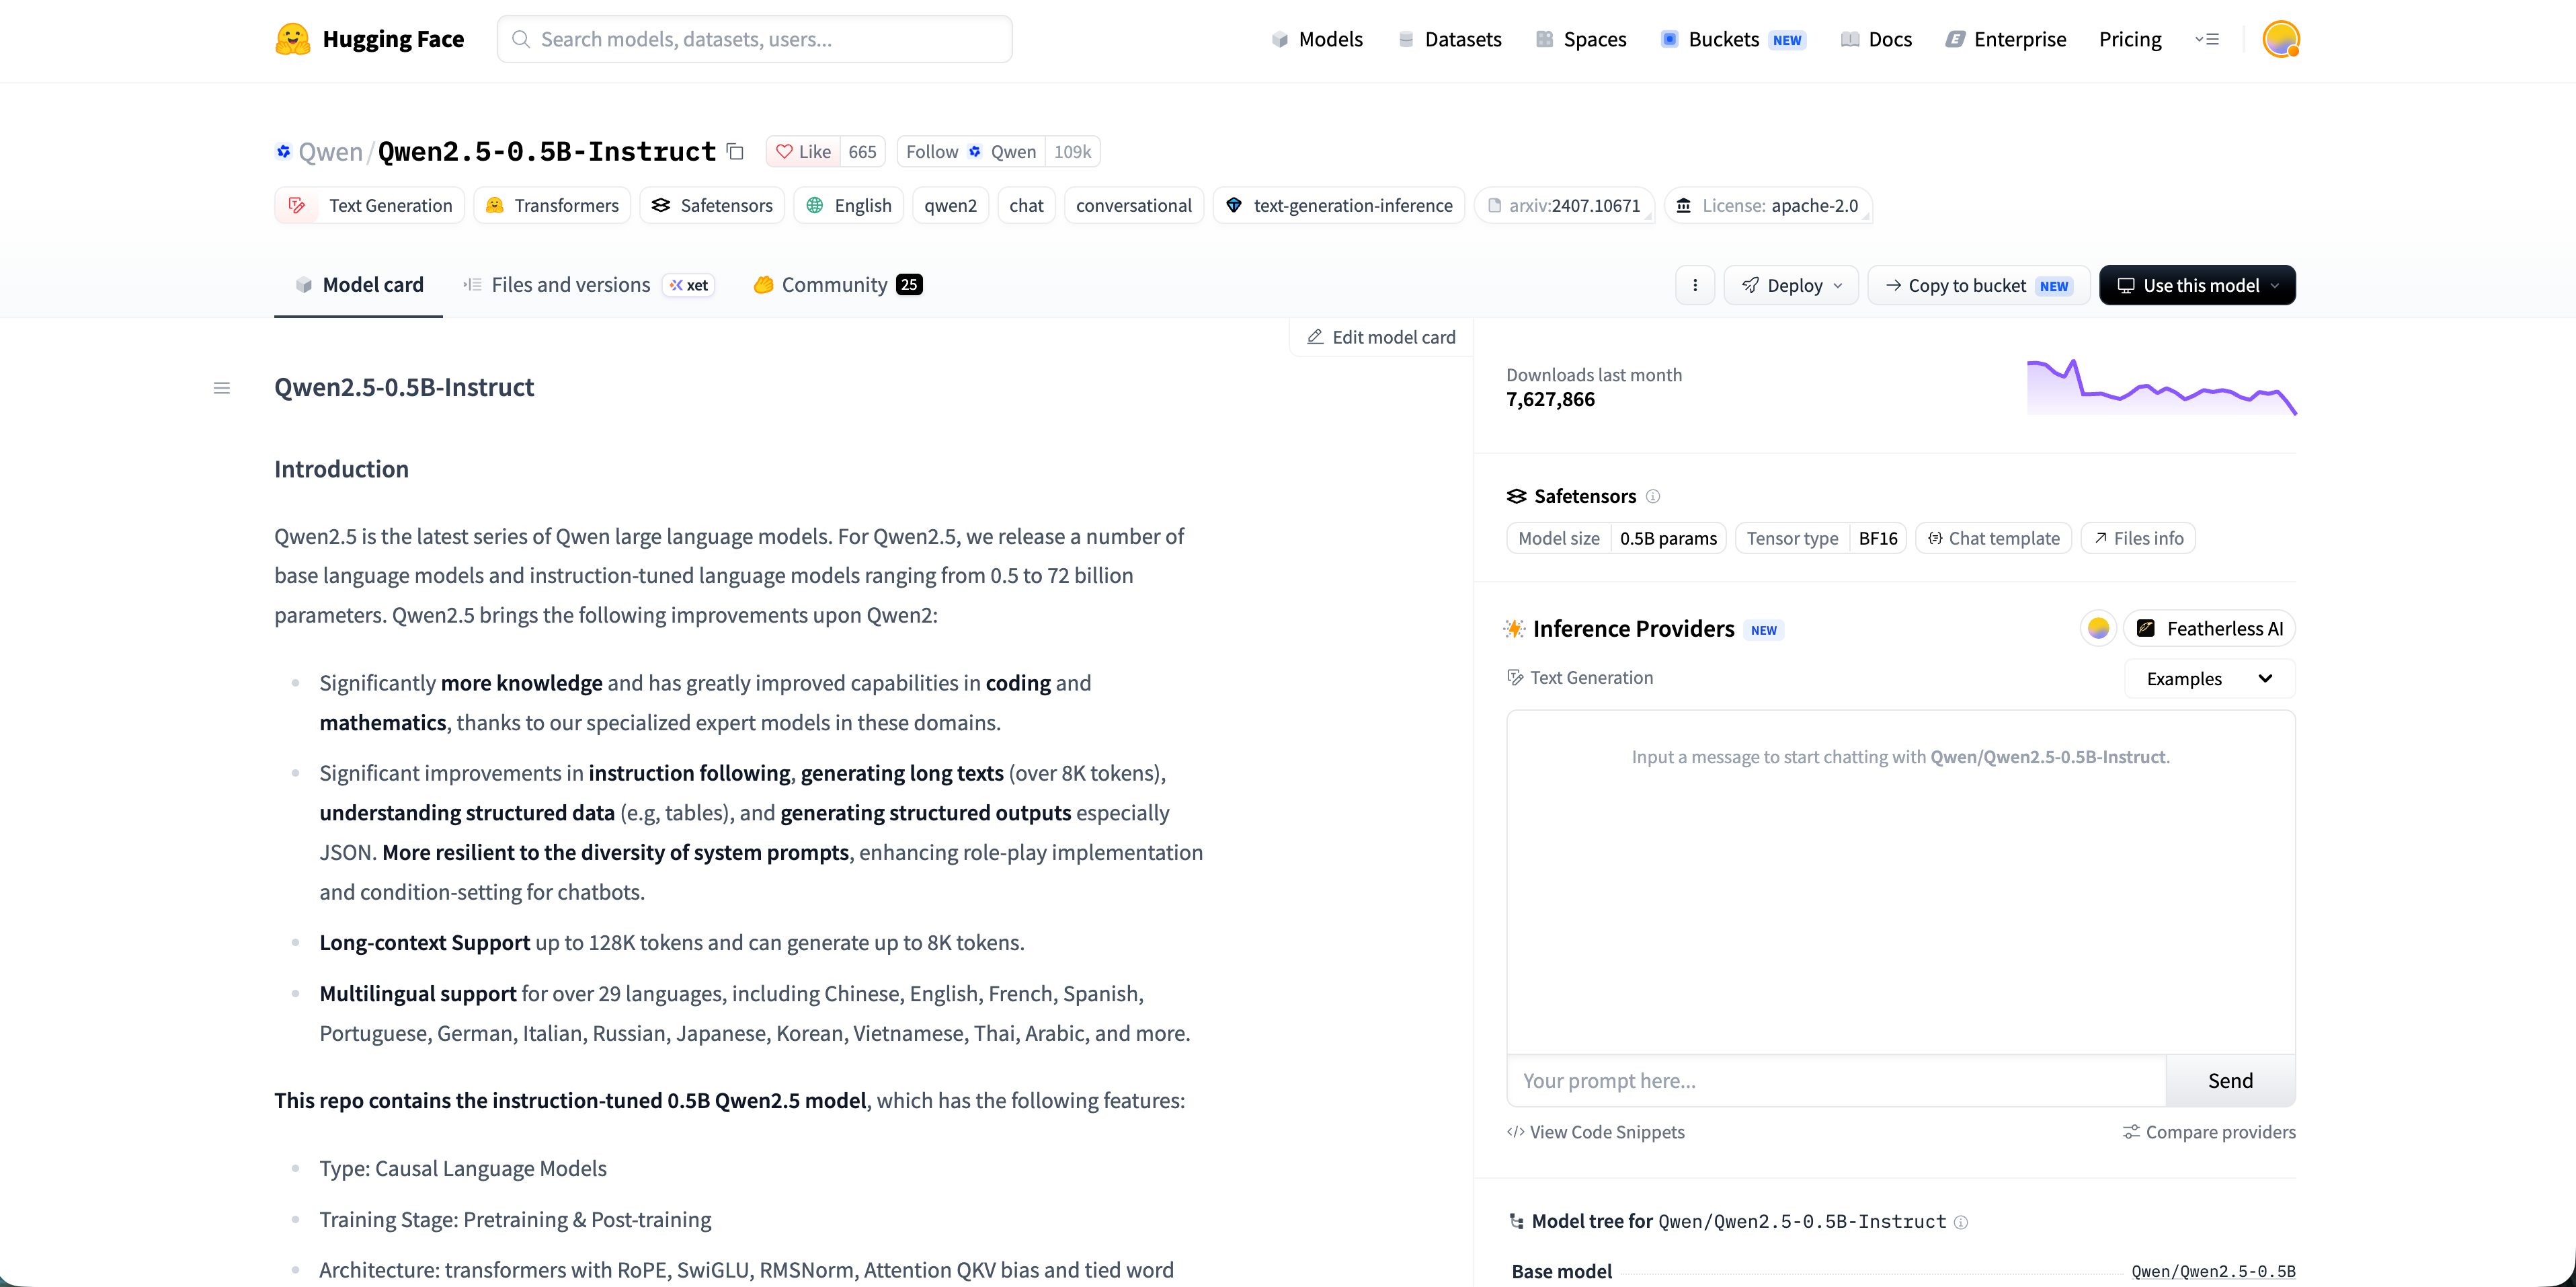
模型仓库主要包含以下文件:
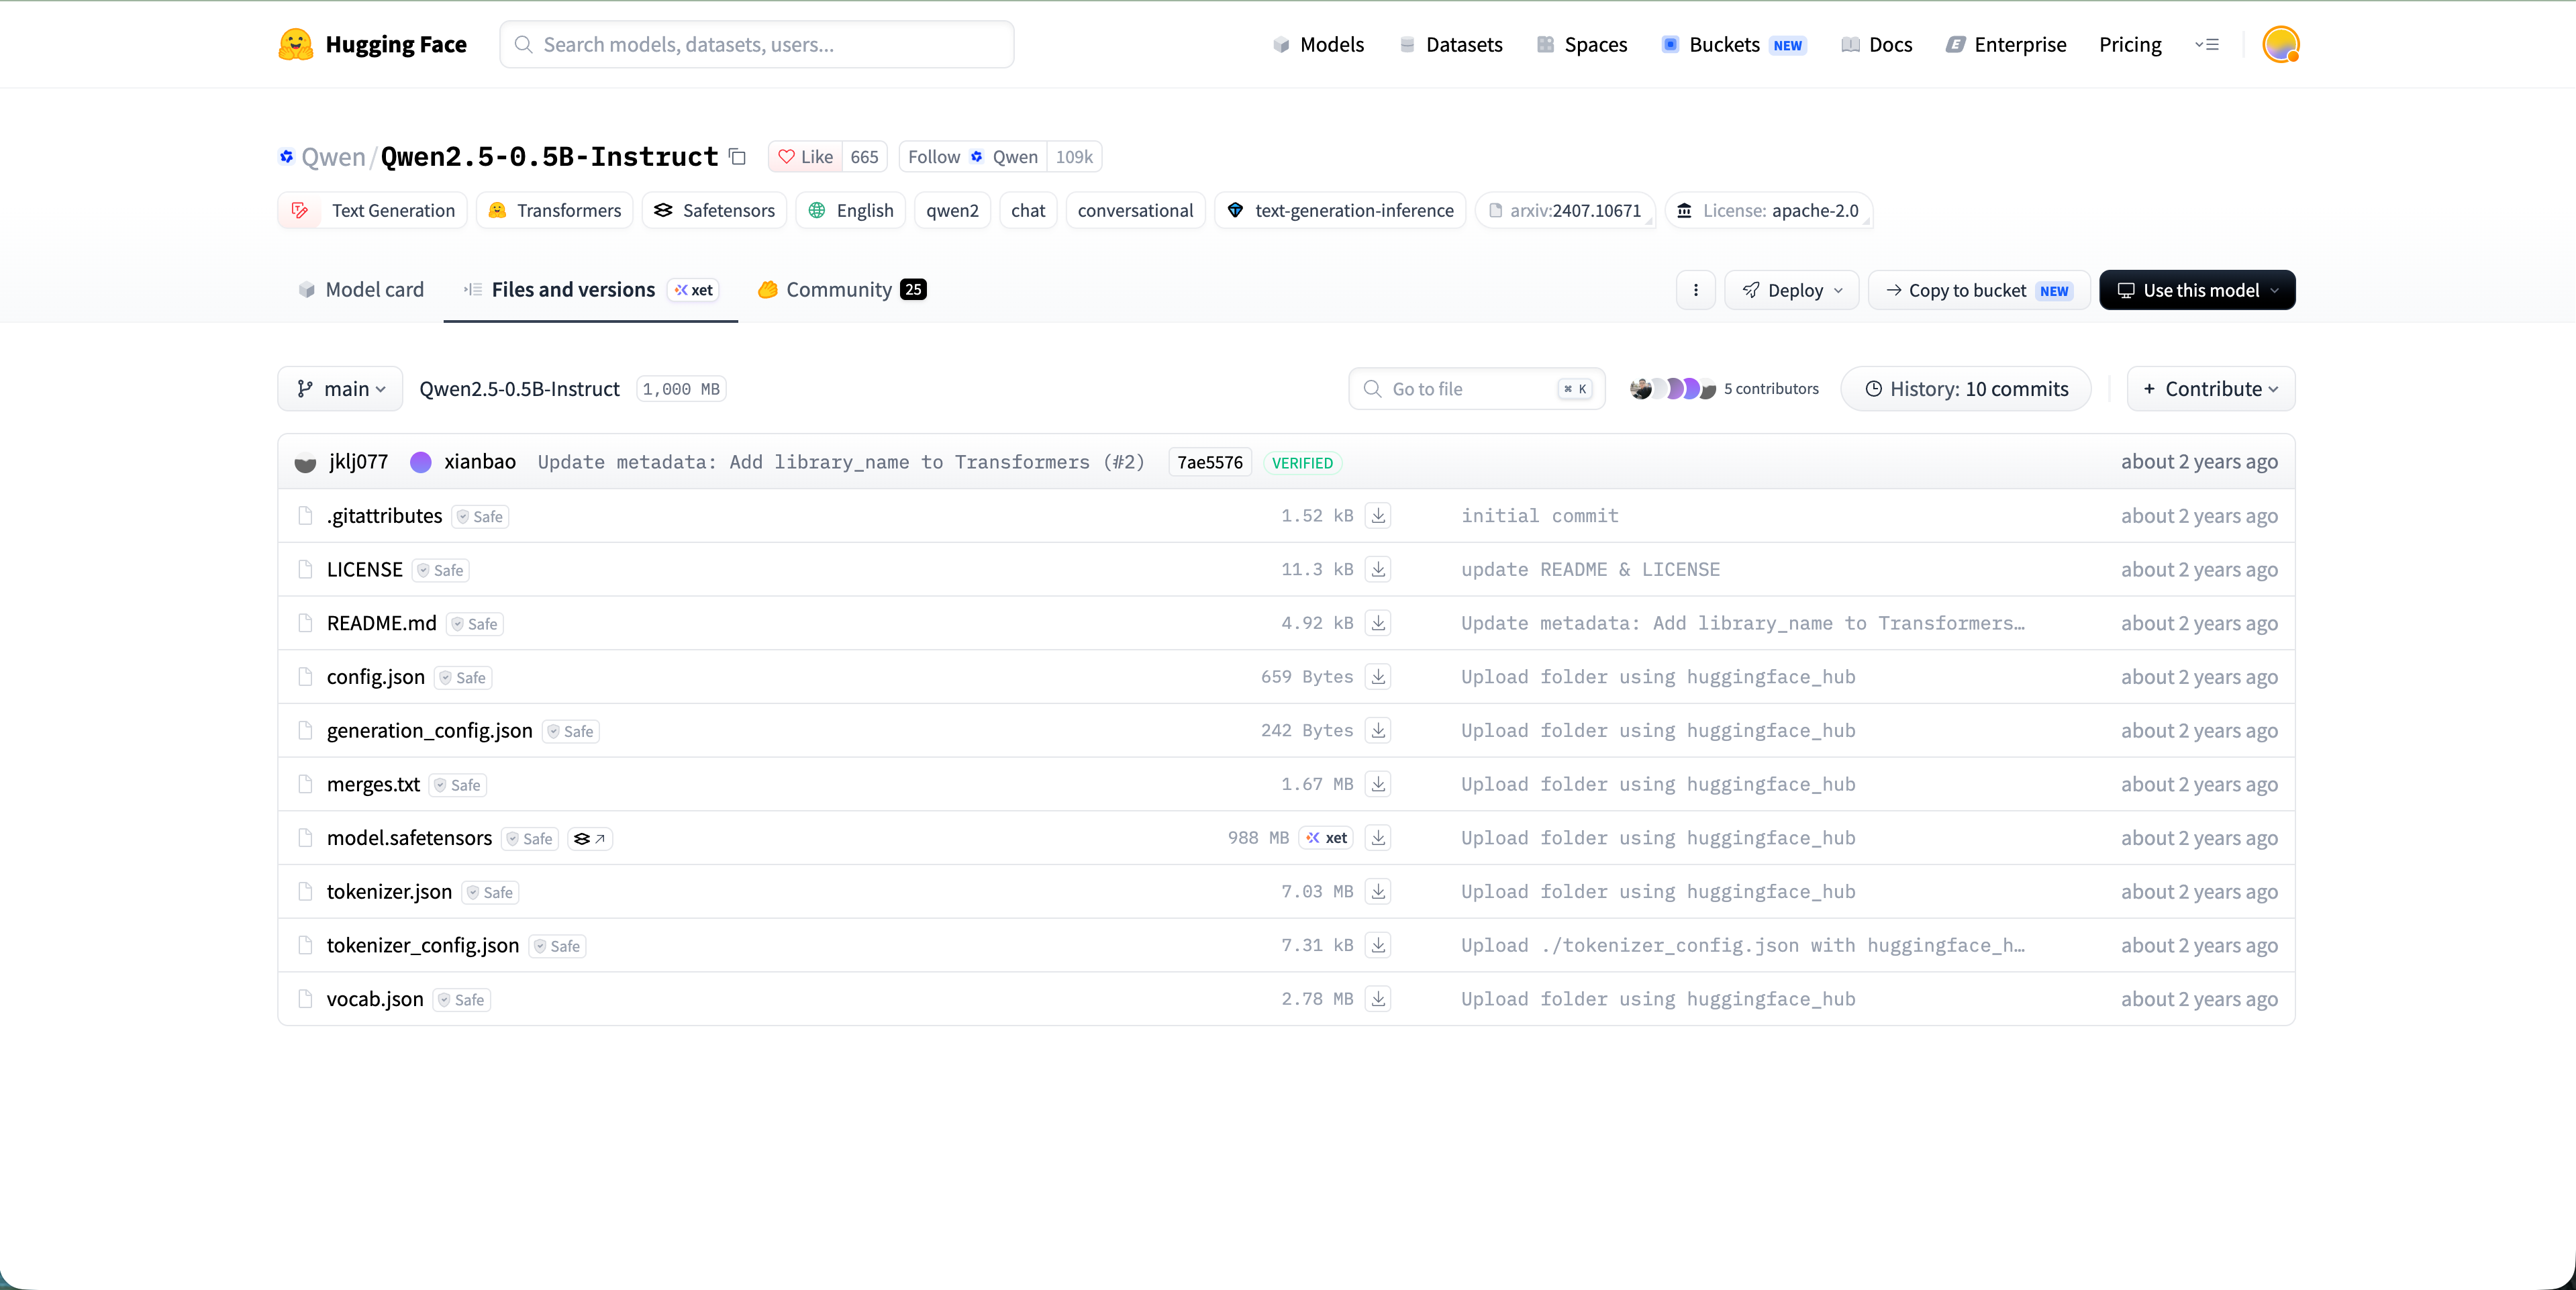
| 文件名称 | 文件大小 | 文件类型 | 主要作用 | 详细说明 | 运行模型是否必需 |
|---|---|---|---|---|---|
.gitattributes |
1.52 KB | Git 配置文件 | 管理仓库文件属性 | 定义 Git 对不同文件的管理方式,例如通过 Git LFS 管理大型模型权重文件。 | 否 |
LICENSE |
11.3 KB | 许可证文件 | 规定模型使用权限 | 描述模型的使用、修改、分发及商业使用等授权条件。该模型采用 Apache 2.0 许可证。 | 否,但需要关注合规 |
README.md |
4.92 KB | Markdown 文档 | 模型介绍与使用说明 | 通常包含模型基本信息、参数规模、适用场景、使用示例、运行环境和注意事项。 | 否 |
config.json |
659 Bytes | JSON 配置文件 | 定义模型网络结构 | 描述模型架构及核心参数,例如 Transformer 层数、隐藏层维度、Attention 头数、词表大小等。Transformers 根据此文件创建对应的神经网络结构。 | 是 |
generation_config.json |
242 Bytes | JSON 配置文件 | 控制文本生成行为 | 保存模型默认生成配置,例如结束 Token、采样参数等。生成时也可以通过 model.generate() 覆盖相关参数。 |
否 |
merges.txt |
1.67 MB | 文本文件 | 定义 BPE 分词合并规则 | 保存 Byte Pair Encoding(字节对编码)的合并规则,帮助分词器将文本拆分为 Token。 | 视分词器加载方式而定 |
model.safetensors |
988 MB | 二进制权重文件 | 存储模型训练权重 | 保存神经网络训练得到的参数,包括 Embedding、Attention、MLP 等层的权重矩阵。模型推理时通过这些参数执行数学计算,是模型能力的核心载体。 | 是 |
tokenizer.json |
7.03 MB | JSON 文件 | 文本分词与编码 | 保存分词器的完整配置和相关数据,将输入文本转换成 Token ID,也支持将 Token 转换回文本。 | 是(或使用等效分词器文件) |
tokenizer_config.json |
7.31 KB | JSON 配置文件 | 配置分词器和聊天模板 | 包含分词器设置、特殊 Token 和 Chat Template 等信息,用于将 System、User、Assistant 消息转换为模型要求的输入格式。 | 聊天场景通常需要 |
vocab.json |
2.78 MB | JSON 词表文件 | 保存 Token 与 ID 的映射 | 定义 Token 和数字 ID 的对应关系,是 BPE 分词器的重要组成部分。 | 视分词器加载方式而定 |
如果当前网络无法稳定访问 Hugging Face,也可以在魔搭社区中搜索相同模型。不同平台的仓库结构和下载方式可能略有差异,请以对应模型页的说明为准。
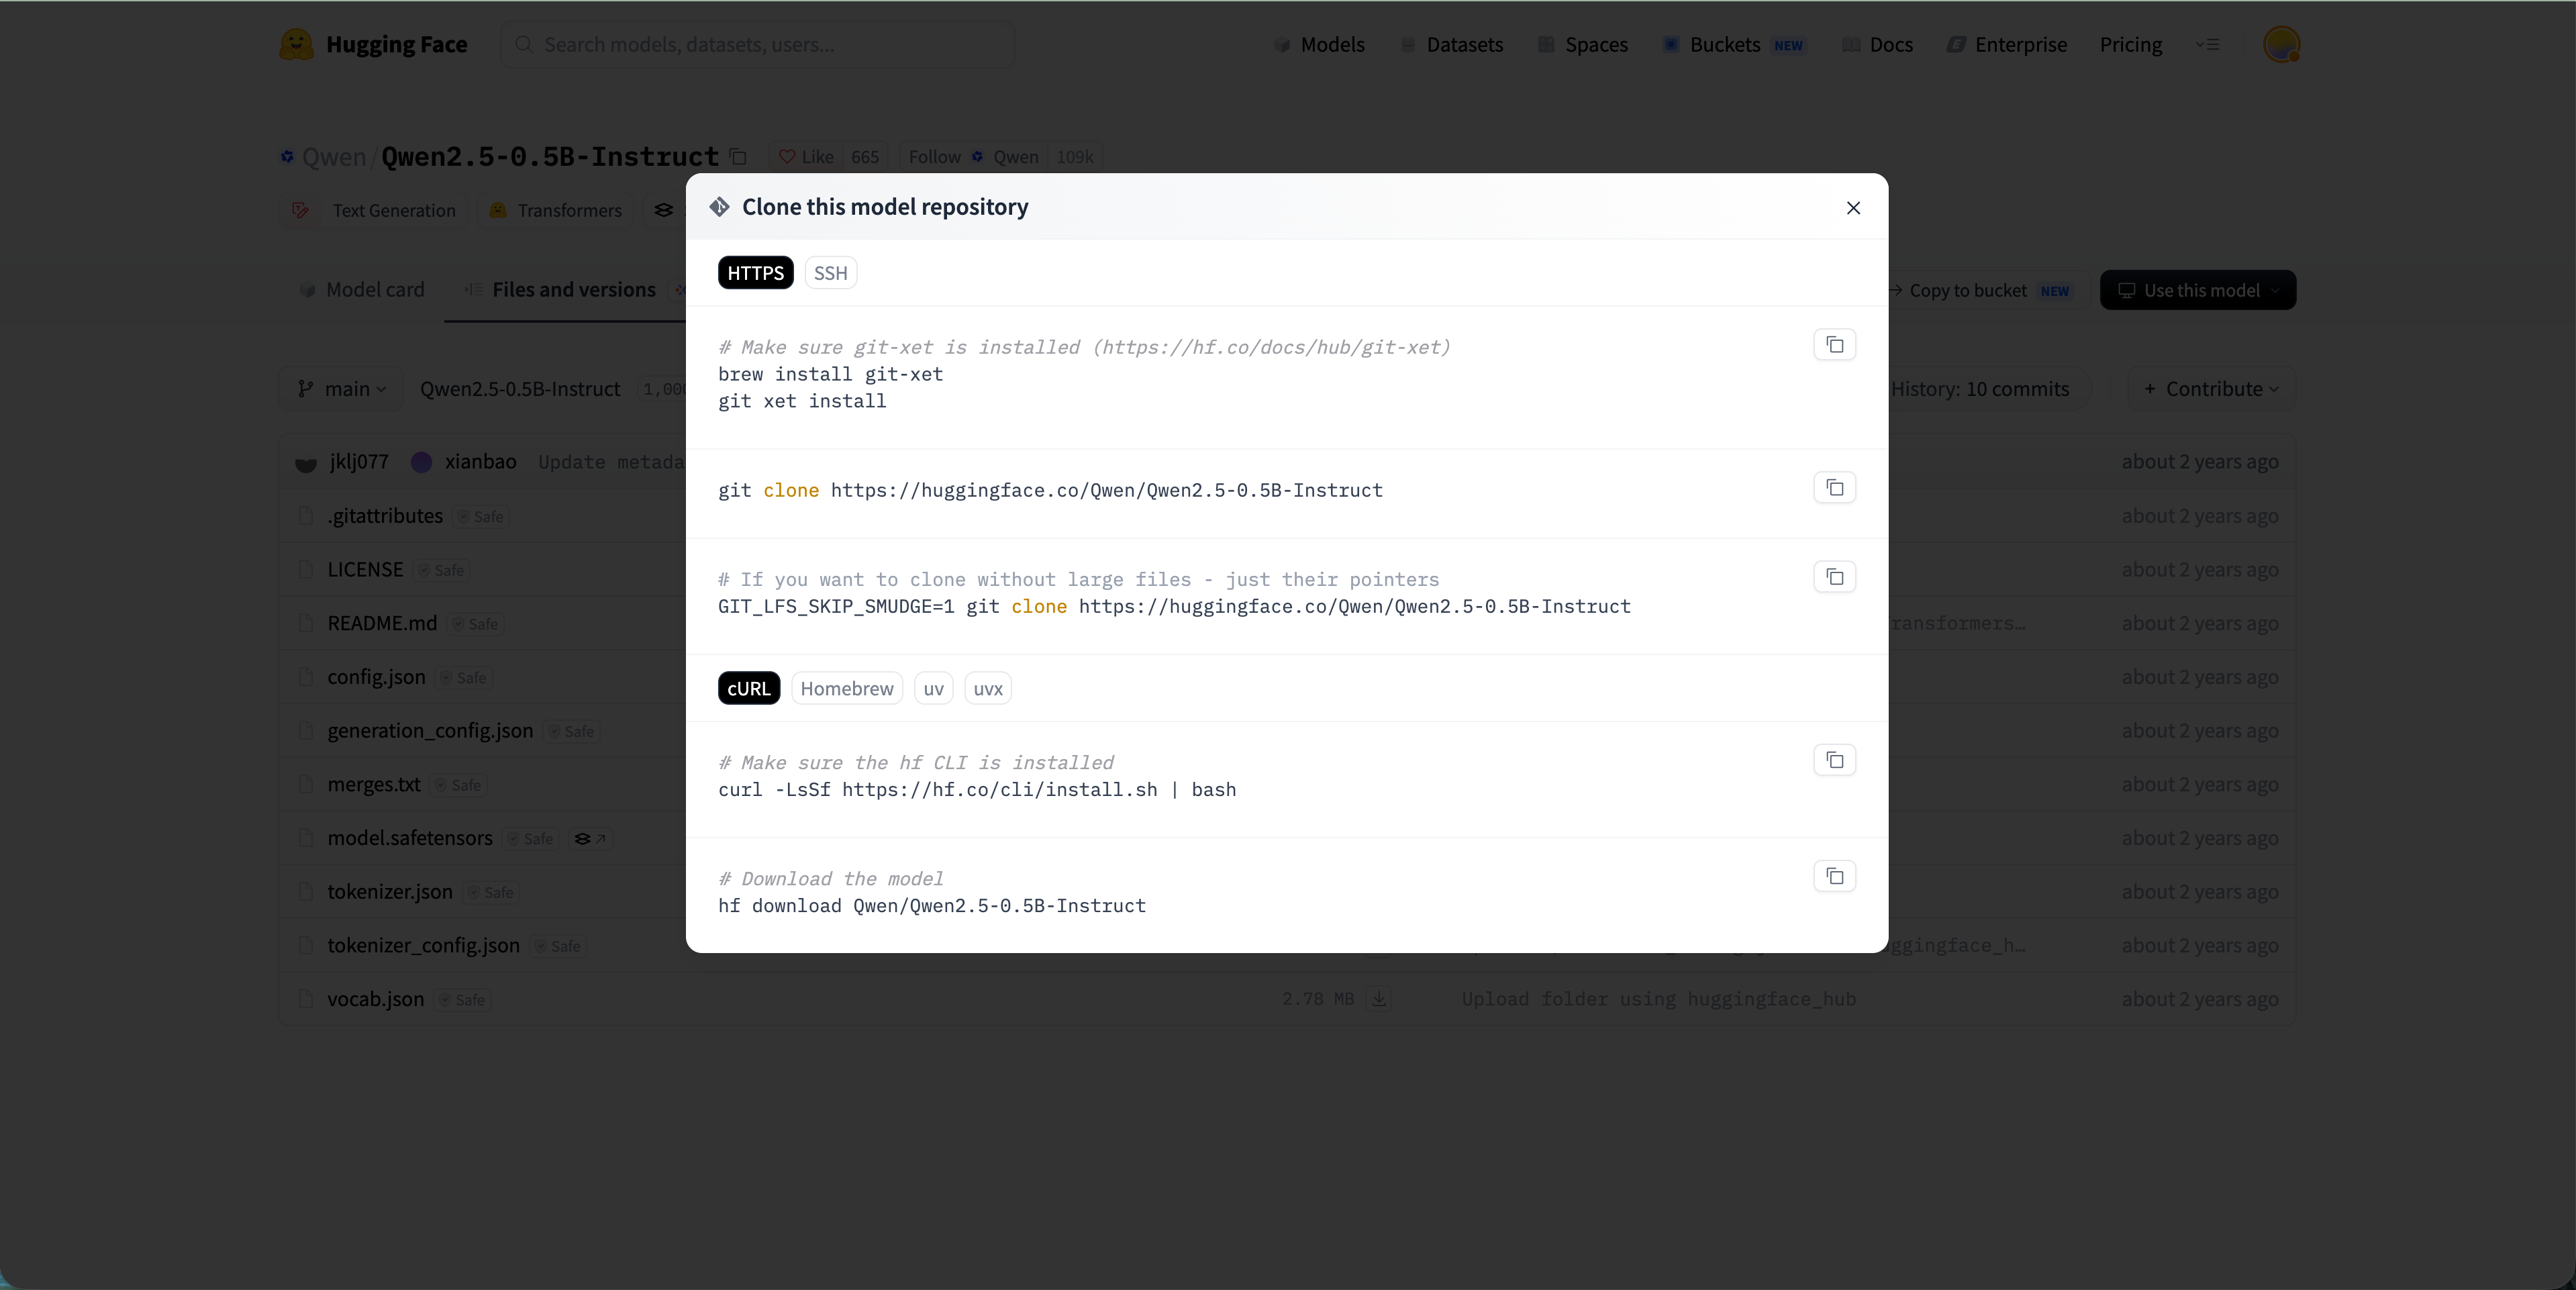
先安装依赖:
1 | pip install -U torch transformers huggingface_hub safetensors |
推荐使用 Hugging Face 官方 Python SDK 下载完整仓库,而不是逐个下载文件:
1 | from huggingface_hub import snapshot_download |
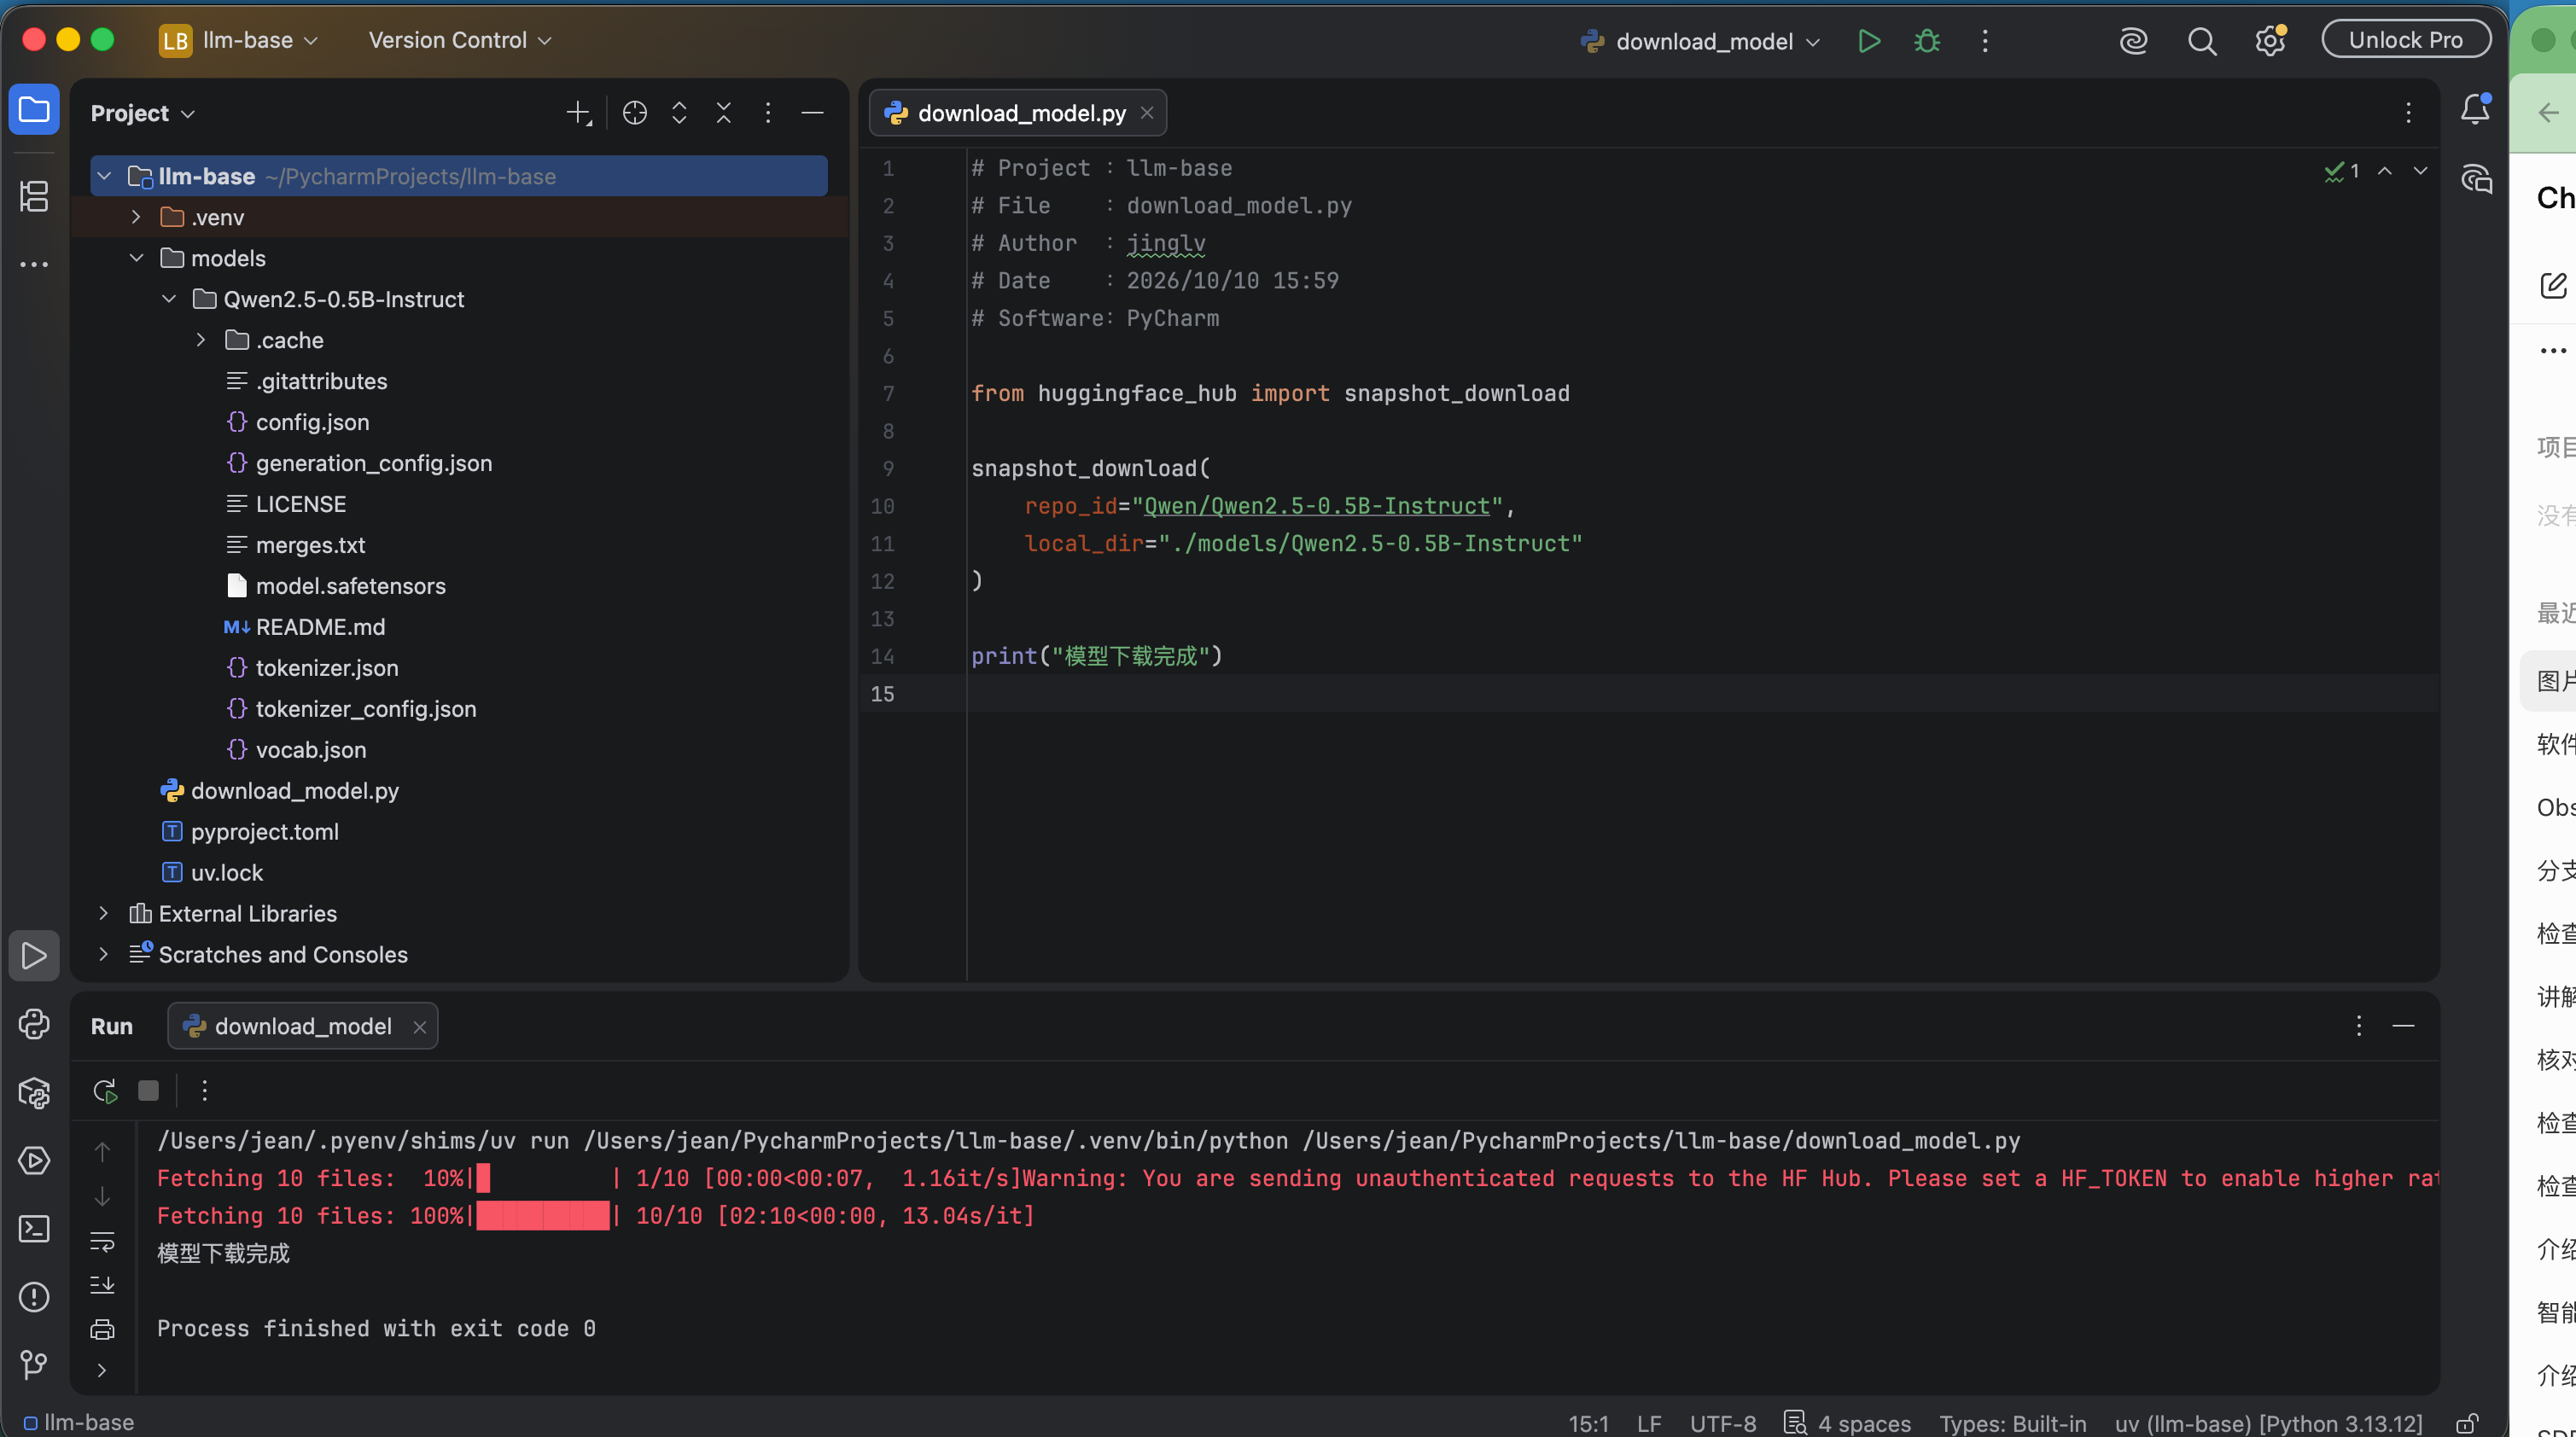
然后编写本地推理程序:
1 | # Project :llm-base |
执行结果如下:
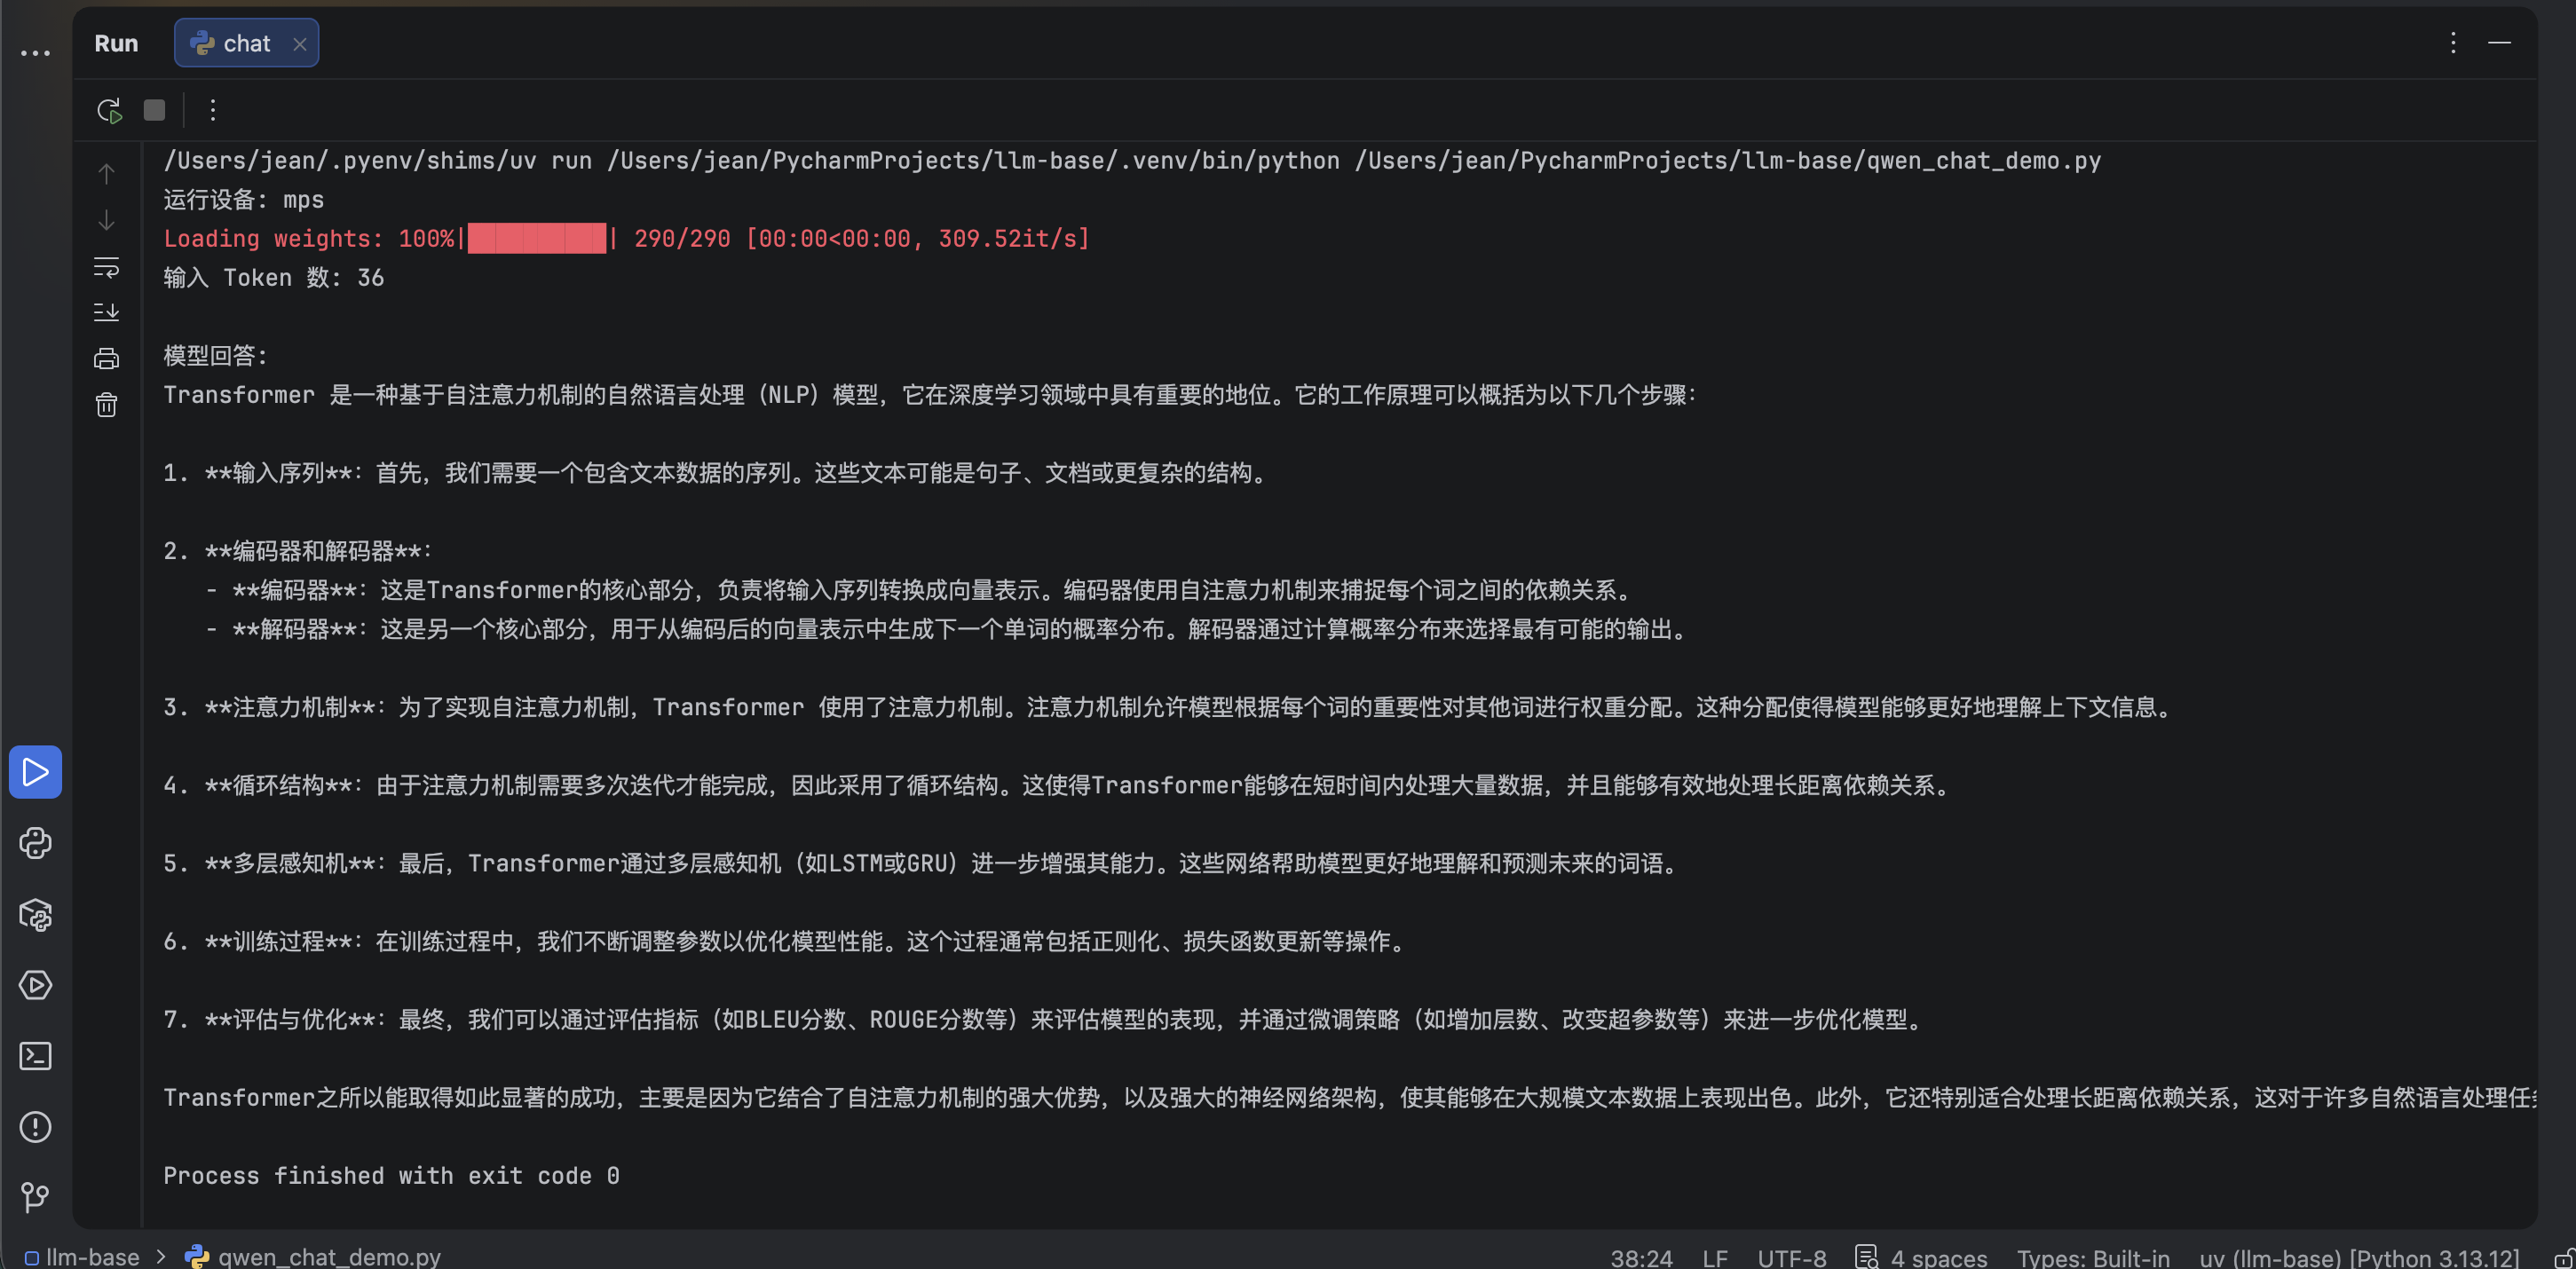
至此,我们已经完成了从消息格式化、Token 化、模型生成到文本解码的完整流程。这个示例只有一轮对话;如果要支持多轮对话,需要把此前的 user 和 assistant 消息依次加入 messages,并注意上下文窗口、生成延迟和内存占用。
小结
大语言模型的生成过程可以概括为:将文本编码为 Token,通过 Transformer 计算上下文表示,得到下一个 Token 的预测分数,再使用解码策略反复选择 Token。模型虽然表现出问答、写作、编程和一定的推理能力,但生成概率不等于事实正确率;在真实应用中,仍需配合检索、工具调用、结果验证和安全控制等机制。