上下文窗口与 KV Cache:模型如何记住前文并高效生成?
在上一篇文章中,我们了解了模型如何通过 Logits、Softmax 和解码策略选择下一个 Token。
不过,生成下一个 Token 时,模型不能只看最后一个词。它还需要参考 System Message、历史对话、当前问题以及已经生成的内容。例如:
1 | 用户:小明把钥匙放进了抽屉。 |
要回答“抽屉里”,模型必须能够利用前面的信息。这就引出了两个重要概念:
- 上下文窗口(Context Window):本次推理中,模型最多能够处理多少 Token;
- KV Cache:生成过程中缓存历史 Token 的注意力 Key 和 Value,避免每一步重复计算。
它们都与“前文”有关,但解决的是两个完全不同的问题:
上下文窗口决定模型最多能看多少内容;KV Cache 决定模型重复使用这些内容时能有多高效。
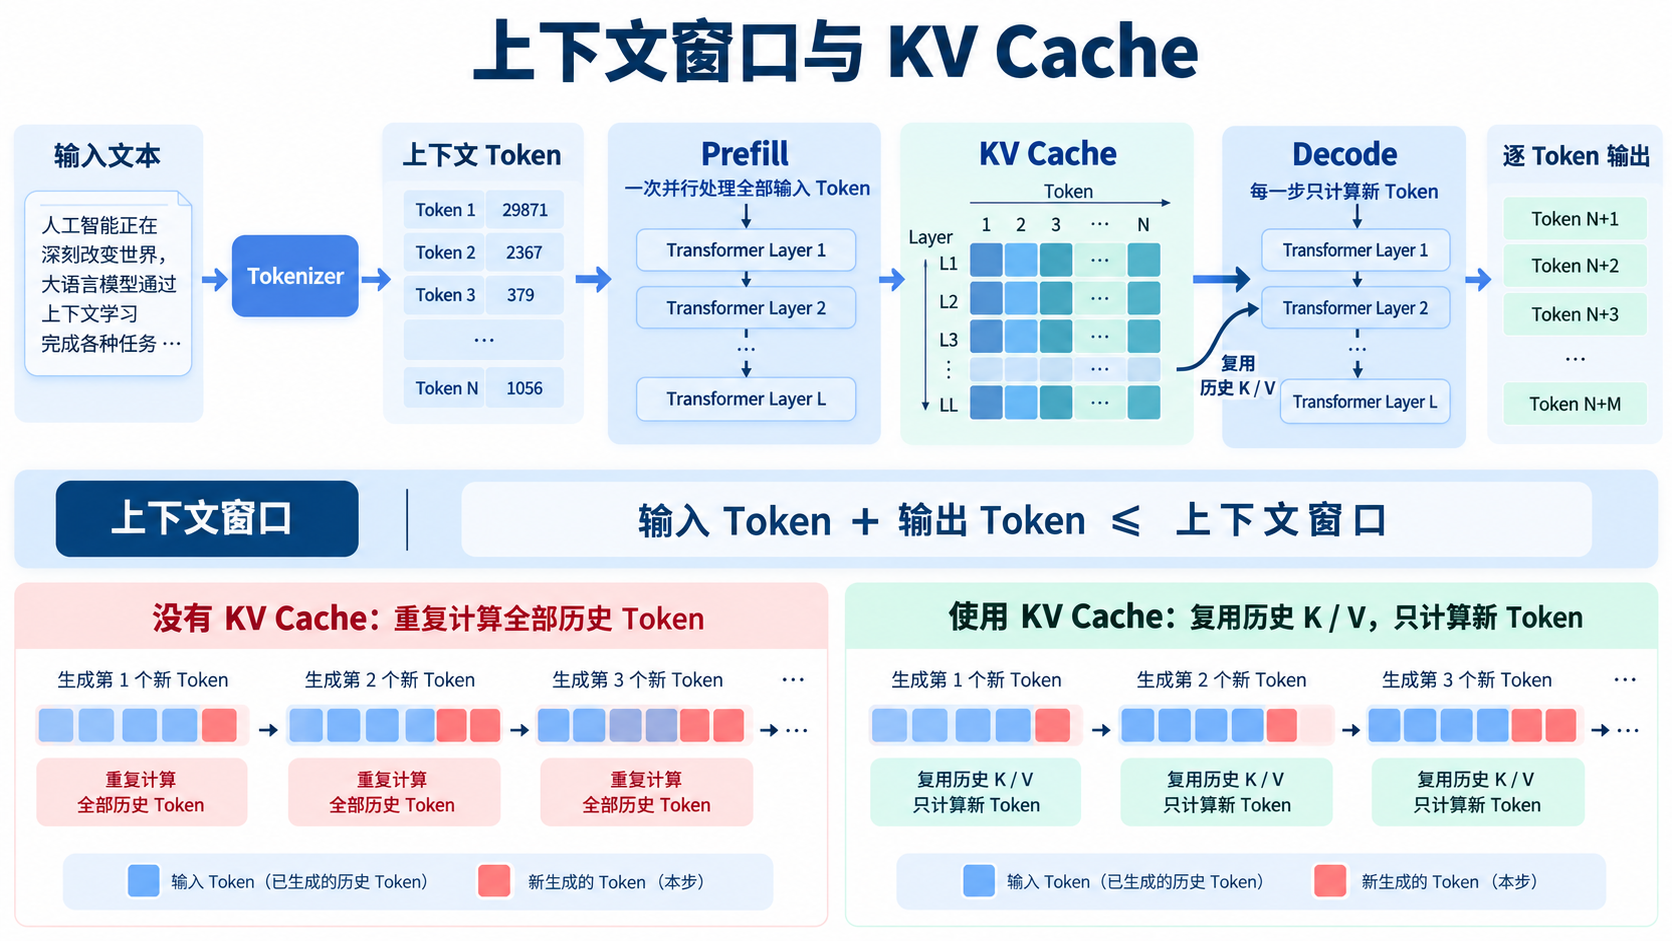
先理解四个核心概念
| 概念 | 核心含义 | 解决的问题 |
|---|---|---|
| Context Window | 一次推理允许使用的最大 Token 范围 | 模型最多能看到多少内容 |
| Prefill | 一次处理输入上下文,并建立初始 KV Cache | 理解 Prompt,准备生成第一个 Token |
| Decode | 每次生成一个新 Token | 逐步完成回答 |
| KV Cache | 保存各层历史 Token 的 Key 和 Value | 避免 Decode 时重复计算历史 K/V |
一次典型请求可以简化为:
1 | Prompt 与历史消息 |
什么是上下文窗口?
上下文窗口是模型在一次推理中能够处理的 Token 总量上限。
如果某个模型的上下文窗口为 8,192 Token,可以先近似理解为:
1 | 输入 Token 数 + 输出 Token 数 ≤ 8,192 |
这里的输入不只有用户刚刚输入的问题,还可能包括:
1 | System Message |
输出则包括模型已经生成和即将生成的 Token。
一个具体例子
假设模型的上下文窗口是 8,192 Token:
| 内容 | Token 数量 |
|---|---|
| System Message | 300 |
| 历史对话 | 2,500 |
| RAG 检索内容 | 3,000 |
| 当前问题 | 200 |
| Chat Template 等额外内容 | 100 |
| 输入合计 | 6,100 |
理论上还剩:
1 | 8,192 - 6,100 = 2,092 Token |
如果请求中又设置:
1 | max_new_tokens = 3,000 |
输入与最大输出之和就可能超过模型允许的范围。不同框架可能报错、缩短输出,或者按照指定策略截断输入。
需要注意,部分 API 会分别公布最大输入长度和最大输出长度,实际限制应以具体模型和服务文档为准,不能只套用一个加法公式。
Token 数量不等于字数
上下文窗口按 Token 计算,不按汉字数、单词数或文件大小计算。
1 | 同一段文字 |
因此,“支持 128K 上下文”表示大约支持 128K Token,并不等于固定支持 128K 个汉字或英文单词。
超出上下文窗口会怎样?
常见处理方式包括:
| 处理方式 | 行为 | 风险 |
|---|---|---|
| 直接报错 | 拒绝超长请求 | 调用失败 |
| 从左侧截断 | 删除最早的 Token | System 或关键历史可能丢失 |
| 从右侧截断 | 删除输入尾部 Token | 当前问题可能不完整 |
| 保留首尾 | 留下开头规则和最新消息 | 中间信息可能丢失 |
| 摘要压缩 | 将旧历史总结后再输入 | 摘要可能遗漏细节 |
| RAG 检索 | 只加入与问题相关的片段 | 取决于检索质量 |
截断是一种应用层策略,不是模型突然获得了额外空间。生产系统应明确决定哪些内容可以删除,不能盲目依赖 Tokenizer 的默认截断。
上下文窗口不是长期记忆
这是最常见的误解之一。
模型能够在当前请求里引用前文,并不意味着它已经把对话永久保存进参数。对普通无状态 API 而言,下一次请求通常仍需要再次提交相关历史:
1 | 第一次请求:[System] + [问题 A] |
如果第二次请求只发送“问题 B”,模型未必知道前面讨论过什么。
可以把几个概念区分开:
| 名称 | 保存在哪里 | 生命周期 | 是否改变模型参数 |
|---|---|---|---|
| Context | 本次请求的 Token 序列 | 通常到请求结束 | 否 |
| KV Cache | 推理引擎的内存或显存 | 通常到序列结束或缓存被回收 | 否 |
| 对话数据库 | 应用自己的存储系统 | 由应用决定 | 否 |
| 模型参数 | 权重文件 | 训练后长期存在 | 是,只有训练才会更新 |
因此:
上下文窗口是模型的“工作台大小”,不是永久记忆容量;KV Cache 是计算缓存,也不是聊天记录数据库。
为什么生成会分成 Prefill 和 Decode?
大语言模型的在线推理通常分成两个阶段。
Prefill:处理输入
Prefill 也叫 Prompt Processing。模型一次接收 Prompt 中的多个 Token,通过 Transformer 的所有层进行计算:
1 | [Token 1, Token 2, ..., Token N] |
这一阶段可以并行处理多个输入 Token,但自注意力需要建立它们之间的关系。输入越长,Prefill 的计算量和首 Token 等待时间通常越大。
衡量 Prefill 用户体验时,经常使用:
1 | TTFT = Time To First Token |
也就是从请求发出到看见第一个输出 Token 的时间。
Decode:逐 Token 生成
得到第一个输出 Token 后,模型进入 Decode 阶段:
1 | 生成 Token N+1 |
自回归模型必须等上一个 Token 生成后,才能确定下一步输入,所以同一条序列的 Decode 主要是串行过程。
衡量 Decode 速度时,常见指标包括:
- 每秒生成 Token 数(Tokens/s);
- 相邻输出 Token 的时间间隔(Inter-Token Latency,ITL)。
两个阶段的差异
| 对比项 | Prefill | Decode |
|---|---|---|
| 输入规模 | 一批 Prompt Token | 每一步通常 1 个新 Token |
| 并行程度 | Token 维度可较充分并行 | 单条序列逐步生成 |
| 主要体验指标 | TTFT | Tokens/s、ITL |
| KV Cache 行为 | 创建并填充 | 读取历史缓存并追加新 K/V |
| 典型瓶颈 | 长 Prompt 的计算 | 内存带宽、缓存访问和逐步调度 |
Attention 中的 Q、K、V
要理解 KV Cache,先回顾 Self-Attention。
每一层会把当前隐藏状态分别投影成:
1 | Q = Query |
简化后的注意力公式为:
1 | Attention(Q, K, V) |
可以直观地理解为:
- Query 表示当前位置正在寻找什么信息;
- Key 表示每个历史位置可以用什么特征被匹配;
- Value 表示匹配到该位置后实际取回的内容表示。
例如生成新 Token 时,新 Token 的 Query 会与所有可见历史 Token 的 Key 计算相关性,再用相关性权重聚合对应的 Value。
为什么只缓存 K 和 V?
在 Causal Language Model 中,过去的 Token 不能看未来。因此,已经处理过的历史 Token,其 K 和 V 不会因为后面又生成了新 Token 而改变。
生成第 t 个 Token 时,需要:
1 | Q_t |
生成第 t+1 个 Token 时,过去的 K/V 仍然可以直接使用:
1 | 新计算:Q_(t+1), K_(t+1), V_(t+1) |
当前 Query 用完即可,下一步会根据新的隐藏状态产生新的 Query,所以通常没有必要保存所有历史 Query。这就是它叫 KV Cache,而不是 QKV Cache 的原因。
没有 KV Cache 会发生什么?
假设 Prompt 有 4 个 Token,正在继续生成:
1 | 输入:[A, B, C, D] |
没有缓存时:
1 | 生成 E:重新计算 [A, B, C, D] |
大量历史 Token 的 K/V 投影会被重复计算。
使用 KV Cache 后:
1 | Prefill:计算并保存 A、B、C、D 的 K/V |
因此 KV Cache 用更多内存换取更少的重复计算。
一个容易说错的地方
KV Cache 并没有让每一步 Attention 变成常数复杂度。
生成新 Token 时,新 Query 仍需与可见范围内所有历史 Key 计算注意力,并读取对应 Value。历史越长,本步需要读取的数据通常越多。
KV Cache 省掉的是:
- 历史 Token 在各层重新产生 K/V 的计算;
- 历史部分大量重复的 Transformer 前向计算。
它没有消除新 Token 对历史上下文的 Attention 访问。
KV Cache 中到底保存了什么?
对于普通 Decoder-only Transformer,每一层通常都有一组 Key Cache 和 Value Cache:
1 | Layer 0: K_cache, V_cache |
一种常见的张量形状是:
1 | [batch_size, num_key_value_heads, sequence_length, head_dim] |
其中:
batch_size:同时处理的序列数量;num_key_value_heads:Key/Value Head 的数量;sequence_length:当前缓存的 Token 数量;head_dim:每个 Head 的维度。
模型实现不同,维度顺序也可能不同,不能假设所有框架都采用完全相同的布局。
MHA、MQA 和 GQA 对缓存的影响
| Attention 类型 | Query Head | KV Head | KV Cache 特点 |
|---|---|---|---|
| MHA | 多个 | 通常与 Query Head 数相同 | 缓存较大 |
| MQA | 多个 | 通常只有 1 个 | 缓存显著减小 |
| GQA | 多个 | 少于 Query Head、但多于 1 个 | 在质量和效率之间折中 |
现在很多 LLM 使用 GQA,原因之一就是它可以减少 KV Cache 的容量和读取带宽。估算缓存时应读取 num_key_value_heads,不能总是直接使用 num_attention_heads。
如何估算 KV Cache 显存?
对标准全注意力 Decoder,可以使用下面的近似公式:
1 | KV Cache Bytes |
公式中的 2 代表 Key 和 Value 两份缓存。
如果使用 Beam Search,还需要考虑 Beam 数;推理框架的内存对齐、分页和元数据也可能带来额外开销。因此这是理论近似值,不等于进程最终显存占用。
示例:估算一个 GQA 模型
假设模型配置为:
1 | Layers = 28 |
那么:
1 | KV Cache |
这还只是单条序列的 KV Cache,不包括:
- 模型权重;
- 临时激活值;
- CUDA Kernel 工作区;
- Logits 和采样状态;
- 推理框架自身开销。
当 Batch Size、并发请求数或上下文长度增加时,KV Cache 很容易成为推理服务的主要显存消费者。
上下文窗口与 KV Cache 的关系
两者相关,但不能互相替代:
| 问题 | 上下文窗口 | KV Cache |
|---|---|---|
| 决定能处理多少 Token | 是 | 否 |
| 加速自回归生成 | 否 | 是 |
| 占用额外显存 | 间接相关 | 是 |
| 保存模型知识 | 否 | 否 |
| 请求结束后必须永久保留 | 否 | 否 |
上下文越长,通常需要缓存的 K/V 越多:
1 | 更长的上下文窗口 |
但增加 KV Cache 容量不会让一个原本只支持 8K 的模型自动变成 128K 模型。模型的位置编码、训练长度、注意力实现和服务限制也需要支持长上下文。
为什么“支持 128K”不等于“128K 都能用好”?
上下文窗口描述的是可接收范围,不保证模型能同等有效地使用窗口中的每一处信息。
长上下文能力还受到以下因素影响:
- 模型是否在足够长的数据上训练或继续训练;
- 位置编码及其扩展方式;
- 重要信息在上下文中的位置;
- 无关信息对注意力的干扰;
- 推理精度和缓存量化;
- 任务是否需要跨很远位置组合信息。
因此可能出现:
1 | 请求没有超出长度限制 |
应用仍应通过检索、重排、摘要和明确的 Prompt 结构减少无关内容,而不是把所有资料都塞进上下文。
常见 KV Cache 优化方式
Dynamic Cache
Dynamic Cache 随生成长度逐步增长:
1 | 长度 100 → 缓存 100 个位置 |
它使用灵活,也是 Transformers 中许多模型的默认缓存方式,但不断变化的张量形状可能不利于某些编译优化。
Static Cache
Static Cache 预先分配最大缓存空间:
1 | 预先分配 4,096 个位置 |
固定形状更适合 torch.compile 或某些硬件编译器,但短请求可能浪费已分配空间。
Sliding Window Attention
滑动窗口注意力只让某些层关注最近固定数量的 Token:
1 | 完整历史:[1, 2, 3, ..., 8,191, 8,192] |
当缓存达到窗口长度后,相关层不再无限增长。这样可以控制计算和显存,但窗口之外的信息无法被这些局部注意力层直接访问。部分模型会混合全局注意力层与滑动窗口层,具体行为取决于模型架构。
Quantized Cache
缓存量化把 FP16/BF16 的 K/V 压缩为更低位宽:
1 | BF16 KV Cache |
它更适合显存紧张的长上下文场景。短上下文时,量化和反量化开销可能反而降低速度。
Offloaded Cache
缓存卸载把部分 KV Cache 移到 CPU 内存,需要使用时再传回 GPU。
优点是节省 GPU 显存,代价是增加 CPU-GPU 数据传输,吞吐和延迟可能变差。
Paged KV Cache
在线推理服务中的请求长度各不相同。如果为每条请求预留一大块连续显存,容易出现浪费和碎片。
Paged KV Cache 将缓存拆成固定大小的 Block,并通过映射表组织逻辑上连续、物理上可以不连续的缓存:
1 | 请求的逻辑 Token: [0 ... 15] [16 ... 31] [32 ... 47] |
这类设计便于动态增长、回收和共享缓存块,是 vLLM 等高吞吐推理系统的重要思想。
Prefix Caching
如果多个请求拥有完全相同的 Token 前缀,可以复用该前缀已经计算好的 KV Cache:
1 | 共同前缀:相同的 System Prompt + 相同的长文档 |
这和单次生成中的 KV Cache 有区别:
- 普通 KV Cache 复用同一序列已经处理过的历史 Token;
- Prefix Caching 尝试在多个请求或多次生成之间复用相同前缀。
只有 Token ID 序列以及影响其计算的模型配置一致时,缓存才可以安全复用。仅仅“文字看起来差不多”并不够。
多轮对话中的 KV Cache
多轮聊天看起来天然适合复用缓存,但实际实现需要谨慎。
第一轮:
1 | [System] [User A] [Assistant A] |
第二轮加入:
1 | [System] [User A] [Assistant A] [User B] |
如果前缀完全一致,理论上可以保留第一轮的缓存,只计算新增的 [User B]。但如果应用重新渲染 Chat Template、修改 System Message、截断旧消息,或者在历史中间插入工具结果,原有缓存就可能不再对应新的 Token 序列。
因此:
能保存对话文本,不代表一定能直接复用上一次 KV Cache;缓存复用要求 Token 级前缀一致。
实战一:计算输入占用了多少上下文
下面使用 Tokenizer 统计一组聊天消息的实际 Token 数。
1 | from transformers import AutoTokenizer |
这段代码同时统计了角色标记、消息边界和生成起始标记,因此比直接对用户问题调用 tokenizer() 更接近模型真实接收的输入。
实战二:观察 KV Cache 的形状和增长
下面手动执行一次 Prefill,再生成一个 Token,观察 Cache Sequence Length 如何变化。
1 | import torch |
预期可以观察到:
1 | Prefill 后缓存长度 = Prompt Token 数 |
这里传给 Decode 的 input_ids 只有刚生成的一个 Token,而不是完整 Prompt。这正是 KV Cache 发挥作用的地方。
实战三:验证有无缓存生成结果一致
KV Cache 是推理优化,不应该改变相同解码条件下的模型语义。下面使用 Greedy Decoding 对比两次输出:
1 | import time |
在 Greedy、相同硬件和相同数值条件下,两组 Token 通常相同。耗时差异会受到设备、输入长度、输出长度、Transformers 版本和计时误差影响;Prompt 和输出太短时,缓存管理开销甚至可能掩盖收益,所以不要把单次运行当作严谨 Benchmark。
实战四:通用 KV Cache 容量计算器
下面的脚本不需要下载模型,可以直接计算理论缓存大小:
1 | def estimate_kv_cache_gib( |
输出为:
1 | 理论 KV Cache:1.75 GiB |
如果想读取本地模型配置自动计算,可以使用:
1 | from transformers import AutoConfig |
常见误区
误区一:上下文窗口就是模型的长期记忆
上下文只在当前推理中参与计算。是否长期保存用户信息,取决于应用是否使用数据库、摘要、向量检索或其他记忆系统。
误区二:KV Cache 保存了原始聊天文本
KV Cache 保存的是各层 Attention 所需的数值张量,不是可以直接阅读的聊天记录。应用仍需保存原始消息,才能编辑、展示、检索或重新组织对话。
误区三:KV Cache 会修改模型参数
KV Cache 只保存本次推理的中间计算结果,不会执行反向传播,也不会更新模型权重。
误区四:KV Cache 越大,模型能力越强
缓存只能减少重复计算。它不能增加模型知识,也不能突破模型架构和服务规定的上下文上限。
误区五:使用 KV Cache 后,每个新 Token 都是 O(1)
历史 K/V 不需要重新计算,但新 Query 通常仍要与可见的历史 Key 做 Attention,并读取历史 Value。上下文越长,Decode 单步成本通常仍会增加。
误区六:上下文没有超限,模型就不会忘记
信息位于允许窗口内,只表示模型能够接收它,不保证模型一定准确关注、检索和利用它。
误区七:多轮对话一定会自动复用 KV Cache
很多 API 每轮都会重新提交并计算完整历史。跨轮缓存是否存在、缓存多久以及是否计费,由具体服务决定。
误区八:相同文字一定可以复用 Prefix Cache
缓存复用需要 Token 序列和相关计算条件一致。Chat Template、空格、特殊 Token 或 System Message 的变化,都可能让前缀不再相同。
误区九:KV Cache 应该在训练时使用
训练通常需要并行计算完整序列并保存反向传播所需状态,KV Cache 主要面向自回归推理。训练时错误启用缓存可能造成结果或梯度问题。
工程实践建议
- 在发送请求前用对应 Tokenizer 统计完整 Chat Template 的 Token 数;
- 为输出预留空间,不要让输入占满整个上下文窗口;
- 明确历史截断、摘要和 RAG 资料选择策略;
- 根据
num_key_value_heads而不是只看 Attention Head 数估算缓存; - 并发容量规划时同时计算模型权重和每个活跃请求的 KV Cache;
- 短请求优先使用默认 Dynamic Cache,不必过早优化;
- 形状固定且需要编译加速时,再评估 Static Cache;
- 显存不足时评估滑动窗口、缓存量化或 CPU Offload 的质量与延迟代价;
- 大规模在线服务可以使用 Paged KV Cache、Continuous Batching 和 Prefix Caching;
- Benchmark 应区分 TTFT、ITL、吞吐量和最大并发数,不能只看一次请求的总耗时。
小结
本文的核心结论可以总结为:
- 上下文窗口限制一次推理能够容纳的 Token 总量;
- 输入中还包括 System、历史消息、工具结果、检索资料和 Chat Template;
- 上下文窗口是工作空间,不是模型的长期记忆;
- Prefill 处理完整输入并建立初始 KV Cache;
- Decode 复用历史 K/V,每一步只为新 Token 追加缓存;
- KV Cache 避免重复计算历史 K/V,但不会消除新 Token 对历史的 Attention;
- KV Cache 容量随层数、序列长度、Batch、KV Head 数和数据精度增长;
- MQA 和 GQA 可以通过减少 KV Head 降低缓存开销;
- Dynamic、Static、Sliding Window、Quantized、Offloaded 和 Paged Cache 各有不同取舍;
- KV Cache 不增加模型知识,也不能突破模型本身的上下文限制。
理解 Context Window 和 KV Cache 后,我们就能解释几个常见现象:为什么长 Prompt 的首字等待更久、为什么长对话越来越占显存、为什么高并发推理需要精细管理缓存,以及为什么“支持更长上下文”通常伴随着更高的推理成本。