LLM 对齐:SFT、RLHF、PPO 与 DPO
在上一篇文章中,我们了解了 LLM 从数据准备、预训练到后训练的整体过程。
预训练让模型学会预测下一个 Token,并获得语言、知识和部分推理能力。但“会生成文本”并不等于“会按照用户意图完成任务”。一个基础模型可能:
- 把问题继续补写成更多问题;
- 模仿网页、论坛或小说的写作方式;
- 不稳定地遵循 System Message;
- 在信息不足时继续猜测;
- 输出有害、偏见或不符合产品要求的内容;
- 无法判断什么样的回答更有帮助。
因此,还需要通过后训练塑造模型的交互行为。这个过程通常被称为 Alignment,也就是模型对齐。
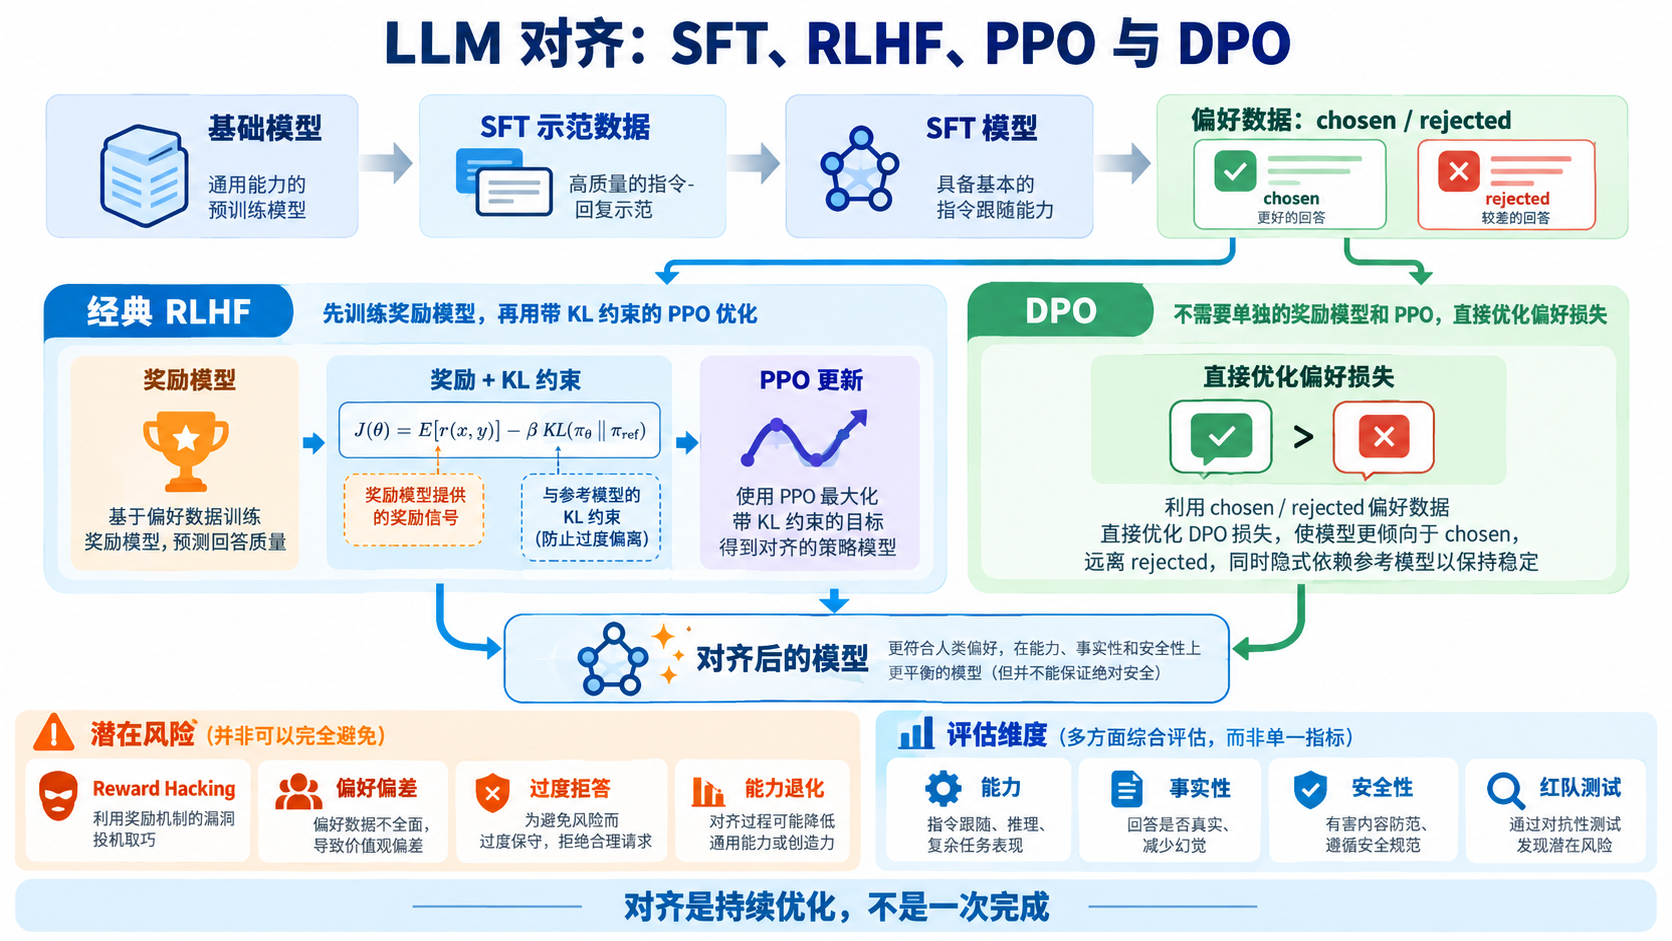
什么是模型对齐?
可以先使用一个工程化定义:
模型对齐是通过数据、训练目标、评测和部署约束,使模型行为更加符合明确规定的人类意图、产品目标和安全要求。
这里有三个关键词。
行为
对齐主要改变模型如何使用已有能力:
1 | 是否遵循指令 |
明确规定
“符合人类价值”听起来很完整,实际上非常抽象。真实训练必须把目标落实到:
- 标注规范;
- 示例回答;
- 偏好比较;
- 安全政策;
- 宪法或原则列表;
- 自动验证器;
- 评测集和上线标准。
不同用户、文化、组织和应用场景的偏好可能互相冲突,因此不存在一份自动代表所有人的单一偏好数据。
持续过程
对齐不是训练一次就永久完成。新任务、新语言、越狱方法和部署环境都会暴露新的失败模式:
对齐是持续优化,不是一次完成。
1 | 定义目标 |
能力与行为不是一回事
假设基础模型已经具备总结文章的能力,但不一定知道用户希望它:
- 只输出三点;
- 使用中文;
- 保留关键数字;
- 不编造来源外信息;
- 信息不足时明确说明。
可以把两者粗略区分为:
| 维度 | 主要问题 | 主要来源 |
|---|---|---|
| Capability | 模型能不能完成任务 | 预训练、继续预训练、架构与规模 |
| Behavior | 模型是否以期望方式完成任务 | SFT、偏好优化、规则与部署控制 |
后训练有时也会提高任务能力,但它的数据和计算规模通常远小于预训练,更擅长让已有能力变得容易调用、格式稳定和符合产品要求。
一条经典对齐路线
InstructGPT 展示了一条影响深远的经典路线:
1 | 预训练基础模型 |
这条路线经常被简称为 RLHF,但需要注意:
- SFT 是进入 RLHF 前的重要起点;
- 人类通常不直接为每个 Token 提供奖励,而是比较完整回答;
- 奖励模型只是人类偏好的近似代理;
- PPO 是优化策略的一种方法,不等于 RLHF 的定义;
- DPO 等方法可以不训练显式奖励模型,也不运行在线 PPO 循环。
第一阶段:SFT
SFT 是 Supervised Fine-Tuning,也就是监督微调。
SFT 数据是什么?
最基本的数据形式是:
1 | Instruction / Prompt → Ideal Response |
聊天模型通常使用结构化消息:
1 | { |
示范回答可能来自:
- 人类专家编写;
- 规则和模板生成;
- 更强模型生成后由人类筛选;
- 真实用户交互经过清洗和授权后构造;
- 多个候选回答经过拒绝采样后保留较好样本。
SFT 在优化什么?
SFT 仍然使用 Token 级交叉熵:
1 | L_SFT = -Σ log πθ(y_t | x, y_<t) |
其中:
x是 Prompt;y是目标回答;πθ是正在训练的模型;- 每一步都提高目标回答中真实下一个 Token 的概率。
常见做法是只对 Assistant Token 计算损失:
1 | System Token → label = -100 |
但这属于训练配方,而不是 SFT 的强制定义。有些系统会训练多个 Assistant Turn、完整序列,或者为不同 Token 设置权重。
SFT 学到了什么?
SFT 可以帮助模型学习:
- 对话角色和 Chat Template;
- 指令遵循;
- 回答格式;
- 任务边界;
- 示例中的表达风格;
- 常见拒答方式;
- 工具调用的序列格式。
SFT 的局限
一个 Prompt 可能有多个高质量答案,但 SFT 通常只提供一个或少数示范:
1 | 问题:怎样解释递归? |
如果三种回答都合理,单纯模仿一个目标序列不能完整表达“哪个回答更好,以及好多少”。这正是偏好数据希望补充的信息。
第二阶段:偏好数据
偏好数据通常针对同一个 Prompt 比较多个候选回答:
1 | Prompt:解释地球为什么有四季。 |
常见结构为:
1 | (prompt, chosen, rejected) |
chosen:标注者更偏好的回答;rejected:相对较差的回答。
偏好标准从哪里来?
标注者不能只凭模糊感觉判断,通常需要明确 Rubric:
| 维度 | 示例问题 |
|---|---|
| 正确性 | 是否包含事实、计算或逻辑错误? |
| 相关性 | 是否直接回答用户问题? |
| 完整性 | 是否遗漏关键条件? |
| 指令遵循 | 是否满足格式、语言和长度要求? |
| 表达质量 | 是否清晰、简洁、无不必要重复? |
| 安全性 | 是否提供不应提供的危险指导? |
| 诚实性 | 信息不足时是否承认不确定? |
偏好数据并不等于客观真理
偏好标签可能受到以下因素影响:
- 标注者知识不足;
- 标注规范含糊;
- 不同价值观和文化背景;
- 更长回答看起来更全面;
- 自信语气被误认为更正确;
- 两个候选都很差;
- 两个候选差异过小;
- 候选回答来自过窄的策略分布。
因此要记录标注者一致性、处理平局与跳过样本,并对不同人群和任务分别评测。
第三阶段:奖励模型
经典 RLHF 不会在每次 PPO 更新时实时询问人类,而是先把偏好数据训练成 Reward Model。
奖励模型做什么?
奖励模型读取 Prompt 与回答,并输出一个标量:
1 | rφ(x, y) → 一个实数分数 |
分数越高,表示奖励模型认为该回答越符合训练偏好。
奖励分数不是:
- 事实正确率;
- 安全概率;
- 用户满意度百分比;
- 不同奖励模型之间可直接比较的绝对单位。
它主要用于同一训练体系中的相对比较。
Bradley–Terry 成对损失
给定 chosen 和 rejected,常见损失为:
1 | L_RM = -log σ(r_chosen - r_rejected) |
如果:
1 | r_chosen >> r_rejected |
损失较小;如果奖励模型把 rejected 评得更高,损失就会变大。
奖励模型训练完成后,可以对新的 Prompt—回答组合评分,但它只能泛化偏好数据中的规律,也可能被策略模型找到漏洞。
RLHF 中什么是强化学习?
在语言模型中,可以把生成过程映射为强化学习问题:
| 强化学习概念 | LLM 中的对应内容 |
|---|---|
| State | Prompt 加已经生成的 Token |
| Action | 选择下一个 Token |
| Policy | 语言模型 πθ |
| Trajectory | 一段完整回答 |
| Reward | 奖励模型、规则或验证器给出的分数 |
策略模型生成一个 Token 后,状态发生变化,再继续生成下一个 Token。完整回答结束后,奖励模型通常给出序列级分数。
这会带来 Credit Assignment 问题:一个最终分数需要指导前面很多 Token 的选择。Value Model、Return 和 Advantage 就是为了解决这种优化问题。
RLHF 中的四个模型角色
经典 PPO-RLHF 通常涉及:
| 组件 | 是否更新 | 作用 |
|---|---|---|
| Policy Model | 是 | 生成回答,是最终要优化的模型 |
| Reference Model | 否 | 提供原始策略基线,计算 KL 约束 |
| Reward Model | 否 | 对回答给出偏好奖励 |
| Value Model / Critic | 是 | 估计期望回报,帮助计算 Advantage |
实际实现可能共享 Backbone 或 Value Head,也可能将组件分布到不同设备,但概念职责需要区分。
为什么需要 Reference Model 和 KL 约束?
如果只要求策略最大化奖励模型分数,它可能快速偏离自然语言分布,并利用奖励模型缺陷:
1 | max E[rφ(x, y)] |
因此常加入对参考模型的 KL 约束:
1 | max E[ |
直观理解:
1 | 奖励模型:朝更符合偏好的方向移动 |
生成样本上的每 Token KL 常用下面的 Log Probability 差异估计:
1 | log πθ(token | state) - log πref(token | state) |
沿回答 Token 累积后形成 KL 惩罚信号。这里展示的是常用采样估计直觉,具体框架还可能采用不同 KL 估计器和控制策略。
β 的作用
β 控制奖励优化与偏离参考模型之间的权衡:
- 约束太弱,策略可能大幅漂移并投机奖励;
- 约束太强,策略几乎无法从参考模型改善;
- 实际训练可能使用固定、调度或自适应 KL 系数。
Value、Return 与 Advantage
Value
Value Model 估计当前状态未来能获得多少回报:
1 | V(s_t) ≈ 从当前位置继续生成的期望回报 |
Return
Return 是从当前步骤开始累计的实际奖励。在 LLM RLHF 中,最终回答奖励可能只出现在最后,KL 惩罚则可以分布到每个生成 Token。
Advantage
Advantage 表示这次选择比当前基线好多少:
1 | A_t = Return_t - V(s_t) |
A_t > 0:该动作结果比预期好,应提高概率;A_t < 0:该动作结果比预期差,应降低概率。
实际 PPO 常使用 GAE(Generalized Advantage Estimation)在偏差与方差之间做权衡。
PPO 如何更新策略?
PPO 是 Proximal Policy Optimization。它的核心思想不是无限制地提高好回答概率,而是限制每次策略更新幅度。
概率比
对采样时选择的 Token,计算:
1 | ratio_t(θ) |
实现时通常使用 Log Probability:
1 | ratio_t = exp(logπθ - logπold) |
裁剪目标
PPO 的经典裁剪目标为:
1 | L_clip |
直观上:
- 如果某个 Token 的 Advantage 为正,提高它的概率;
- 如果 Advantage 为负,降低它的概率;
- 但概率变化超过裁剪范围后,不再继续获得同等优化收益。
这有助于避免单个训练批次让策略发生过大变化。
PPO-RLHF 训练循环
1 | 1. Policy 根据 Prompt 在线采样回答 |
为什么 PPO-RLHF 工程复杂?
训练时可能同时保存或运行多个大模型,还需要在线生成回答:
- Policy;
- Reference;
- Reward Model;
- Value Model;
- Rollout 数据;
- 每 Token Log Probability;
- Value、Return 和 Advantage。
此外还要处理可变长度、EOS、Padding、分布式生成、奖励归一化、KL 控制和训练不稳定,因此显存、通信和实现复杂度都很高。
什么是 DPO?
DPO 是 Direct Preference Optimization,也就是直接偏好优化。
它从与 KL 约束 RLHF 目标相关的推导出发,把偏好优化改写成一个直接作用于策略模型的分类式损失:
1 | 偏好数据 |
DPO 不需要:
- 单独训练显式 Reward Model;
- 在线采样 Rollout;
- Value Model;
- PPO 策略梯度循环。
但它通常仍需要一个冻结的 Reference Model,或者使用能隐式得到参考概率的实现技巧。
DPO 损失如何理解?
设:
x:Prompt;y_w:chosen,也就是 winner;y_l:rejected,也就是 loser;πθ:正在训练的策略;πref:参考模型。
DPO 常见损失为:
1 | L_DPO = -log σ( |
先定义相对参考模型的变化:
1 | chosen_relative |
DPO 希望:
1 | chosen_relative > rejected_relative |
也就是说,重点不只是让 chosen 的绝对概率变大,而是让 Policy 相对于 Reference 更偏向 chosen、远离 rejected。
β 不是普通学习率
DPO 中的 β 与参考策略约束和隐式奖励尺度有关。它会改变偏好 Margin 进入 Sigmoid 时的尺度,也会影响策略偏离参考模型的程度。
不能简单记成“β 越大,训练越强”。它与数据质量、学习率、模型能力和实现细节共同作用,需要通过验证集调优。
PPO-RLHF 与 DPO 对比
| 对比项 | PPO-RLHF | DPO |
|---|---|---|
| 偏好数据 | 需要 | 需要 |
| 显式奖励模型 | 通常需要 | 不需要 |
| Value Model | 通常需要 | 不需要 |
| 在线采样 | 需要 | 训练时通常不需要 |
| Reference Model | 通常需要 | 通常需要 |
| 优化方式 | 强化学习策略优化 | 离线偏好分类式损失 |
| 工程复杂度 | 高 | 相对较低 |
| 训练稳定性 | 对实现和超参数较敏感 | 通常更容易训练 |
| 奖励来源灵活性 | 可接入学习奖励和可验证奖励 | 主要依赖已有偏好对 |
| 数据分布 | 可随新 Policy 在线变化 | 通常固定为离线数据 |
DPO 更简单,不代表它在所有场景都优于 PPO:
- 离线偏好数据覆盖不足时,DPO 只能学习已有比较;
- 需要与环境交互或使用可验证奖励时,在线 RL 可能更合适;
- 两种方法都可能过拟合偏好数据;
- 最终选择应由数据、任务、计算资源和评测结果决定。
RLAIF 是另一种算法吗?
RLAIF 是 Reinforcement Learning from AI Feedback,描述的是反馈来源,不是一种固定优化器。
1 | 人类反馈:Human 判断 chosen / rejected |
AI 生成的偏好可以用于:
- 训练奖励模型后执行 PPO;
- 构造 DPO 数据;
- 过滤 SFT 样本;
- 依据原则生成批评和修订;
- 对回答执行多维度评分。
Constitutional AI
Constitutional AI 使用一组明确原则指导模型批评、修订和比较回答。其经典流程同时包含监督阶段和基于 AI 偏好的强化学习阶段。
优势是可以扩大监督规模并更明确地表达规则,风险包括:
- Judge Model 继承自身偏差;
- 复杂事实判断可能不可靠;
- 原则之间可能冲突;
- 模型可能学会迎合 Judge 的表达偏好;
- 大规模 AI 标签会系统性放大同一种错误。
因此 RLAIF 仍需要人工制定原则、抽查数据和独立评测。
偏好优化会带来哪些风险?
Reward Hacking
Reward Hacking 指策略找到了提高奖励分数的方法,却没有真正实现设计者想要的目标。
例如奖励模型偏爱详细回答,Policy 可能学会:
1 | 更长 |
奖励分数上升,但事实性和实际帮助没有提升。
根本原因是:
1 | 我们真正想要的目标 |
长度偏差
标注者和奖励模型可能把更长的回答判断为更全面。训练后模型就可能产生不必要的冗长内容。
评测时应控制长度或分别比较同等长度回答,训练数据也应包含“简洁但完整”的正例。
Sycophancy:迎合用户
如果偏好数据持续奖励“让用户感觉被认同”,模型可能接受用户的错误前提或观点,而不是指出问题。
1 | 用户提出错误结论 |
过度拒答
安全数据如果过度奖励拒绝,模型可能把合理请求也判断成危险内容:
1 | 真正危险请求 → 应拒绝 |
安全对齐不仅要测有害请求的拒绝率,也要测无害请求的正常回答率。
能力退化与 Alignment Tax
对齐某一目标时,模型可能在其他能力上下降,例如:
- 创造性降低;
- 回答模式趋同;
- 专业问题中过度保守;
- 某些基准性能下降;
- 长回答或特定风格被过度偏好。
因此需要同时保留通用能力评测,不能只看偏好 Win Rate。
Mode Collapse 与多样性下降
如果训练过度集中在少数理想模板,模型可能对不同问题反复使用相似句式,虽然安全稳定,却失去必要的表达多样性。
对齐能够消除幻觉吗?
不能。
对齐可以通过以下方式降低部分幻觉:
- 奖励承认不确定性;
- 惩罚编造引用;
- 训练模型根据来源回答;
- 在证据不足时拒答;
- 使用工具和验证器提供反馈。
但对齐不能自动解决:
- 训练知识过时;
- 检索来源错误;
- 奖励模型无法验证事实;
- 长上下文信息丢失;
- 分布外问题;
- 多步推理错误。
一个模型更符合偏好,不等于每个陈述都经过事实验证。
可验证奖励与主观偏好
不同任务的奖励可靠程度不同。
主观偏好
适合人类或 AI Judge 比较:
- 写作风格;
- 是否清晰;
- 是否有帮助;
- 摘要是否易读;
- 对话语气。
可验证奖励
可以通过外部结果直接判断:
- 数学答案是否正确;
- 代码是否通过测试;
- SQL 结果是否符合预期;
- 格式是否满足 Schema;
- 游戏或环境任务是否成功。
可验证奖励通常比模糊偏好更客观,但验证器本身仍可能不完整。模型也可能利用测试覆盖不足、评分脚本漏洞或环境缺陷。
如何评估对齐后的模型?
不能只看 Reward Model 分数,因为 Policy 正在针对这个指标优化。
建议至少分开评测:
| 维度 | 关注问题 |
|---|---|
| 指令遵循 | 是否理解并满足显式约束? |
| 任务能力 | 推理、代码、数学和领域任务是否退化? |
| 事实性 | 是否减少无依据陈述和虚假引用? |
| 安全性 | 是否拒绝真正危险的请求? |
| 过度拒答 | 是否错误拒绝正常请求? |
| 偏差与公平 | 是否对群体产生系统性差异? |
| 稳定性 | 换一种表达后行为是否一致? |
| 多样性 | 是否出现模板化和模式坍缩? |
| 鲁棒性 | 是否容易被越狱和 Prompt Injection 绕过? |
评测来源可以组合:
- 独立人类评审;
- 不同模型的 LLM-as-a-Judge;
- 确定性验证器;
- 公共与私有 Benchmark;
- 红队测试;
- 线上 A/B Test;
- 真实失败案例回归集。
Judge Model 的偏好不能被当成最终真理。需要控制位置偏差、长度偏差、自我偏好,并用部分人工金标准校准。
实战一:理解奖励模型成对损失
下面直接优化两个标量分数,观察 Bradley–Terry Loss 如何让 chosen 得分高于 rejected。
1 | import torch |
可以观察到:
1 | chosen_score 逐渐增大 |
真实奖励模型不会直接训练两个独立标量,而是使用 Transformer 根据 Prompt + Response 计算分数;这个示例只保留成对损失的核心作用。
实战二:理解 PPO Clipped Objective
下面用一组模拟的 Old/New Log Probability 和 Advantage 计算 PPO Policy Loss。
1 | import torch |
第一项概率从 0.50 增长到 0.80,Ratio 为 1.6,超过了 1.2 的上界。对于正 Advantage,裁剪目标会限制继续放大这次更新带来的收益。
需要注意,完整 PPO 还必须计算 Value Loss、Return、Advantage、KL Reward、Mask 和多个训练 Epoch;这段代码只解释 Policy Clip。
实战三:理解 DPO Loss
下面直接使用 chosen/rejected 的序列 Log Probability 计算 DPO Loss。
1 | import torch |
当 Policy 与 Reference 相同时,隐式偏好 Margin 为 0:
1 | -log σ(0) = log 2 ≈ 0.693 |
当 Policy 相对 Reference 更偏向 chosen 后,Margin 变大,DPO Loss 下降。
真实实现中需要先对回答 Token 的 Log Probability 求和,并屏蔽 Prompt 与 Padding Token。Reference Log Probability 通常提前计算或由冻结模型得到。
实战四:构造可审计的偏好数据
偏好样本不应只保存 chosen/rejected,还应尽量记录判断原因和元数据:
1 | preference_sample = { |
这些元数据可以帮助:
- 发现某类标注标准不一致;
- 按任务和语言切分评测;
- 追踪事实判断的来源;
- 分析模型究竟学到了哪类偏好;
- 删除低置信度和存在争议的样本。
常见误区
误区一:对齐就是给模型增加知识
对齐主要塑造模型如何表现和使用能力。大量、稳定的新领域知识通常更适合继续预训练;实时且需要引用的知识更适合外部检索和工具。
误区二:RLHF 就等于 PPO
RLHF 描述使用人类反馈形成奖励或偏好信号;PPO 只是利用该信号优化策略的一种算法。
误区三:SFT、PPO 和 DPO 必须依次执行
SFT 常作为起点,但 PPO-RLHF 和 DPO 通常是不同偏好优化路线。模型可能选择其中之一,也可能在不同阶段组合使用。
误区四:DPO 完全不需要参考模型
标准 DPO 损失包含 Reference Policy。部分实现可以通过参数高效微调或预计算参考 Log Probability 减少资源,但参考分布仍是目标定义的重要部分。
误区五:Reward 越高,模型就一定越好
Policy 可能利用奖励模型漏洞。必须使用独立人类评测、事实验证、安全测试和能力 Benchmark 检查真实效果。
误区六:人类偏好代表统一的人类价值
偏好取决于标注人群、规范、地区、语言和产品目标。对齐结果只能说更符合指定反馈分布,不能自动代表所有人。
误区七:拒绝越多,模型越安全
过度拒答会降低正常任务可用性。安全评测必须同时衡量危险请求处理和无害请求正常回答。
误区八:DPO 一定比 PPO 好
DPO 工程简单且通常稳定,但在线交互、可验证奖励和探索新行为时,RL 方法仍可能具有优势。
误区九:对齐后就不会幻觉
对齐可以鼓励诚实和拒答,却不能保证模型拥有最新知识或自动验证每个事实。
误区十:训练完成就不需要部署期防护
输入过滤、权限控制、工具参数校验、输出审核、速率限制、人工审批和日志监控仍然是完整系统的一部分。
工程实践建议
- 先把“好回答”拆成可操作、可标注和可评测的维度;
- SFT 数据重视质量、多样性和边界样本,不只追求数量;
- 偏好数据允许平局、跳过和低置信度,不强迫每对回答分出胜负;
- 记录标注理由、来源、语言、任务类型和标注者一致性;
- Reward Model 训练集、Policy 训练集与最终评测集严格隔离;
- PPO 同时监控 Reward、KL、Entropy、回答长度和能力回归;
- DPO 监控 chosen/rejected Margin、长度偏差和验证集 Loss;
- 不使用同一个 Reward/Judge 同时训练和证明模型成功;
- 对事实、代码和数学任务优先引入外部验证器;
- 同时评估安全拒绝与无害请求通过率;
- 对不同语言、群体和领域分别进行偏差分析;
- 将红队和线上失败案例持续加入回归评测,而不是只加入训练集后遗忘。
小结
本文的核心结论可以总结为:
- 预训练主要获得通用能力,对齐主要塑造模型行为;
- 对齐目标必须落实为示范、偏好、规则、验证器和评测,而不是抽象的“所有人类价值”;
- SFT 使用目标回答进行 Token 级监督,让模型学会指令和交互格式;
- 偏好数据通过 chosen/rejected 表达回答之间的相对质量;
- Reward Model 使用成对排序损失学习偏好代理分数;
- PPO-RLHF 使用 Reward、Value、Advantage、KL 和裁剪目标更新策略;
- Reference Model 用于限制策略不要过度偏离原始 SFT 模型;
- DPO 直接在离线偏好对上优化 Policy,不需要显式 Reward Model 和 PPO 循环;
- RLAIF 改变的是反馈来源,可以与 PPO 或 DPO 等优化方法组合;
- Reward Hacking、长度偏差、迎合、过度拒答和能力退化都需要独立评测;
- 更符合偏好不等于事实全部正确,也不等于模型已经绝对安全;
- 对齐是一套持续的数据、训练、评测和部署治理流程。
至此,LLM 基础系列已经完成从输入、生成、缓存、幻觉、Transformer、训练到对齐的核心链路:
1 | 文本与 Prompt |
接下来可以进入独立的 Prompt Engineering 系列,讨论如何将任务、上下文、示例、约束和输出协议组织成稳定、可评测的模型输入。
参考资料
- Training Language Models to Follow Instructions with Human Feedback
- Proximal Policy Optimization Algorithms
- Direct Preference Optimization: Your Language Model Is Secretly a Reward Model
- Constitutional AI: Harmlessness from AI Feedback
- Deep Reinforcement Learning from Human Preferences
- Hugging Face TRL Documentation