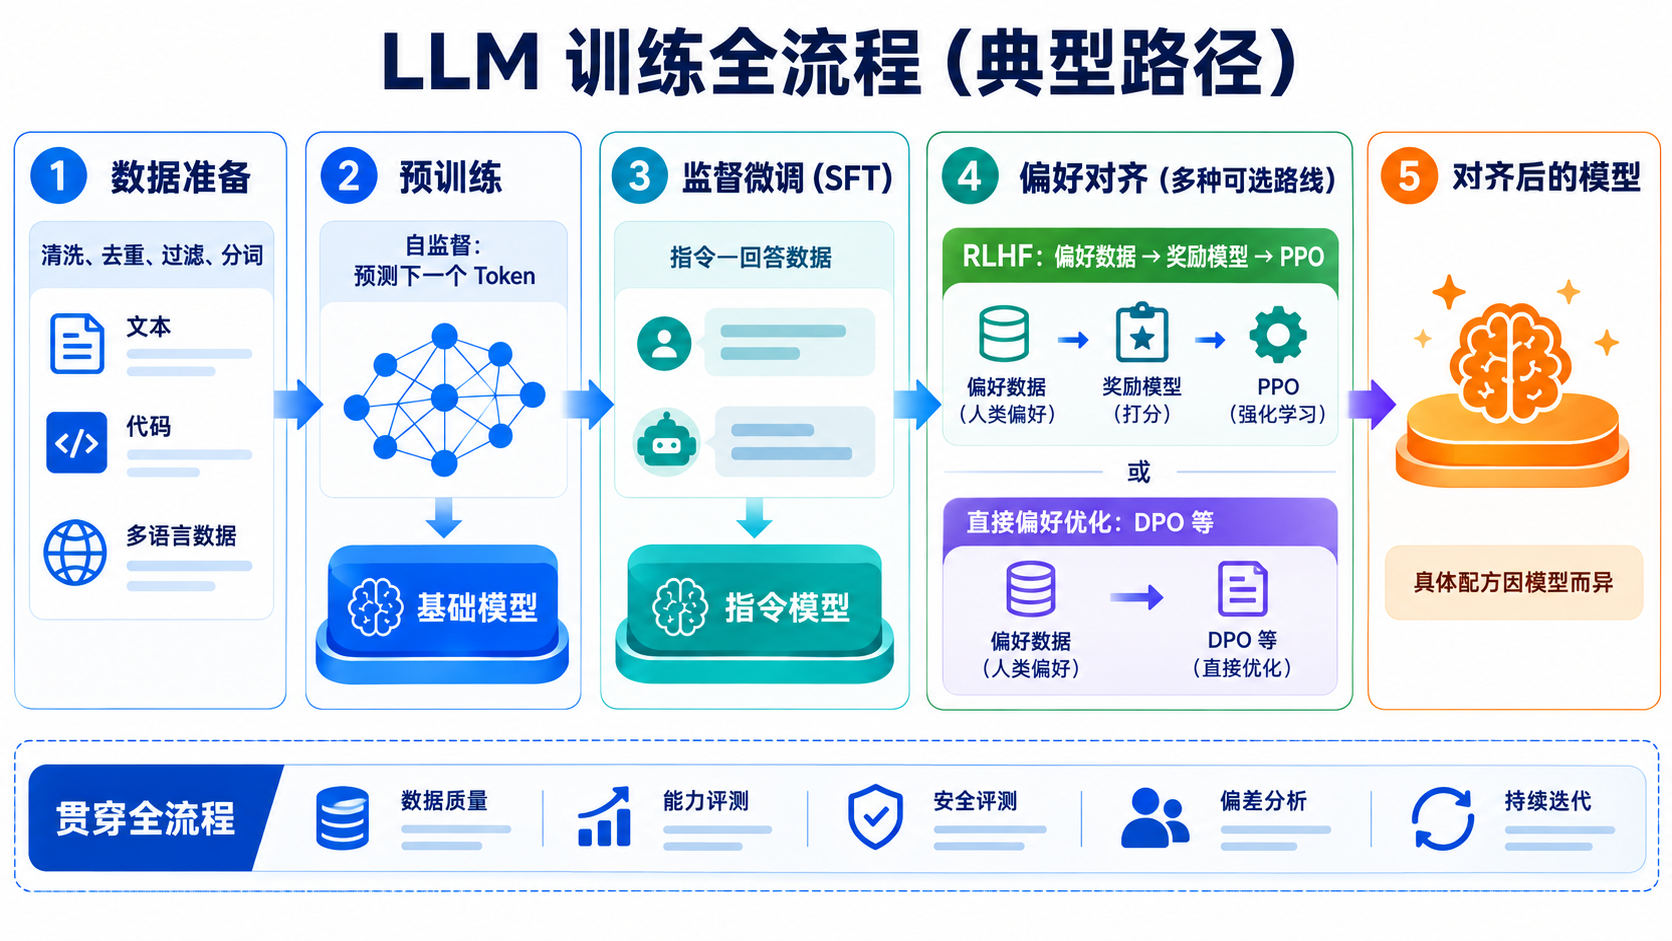
LLM 如何训练:从预训练到后训练 在上一篇文章中,我们进入 Transformer 内部,了解了 Token 如何经过 Embedding、Self-Attention、FFN 和多层 Transformer Block,最终得到词表上的 Logits。
不过,一个随机初始化的 Transformer 只会输出近似随机的概率分布。模型能够续写文本、回答问题、编写代码,并不是因为工程师把所有规则逐条写进程序,而是因为模型参数在大量训练数据上经过了持续优化。
本文将介绍一条典型的 LLM 训练路线:
目标与数据设计 → Tokenizer → 预训练 → 后训练 → 评测与安全验证 → 部署反馈与迭代
需要先说明:这不是所有模型都必须遵循的唯一流程。经典的 InstructGPT 路线包含 SFT、奖励模型和 PPO,但现代模型也可能使用 DPO、RLAIF、可验证奖励强化学习或其他后训练方法。不同团队会根据模型目标、数据和计算资源选择不同配方。
本文要回答什么? 本文重点建立训练全景,而不是教读者在一台电脑上复现前沿大模型:
训练过程中究竟在更新什么;
原始文本如何变成监督信号;
预训练、继续预训练和 SFT 有什么区别;
偏好数据、奖励模型、PPO 和 DPO 分别解决什么问题;
为什么训练大模型需要混合精度和分布式并行;
为什么 Loss 下降不等于模型已经安全、真实且可部署;
数据、训练、评测和部署反馈如何形成闭环。
核心概念 预训练:获得基础能力 预训练通常使用大规模文本、代码和多语言数据,通过自监督学习让模型掌握语言规律、知识关联及部分推理模式。
对于典型的 Decoder-only 自回归语言模型,训练目标是:给定前面的 Token,预测下一个 Token。原始文本本身就能提供输入和目标,不需要人工逐条标注,因此被称为自监督学习。
预训练完成后得到的通常称为基础模型(Base Model) 。它擅长文本续写,但未必能稳定理解聊天角色、遵循用户指令或拒绝不安全请求。
监督微调:学习遵循指令 监督微调(Supervised Fine-Tuning,SFT)使用高质量的“指令—回答”或多轮对话数据继续训练基础模型,使它学会按照指定格式回答问题、完成任务。
SFT 的关键不只是数据数量,更是数据质量、覆盖范围和一致性。少量高质量数据可以显著改变模型的交互方式,但“5K~100K 条就一定足够”并不是普遍规律:所需规模取决于基础模型能力、任务范围、数据多样性和训练目标。
在常见的 assistant-only 训练方式中,系统消息和用户指令对应的标签会被设为 -100,只在 Assistant 回答部分计算交叉熵损失。不过,这同样不是硬性规定;有些训练配方会对完整序列计算损失,或者给不同部分设置不同权重。
偏好对齐:让回答更符合目标 SFT 告诉模型“一个合格回答是什么样”,偏好对齐则利用回答之间的相对优劣,进一步优化有用性、真实性、风格和安全边界。
偏好对齐有多种实现方式,RLHF 只是其中一种。因此,“预训练、SFT 和 RLHF 三个阶段缺一不可”并不准确。更稳妥的说法是:
预训练通常负责获得通用语言能力;
SFT 常用于建立指令遵循和对话格式;
RLHF、DPO 等方法可以继续优化偏好,但具体路线因模型而异。
此外,完成偏好优化并不意味着模型已经“安全”或“完全符合人类价值”。训练数据的偏差、奖励模型的局限、越狱攻击和分布外输入仍可能导致失败,因此还需要持续评测、红队测试和部署期防护。
训练究竟改变了什么? Transformer 的结构由代码和配置定义,而训练主要改变其中的可学习参数,也就是权重。
可以把一个训练步骤简化为:
1
2
3
4
5
6
7
8
9
10
11
一批 Token ↓ Forward:模型计算 Logits ↓ Loss:比较预测与目标 Token ↓ Backward:反向传播计算每个参数的梯度 ↓ Optimizer:根据梯度更新参数 ↓ 进入下一批数据
参数更新可以抽象表示为:
1 θ_new = θ_old - learning_rate × gradient
真实优化器通常比这个公式复杂。例如 AdamW 会维护梯度的一阶和二阶统计量,并结合权重衰减更新参数。
训练不会把每篇文档原封不动地写入一个可查询数据库。模型在大量样本上调整参数,使某些 Token 序列在相应上下文中获得更高概率。知识、语言模式和行为倾向以分布式方式编码在参数中,这也是模型可能概括知识、混淆事实或产生幻觉的原因之一。
训练、微调与推理
过程
是否计算梯度
是否更新权重
主要目的
预训练
是
是
获得通用语言与知识能力
继续预训练
是
是
适应新领域、语言或数据分布
SFT
是
是
学习指令、对话和目标输出
偏好优化
是
是
调整回答偏好和行为边界
推理
否
否
使用已有权重生成答案
KV Cache、Temperature 和 Top-p 都属于推理过程中的机制,不会因为用户进行一次普通请求就修改模型参数。
技术细节 1. 数据准备 训练前通常需要完成以下工作:
采集 :收集网页、书籍、论文、代码和多语言语料等数据。清洗 :删除乱码、模板页、低质量内容和异常样本。去重 :减少重复文档和近似内容,降低记忆与数据泄漏风险。过滤 :处理隐私、版权、安全和基准测试污染等问题。配比 :控制不同语言、领域和数据来源所占比例。分词 :使用 Tokenizer 将文本编码为 Token ID 序列。
数据质量会直接影响模型能力上限。仅仅增加未经筛选的数据,不一定能持续提升模型效果。
2. 预训练 2.1 下一个 Token 预测 假设 Token 序列为:
自回归语言模型学习条件概率:
1 P(xₜ | x₁, x₂, ..., xₜ₋₁)
训练时,模型会在序列的多个位置同时进行预测,并使用交叉熵衡量预测分布与真实 Token 之间的差异。训练目标可以写成:
1 L = -Σ log P(xₜ | x₁, ..., xₜ₋₁)
在 Causal Language Model 中,框架通常会在内部将输入与标签错开一位:当前位置的隐藏状态用于预测下一个 Token。
2.2 一个训练 Batch 经历了什么? 文本通常会先被拼接或切分成固定长度的训练序列,再组成 Batch:
1
2
3
4
5
6
7
8
9
原始文档 ↓ Tokenizer ↓ 连续 Token 流 ↓ 切分或 Packing ↓ [batch_size, sequence_length]
一次迭代通常包含:
从数据加载器取得一个 Batch;
执行 Forward 得到 Logits 和 Loss;
使用 Backward 计算梯度;
根据需要执行梯度累积与梯度裁剪;
Optimizer 更新权重;
Learning Rate Scheduler 调整学习率;
清空梯度并处理下一批数据;
定期保存 Checkpoint 和运行验证集评测。
如果显存一次只能容纳较小 Batch,可以执行多次 Forward/Backward 后再更新:
1
2
3
4
effective_batch_size = micro_batch_size × gradient_accumulation_steps × data_parallel_world_size
这里的等式用于理解常见数据并行训练;实际框架还可能使用序列并行等策略。
2.3 继续预训练 预训练并非只能发生一次。已有基础模型还可以在特定数据上继续进行 Next-Token Prediction,常称为 Continued Pretraining 或 Domain-Adaptive Pretraining。
例如:
1
2
3
4
5
6
7
通用基础模型 ↓ 高质量代码、医学、法律或特定语言语料 ↓ 领域继续预训练 ↓ 领域基础模型
继续预训练改变的是模型对某类数据分布的建模能力;SFT 更侧重“根据指令怎样回答”。两者不能简单互相替代。
继续训练还要注意灾难性遗忘:如果只使用范围很窄的新数据,模型原有的通用能力可能下降。因此常见做法包括混入部分通用数据、控制学习率,并持续评测多个能力维度。
2.4 如何理解训练规模 LLM 的训练规模差异非常大,不能用一组数字概括所有模型。下面是用于建立直觉的宽泛范围,而不是行业门槛:
项目
可能的量级
说明
训练数据
数十亿到数万亿 Token
取决于模型规模、数据策略和重复训练轮数
参数量
数亿到数千亿以上
小模型和超大模型的计算需求差异巨大
训练时间
数天到数月
取决于硬件数量、利用率和训练规模
训练成本
差异可达多个数量级
硬件、能源、工程和实验成本都应计入
因此,“7B~1T 参数”“几万亿 Token”“百万~亿美元”可以描述部分大型项目,却不应写成 LLM 训练的固定范围。
对于稠密 Transformer,业界有时使用下面的近似关系建立计算量直觉:
1 Training FLOPs ≈ 6 × 参数量 N × 训练 Token 数 D
它只是粗略估算,不包含所有架构差异、稀疏激活、重计算和硬件利用率。真正训练预算还受到序列长度、并行策略、通信开销、失败重启和实验次数影响。
3. 监督微调(SFT) SFT 数据通常包含:
系统消息:规定模型角色、行为边界或输出格式;
用户消息:提出指令或问题;
Assistant 消息:给出目标回答;
多轮历史:让模型学习在对话上下文中持续交互。
训练过程依然是 Token 级交叉熵优化。与预训练相比,核心变化主要在于数据分布和标签掩码:模型不再只学习任意文本的延续方式,而是重点学习如何生成理想回答。
需要注意,聊天模板是模型训练格式的一部分。system、user、assistant 等角色最终都会被转换成特定的 Token 序列;推理时如果使用了不匹配的模板,模型表现可能明显下降。
4. 经典 RLHF:奖励模型与 PPO RLHF(Reinforcement Learning from Human Feedback)利用人类反馈构造奖励信号。以经典的 InstructGPT 路线为例,它通常建立在已经完成 SFT 的模型之上。
4.1 收集偏好数据 对于同一个 Prompt,让模型生成多个候选回答,再由标注者选择或排序哪些回答更好:
1 Prompt + 获胜回答(chosen)+ 落选回答(rejected)
“更好”必须通过标注规范定义,可能同时考虑有用性、正确性、相关性、表达质量和安全性。偏好标签并不是客观真理,也会受到标注者背景和规范设计的影响。
4.2 训练奖励模型 奖励模型(Reward Model,RM)读取 Prompt 和回答,并输出一个标量分数。训练时希望获胜回答的分数高于落选回答。常见的成对排序损失为:
1 L_RM = -log σ(r_chosen - r_rejected)
其中,r_chosen 和 r_rejected 分别是奖励模型对两个回答的评分。
4.3 使用 PPO 优化策略模型 PPO 阶段通常包含四个角色:
组件
作用
策略模型(Policy)
生成回答,也是要被更新的 LLM
参考模型(Reference)
通常冻结,用于限制策略偏离原有模型太远
奖励模型(Reward Model)
对完整回答给出奖励分数
价值模型(Value Model)
估计期望回报,帮助计算 Advantage
一个训练批次的简化流程如下:
策略模型根据 Prompt 采样回答;
奖励模型对回答打分;
计算策略模型与参考模型之间的 KL 惩罚;
价值模型估计回报,并计算 Advantage;
使用 PPO 的裁剪目标更新策略模型;
更新价值模型,并监控奖励、KL、长度和生成质量。
KL 约束用于减少策略模型为了追逐奖励而过度偏离参考模型的风险,但它不能彻底消除奖励投机或训练不稳定。
5. DPO 与 RLAIF 5.1 DPO:直接使用偏好数据 DPO(Direct Preference Optimization)直接在 chosen/rejected 偏好对上优化策略模型,不需要单独训练奖励模型,也不需要运行 PPO 的在线采样循环。
DPO 的工程实现通常更简单,但“更简单”不等于在所有任务上都与 PPO 效果相同。最终表现仍取决于偏好数据质量、参考模型、超参数和评测目标。
5.2 RLAIF:反馈来源发生变化 RLAIF(Reinforcement Learning from AI Feedback)使用 AI 生成或判断偏好反馈,以减少部分人工标注成本。它描述的是反馈来源 ,而不是一种与 PPO、DPO 并列的固定优化算法。
例如,AI 可以依据一组原则比较两个回答,再用这些偏好训练奖励模型或执行直接偏好优化。AI 反馈可以扩展数据规模,但也可能继承评审模型的偏差和错误,因此仍需人工校准和独立评测。
6. 各阶段对比
阶段
典型数据
优化目标
典型产物
预训练
大规模原始语料
下一个 Token 预测
基础模型
SFT
指令—回答、多轮对话
模仿目标回答、学习指令遵循
指令模型
奖励模型训练
Prompt、获胜回答、落选回答
学习回答之间的相对偏好
奖励模型
PPO 式 RLHF
在线采样回答、奖励、参考策略
在约束下提高期望奖励
对齐后的策略模型
DPO 等直接偏好优化
离线偏好对
提高获胜回答的相对概率
对齐后的策略模型
7. 大规模训练为什么需要分布式系统? 当模型、Optimizer State、梯度和激活值无法放入单张 GPU 时,需要把计算或数据拆到多张设备上。
并行方式
基本思想
主要解决的问题
Data Parallel
每张设备放模型副本,处理不同数据
提高数据吞吐
Tensor Parallel
把单个矩阵运算拆到多张设备
单层参数或计算过大
Pipeline Parallel
把不同模型层放到不同设备
模型层整体放不下
Sequence Parallel
沿序列维度拆分部分计算
长序列激活占用大
Expert Parallel
把不同 MoE Expert 分散到设备
稀疏专家模型训练
大型训练还会使用:
BF16 或 FP16 混合精度;
Gradient Checkpointing,用额外计算换激活显存;
ZeRO 或 Fully Sharded Data Parallel,切分参数、梯度和优化器状态;
高吞吐数据管线;
分布式 Checkpoint;
故障检测与训练恢复;
通信与计算重叠。
因此,训练成本不只是“GPU 数量 × 运行时间”。硬件利用率、网络互联、存储吞吐和系统稳定性都会显著影响最终成本。
8. 评测为什么贯穿全流程? Loss 是重要信号,但不是最终产品质量的完整度量。
1
2
3
4
5
6
7
训练 Loss 下降 ≠ 所有任务效果都提升 ≠ 事实性与安全性都提升 ≠ 模型已经可以上线
不同阶段需要观察不同指标:
阶段
常见检查内容
数据准备
数据质量、重复率、隐私、版权、污染
预训练
Train/Validation Loss、Perplexity、能力评测
SFT
指令遵循、格式、领域任务、多轮对话
偏好优化
Win Rate、奖励、KL、长度偏差、Reward Hacking
安全评测
有害请求、越狱、隐私泄露、偏见
部署评测
延迟、吞吐、成本、稳定性、线上失败案例
评测集必须与训练数据隔离。若基准题目或参考答案进入训练集,分数可能反映记忆或数据污染,而不是真实泛化能力。
完整流程更接近:
1
2
3
4
5
6
7
8
9
10
11
12
数据与目标设计 ↓ 训练 ↓ 离线能力、安全与偏差评测 ↓ 失败分析与数据修订 ↓ 重新训练或继续后训练 ↓ 受控部署与线上监控 └──────────→ 回到数据与评测
代码示例 以下代码用于展示核心控制流,不是可直接用于大规模训练的完整工程。真实训练还需要分布式并行、混合精度、梯度累积、检查点、数据流式加载和完善的评测系统。
1. 预训练:Next-Token Prediction 下面使用本地下载模型Qwen2.5-0.5B-Instruct的配置和 Tokenizer,随机初始化模型参数,演示一个训练步骤:
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 43 44 45 46 47 48 49 50 51 52 53 54 55 56 57 58 59 60 61 62 63 64 65 66 67 68 69 70 71 72 73 74 75 import torchfrom torch.optim import AdamWfrom transformers import AutoConfig, AutoModelForCausalLM, AutoTokenizerMODEL_PATH = "./models/Qwen2.5-0.5B-Instruct" if torch.cuda.is_available(): device = "cuda" elif torch.backends.mps.is_available(): device = "mps" else : device = "cpu" print ("运行设备:" , device)tokenizer = AutoTokenizer.from_pretrained( MODEL_PATH, local_files_only=True ) config = AutoConfig.from_pretrained( MODEL_PATH, local_files_only=True ) model = AutoModelForCausalLM.from_config(config).to(device) model.config.use_cache = False optimizer = AdamW(model.parameters(), lr=1e-4 ) text_batch = [ "今天天气很好,适合出去散步。" , "大语言模型通过预测下一个 Token 学习语言规律。" ] batch = tokenizer( text_batch, return_tensors="pt" , padding=True , truncation=True , max_length=128 ).to(device) labels = batch["input_ids" ].clone() labels[batch["attention_mask" ] == 0 ] = -100 model.train() outputs = model( **batch, labels=labels ) optimizer.zero_grad(set_to_none=True ) outputs.loss.backward() torch.nn.utils.clip_grad_norm_(model.parameters(), max_norm=1.0 ) optimizer.step() print ("预训练单步完成,loss:" , outputs.loss.item())
执行结果
1
2
3
4
5
6
/Users/jean/.pyenv/shims/uv run /Users/jean/PycharmProjects/llm-base/.venv/bin/python /Users/jean/PycharmProjects/llm-base/qwen_pretrain_demo.py 运行设备: mps 预训练单步完成,loss: 11.999110221862793 Process finished with exit code 0
AutoModelForCausalLM 会在内部完成标签错位,使位置 t 的输出预测位置 t+1 的 Token。Padding 必须从损失中排除,否则模型会浪费能力去预测填充符号。
2. SFT:只在 Assistant 回答上计算损失 下面使用模型自带的 Chat Template 构造训练序列。与手写 User:、Assistant: 字符串相比,这种方式更接近模型实际的训练格式。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 43 44 45 46 47 48 49 50 51 52 53 54 55 56 57 58 59 60 61 62 63 64 65 66 67 68 69 70 71 72 73 74 75 76 77 78 79 80 81 82 83 84 85 86 87 88 89 90 91 92 93 94 95 96 97 98 99 100 101 import torchfrom torch.optim import AdamWfrom transformers import AutoModelForCausalLM, AutoTokenizerMODEL_PATH = "./models/Qwen2.5-0.5B-Instruct" if torch.cuda.is_available(): device = "cuda" elif torch.backends.mps.is_available(): device = "mps" else : device = "cpu" print ("运行设备:" , device)tokenizer = AutoTokenizer.from_pretrained( MODEL_PATH, local_files_only=True ) model = AutoModelForCausalLM.from_pretrained( MODEL_PATH, local_files_only=True , dtype=torch.float32 ).to(device) model.config.use_cache = False optimizer = AdamW(model.parameters(), lr=1e-5 ) instruction = "用一句话解释梯度下降。" response = "梯度下降沿损失函数下降最快的方向迭代更新模型参数。" prompt_messages = [ { "role" : "user" , "content" : instruction } ] full_messages = [ *prompt_messages, { "role" : "assistant" , "content" : response } ] prompt = tokenizer.apply_chat_template( prompt_messages, tokenize=True , add_generation_prompt=True , return_dict=True , return_tensors="pt" ).to(device) full = tokenizer.apply_chat_template( full_messages, tokenize=True , add_generation_prompt=False , return_dict=True , return_tensors="pt" ).to(device) prompt_length = prompt["input_ids" ].shape[1 ] assert torch.equal( prompt["input_ids" ], full["input_ids" ][:, :prompt_length] ), "Chat Template 的生成前缀与完整对话不一致" labels = full["input_ids" ].clone() labels[:, :prompt_length] = -100 labels[full["attention_mask" ] == 0 ] = -100 model.train() outputs = model( **full, labels=labels ) optimizer.zero_grad(set_to_none=True ) outputs.loss.backward() torch.nn.utils.clip_grad_norm_(model.parameters(), max_norm=1.0 ) optimizer.step() print ("SFT 单步完成,loss:" , outputs.loss.item())
执行结果
1
2
3
4
5
6
7
/Users/jean/.pyenv/shims/uv run /Users/jean/PycharmProjects/llm-base/.venv/bin/python /Users/jean/PycharmProjects/llm-base/qwen_sft_demo.py 运行设备: mps Loading weights: 100%|██████████| 290/290 [00:00<00:00, 364.79it/s] SFT 单步完成,loss: 2.633002281188965 Process finished with exit code 0
不能简单地分别对 instruction 和完整文本分词,再假设两次得到的 Token 数可以直接拼接。BPE 等分词算法的结果可能受到前后字符影响,聊天模板还会插入特殊 Token,因此必须验证回答边界。
3. 奖励模型:成对偏好损失 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 43 44 45 46 47 48 49 50 51 52 53 54 55 56 57 58 59 60 61 62 63 64 65 66 67 68 69 70 71 72 73 74 75 76 77 78 79 80 81 82 83 84 85 86 87 import torchimport torch.nn.functional as Ffrom torch.optim import AdamWfrom transformers import AutoModelForSequenceClassification, AutoTokenizerMODEL_PATH = "./models/Qwen2.5-0.5B-Instruct" if torch.cuda.is_available(): device = "cuda" elif torch.backends.mps.is_available(): device = "mps" else : device = "cpu" print ("运行设备:" , device)tokenizer = AutoTokenizer.from_pretrained( MODEL_PATH, local_files_only=True ) model = AutoModelForSequenceClassification.from_pretrained( MODEL_PATH, local_files_only=True , num_labels=1 , dtype=torch.float32 ).to(device) model.config.pad_token_id = tokenizer.pad_token_id optimizer = AdamW(model.parameters(), lr=1e-5 ) prompt = "地球为什么有四季?" chosen = "因为地轴相对公转轨道平面存在倾角,各地区接收太阳辐射随公转而变化。" rejected = "因为地球在夏天离太阳更近。" chosen_messages = [ {"role" : "user" , "content" : prompt}, {"role" : "assistant" , "content" : chosen} ] rejected_messages = [ {"role" : "user" , "content" : prompt}, {"role" : "assistant" , "content" : rejected} ] chosen_batch = tokenizer.apply_chat_template( chosen_messages, tokenize=True , add_generation_prompt=False , return_dict=True , return_tensors="pt" ).to(device) rejected_batch = tokenizer.apply_chat_template( rejected_messages, tokenize=True , add_generation_prompt=False , return_dict=True , return_tensors="pt" ).to(device) model.train() chosen_score = model(**chosen_batch).logits.squeeze(-1 ) rejected_score = model(**rejected_batch).logits.squeeze(-1 ) loss = -F.logsigmoid(chosen_score - rejected_score).mean() optimizer.zero_grad(set_to_none=True ) loss.backward() torch.nn.utils.clip_grad_norm_(model.parameters(), max_norm=1.0 ) optimizer.step() print ("Chosen 分数:" , chosen_score.item())print ("Rejected 分数:" , rejected_score.item())print ("奖励模型单步完成,loss:" , loss.item())
执行结果
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 /Users/jean/.pyenv/shims/uv run /Users/jean/PycharmProjects/llm-base/.venv/bin/python /Users/jean/PycharmProjects/llm-base/qwen_reward_model_demo.py 运行设备: mps Loading weights: 100%|██████████| 290/290 [00:00<00:00, 315.46it/s] [transformers] Qwen2ForSequenceClassification LOAD REPORT from: ./models/Qwen2.5-0.5B-Instruct Key | Status | -------------+---------+- score.weight | MISSING | Notes: - MISSING: those params were newly initialized because missing from the checkpoint. Consider training on your downstream task. Chosen 分数: 5.9947357177734375 Rejected 分数: 4.799543380737305 奖励模型单步完成,loss: 0.26439738273620605 Process finished with exit code 0
实际奖励模型通常会分别编码 Prompt + chosen 和 Prompt + rejected,取序列末端的标量分数,再使用上述损失进行训练。
4. PPO:单步教学骨架 PPO 不能简化为 -(reward - KL) * log_prob。真正的 PPO 至少需要旧策略概率、Advantage、裁剪目标和价值函数。下面的代码把这些组件压缩到一个单机训练步骤中,用于理解控制流,而不是可直接扩展到生产环境的 RLHF 实现。
示例中的奖励头是随机初始化的,因此 Loss 和奖励数值没有质量意义;它只能验证张量流和 PPO 裁剪目标。真正训练必须使用已经训练并经过评测的奖励模型,还要正确处理 Padding、EOS、可变回答长度、多个 PPO Epoch、分布式采样和监控指标。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 43 44 45 46 47 48 49 50 51 52 53 54 55 56 57 58 59 60 61 62 63 64 65 66 67 68 69 70 71 72 73 74 75 76 77 78 79 80 81 82 83 84 85 86 87 88 89 90 91 92 93 94 95 96 97 98 99 100 101 102 103 104 105 106 107 108 109 110 111 112 113 114 115 116 117 118 119 120 121 122 123 124 125 126 127 128 129 130 131 132 133 134 135 136 137 138 139 140 141 142 143 144 145 146 147 148 149 150 151 152 153 154 155 156 157 158 159 160 161 162 163 164 165 166 167 168 169 170 171 172 173 174 175 176 177 178 179 180 181 182 183 184 185 186 187 188 189 190 191 192 193 194 195 196 197 198 199 200 201 202 203 204 205 206 207 208 209 210 211 212 213 214 215 216 217 218 219 220 221 222 import torchimport torch.nn.functional as Ffrom torch import nnfrom torch.optim import AdamWfrom transformers import AutoModelForCausalLM, AutoTokenizerMODEL_PATH = "./models/Qwen2.5-0.5B-Instruct" MAX_NEW_TOKENS = 8 BETA = 0.02 EPSILON = 0.2 VALUE_COEF = 0.5 GAMMA = 1.0 GAE_LAMBDA = 0.95 if torch.cuda.is_available(): device = "cuda" elif torch.backends.mps.is_available(): device = "mps" else : device = "cpu" print ("运行设备:" , device)tokenizer = AutoTokenizer.from_pretrained( MODEL_PATH, local_files_only=True ) policy = AutoModelForCausalLM.from_pretrained( MODEL_PATH, local_files_only=True , dtype=torch.float32 ).to(device) policy.config.use_cache = False reference = AutoModelForCausalLM.from_pretrained( MODEL_PATH, local_files_only=True , dtype=torch.float32 ).to(device) reference.config.use_cache = False reference.eval () for parameter in reference.parameters(): parameter.requires_grad_(False ) value_head = nn.Linear(policy.config.hidden_size, 1 ).to(device) reward_head = nn.Linear(policy.config.hidden_size, 1 ).to(device) reward_head.eval () for parameter in reward_head.parameters(): parameter.requires_grad_(False ) optimizer = AdamW( [*policy.parameters(), *value_head.parameters()], lr=1e-6 ) messages = [ { "role" : "user" , "content" : "用一句话解释什么是注意力机制。" } ] model_inputs = tokenizer.apply_chat_template( messages, tokenize=True , add_generation_prompt=True , return_dict=True , return_tensors="pt" ).to(device) prompt_length = model_inputs["input_ids" ].shape[1 ] policy.eval () with torch.no_grad(): generated_ids = policy.generate( **model_inputs, max_new_tokens=MAX_NEW_TOKENS, do_sample=True , temperature=0.8 , pad_token_id=tokenizer.pad_token_id, eos_token_id=tokenizer.eos_token_id ) attention_mask = torch.ones_like(generated_ids) old_outputs = policy( input_ids=generated_ids, attention_mask=attention_mask, output_hidden_states=True ) reference_outputs = reference( input_ids=generated_ids, attention_mask=attention_mask, output_hidden_states=True ) response_ids = generated_ids[:, prompt_length:] old_response_logits = old_outputs.logits[:, prompt_length - 1 :-1 ] reference_response_logits = reference_outputs.logits[:, prompt_length - 1 :-1 ] old_log_probs = old_response_logits.log_softmax(-1 ).gather( dim=-1 , index=response_ids.unsqueeze(-1 ) ).squeeze(-1 ) reference_log_probs = reference_response_logits.log_softmax(-1 ).gather( dim=-1 , index=response_ids.unsqueeze(-1 ) ).squeeze(-1 ) old_values = value_head( old_outputs.hidden_states[-1 ][:, prompt_length:] ).squeeze(-1 ) sequence_score = reward_head( reference_outputs.hidden_states[-1 ][:, -1 ] ).squeeze(-1 ) kl_penalty = old_log_probs - reference_log_probs token_rewards = -BETA * kl_penalty token_rewards[:, -1 ] += sequence_score advantages = torch.zeros_like(token_rewards) next_value = torch.zeros_like(old_values[:, 0 ]) next_advantage = torch.zeros_like(old_values[:, 0 ]) for token_index in reversed (range (token_rewards.shape[1 ])): delta = ( token_rewards[:, token_index] + GAMMA * next_value - old_values[:, token_index] ) next_advantage = delta + GAMMA * GAE_LAMBDA * next_advantage advantages[:, token_index] = next_advantage next_value = old_values[:, token_index] returns = advantages + old_values advantages = ( (advantages - advantages.mean()) / (advantages.std(unbiased=False ) + 1e-8 ) ) policy.train() new_outputs = policy( input_ids=generated_ids, attention_mask=attention_mask, output_hidden_states=True ) new_response_logits = new_outputs.logits[:, prompt_length - 1 :-1 ] new_log_probs = new_response_logits.log_softmax(-1 ).gather( dim=-1 , index=response_ids.unsqueeze(-1 ) ).squeeze(-1 ) new_values = value_head( new_outputs.hidden_states[-1 ][:, prompt_length:] ).squeeze(-1 ) ratio = torch.exp(new_log_probs - old_log_probs) unclipped_objective = ratio * advantages clipped_objective = torch.clamp( ratio, 1.0 - EPSILON, 1.0 + EPSILON ) * advantages policy_loss = -torch.minimum( unclipped_objective, clipped_objective ).mean() value_loss = F.mse_loss(new_values, returns) loss = policy_loss + VALUE_COEF * value_loss optimizer.zero_grad(set_to_none=True ) loss.backward() torch.nn.utils.clip_grad_norm_( [*policy.parameters(), *value_head.parameters()], max_norm=1.0 ) optimizer.step() generated_text = tokenizer.decode( response_ids[0 ], skip_special_tokens=True ) print ("采样回答:" , generated_text)print ("序列奖励:" , sequence_score.item())print ("PPO 单步完成,loss:" , loss.item())print ("注意:奖励头未经训练,本示例只用于展示 PPO 的核心控制流。" )
执行结果
1
2
3
4
5
6
7
8
9
10
11
/Users/jean/.pyenv/shims/uv run /Users/jean/PycharmProjects/llm-base/.venv/bin/python /Users/jean/PycharmProjects/llm-base/qwen_ppo_demo.py 运行设备: mps Loading weights: 100%|██████████| 290/290 [00:00<00:00, 342.03it/s] Loading weights: 100%|██████████| 290/290 [00:00<00:00, 1389.01it/s] 采样回答: 注意力机制是一种深度学习模型技术, 序列奖励: -5.308444976806641 PPO 单步完成,loss: 21.72451400756836 注意:奖励头未经训练,本示例只用于展示 PPO 的核心控制流。 Process finished with exit code 0
工程实践中通常应使用经过验证的 RLHF 训练框架,而不是根据这段伪代码自行实现分布式 PPO。
常见误区 误区一:LLM 训练固定分成三个缺一不可的阶段 预训练、SFT、奖励模型和 PPO 是一条经典路线,但并不是唯一配方。DPO 可以跳过显式奖励模型与 PPO;RLAIF 改变反馈来源;有些领域模型只进行继续预训练和 SFT。
误区二:只有 RLHF 才能提高安全性 安全数据 SFT、拒绝采样、DPO、规则系统、输入输出审核和部署期监控都可能参与安全治理。RLHF 不是安全性的充分条件,也不是唯一手段。
误区三:SFT 永远只在回答部分计算损失 只训练 Assistant Token 是常见实践,但不是定义本身。是否屏蔽 Prompt、是否训练多轮中的全部 Assistant 回复,以及是否对不同 Token 加权,都属于具体训练配方。
误区四:偏好标签代表统一的人类价值 不同人群可能对正确性、风格和安全边界有不同判断。所谓“人类偏好”实际上来自特定标注规范、标注者和采样分布,因此必须报告数据来源并进行偏差评测。
误区五:训练就是把资料存进模型 训练通过梯度更新分布式参数,使目标 Token 在相应上下文中获得更高概率。它不是把文档保存成可精确查询、实时更新的数据库。
误区六:训练 Loss 越低,模型就一定越好 更低的训练 Loss 可能来自更好学习,也可能伴随过拟合、数据泄漏或基准污染。模型还需要在独立验证集、下游能力、安全性和部署指标上评测。
误区七:模型参数显存就是全部训练显存 训练还需要梯度、优化器状态、激活值和临时工作区。使用 AdamW 全参数训练时,训练内存通常显著高于只加载权重进行推理。
误区八:微调一定能增加新知识 SFT 更擅长塑造回答格式和行为。注入大量稳定领域知识时,继续预训练、RAG 或外部工具可能更合适,具体取决于知识是否频繁变化、是否需要引用和能否容忍参数记忆误差。
小结 LLM 训练可以分成两个大的层次:
预训练 :通过大规模自监督学习获得通用语言能力,产出基础模型;后训练 :通过 SFT、偏好优化及其他方法塑造模型行为,产出适合交互和部署的模型。
其中,SFT、RLHF、DPO 和 RLAIF 并不是互相完全排斥或固定依次出现的步骤,而是后训练工具箱中的不同组成部分。理解每种方法解决什么问题、使用什么数据、优化什么目标,比记住一条固定流程更重要。
还需要记住:训练是由数据、优化、分布式系统和评测共同构成的工程闭环。能够完成一次 loss.backward(),距离训练出可靠、可部署的大模型仍然很远。
下一篇将专门介绍模型对齐,深入拆解 SFT、偏好数据、奖励模型、PPO、DPO、RLAIF 和 Reward Hacking。本文中的 RLHF 内容只用于建立训练全景。
参考资料