所有AI应用最终都基于大模型提供的服务接口,用户通过AI应用间接与大模型交互。自然语言交互以prompt为载体,这是与传统功能测试最本质的区别。需要建立系统性思维应对prompt交互带来的新测试场景。
prompt作为”接口”的特殊性体现在其自然语言交互形式和动态响应特征:
- 基础测试:截断策略、空输入/异常输入处理、超长文本输入
- 参数测试:temperature边界、top_p/max_tokens组合、参数组合爆炸
- 对话测试:多轮状态一致性、角色错乱、上下文长度限制
- 风险测试:上下文溢出风险、功能失败模式分析
相比传统接口测试,更关注语言理解、上下文关联和动态响应质量。
AI 应用功能测试范围定义
AI 应用功能测试,核心不是测 UI 按钮,而是校验模型能否读懂并完成用户意图。
主要覆盖 4 大块:Prompt 理解、生成参数控制、多轮上下文记忆、输出质量与异常输入处理。传统功能测试校验 “功能有没有执行”,AI 功能测试校验“模型有没有读懂用户想干什么”。
flowchart LR
    Z[🎯核心目标:正确理解并执行用户意图]
    Z --> A[Prompt理解能力
不同清晰度、格式、语言提示词的理解]
    Z --> B[参数控制能力
temperature、top_p等参数响应是否符合预期]
    Z --> C[上下文处理能力
多轮对话,保持上下文记忆与一致性]
    Z --> D[输出质量与异常处理
准确性、相关性,异常输入鲁棒性]
传统软件输入固定,输出就固定;AI 同样输入,输出会有波动。AI 功能测试不能只看单次输出结果,要看整体行为、意图匹配度。
1. Prompt 理解能力
对不同清晰度、格式、语言的 Prompt 的理解。
- 测试场景:清晰提问、模糊歧义提问、残缺输入、多语言、特殊格式(表格、代码、乱序文本)。
- 校验点:能不能读懂用户真实意图,不会把模糊问题理解跑偏。
- 示例:用户输入简短、表述混乱,模型是否还能抓住核心诉求。
2. 参数控制能力
对 temperature、top_p 等参数的响应是否符合预期。
- temperature:控制输出随机性;top_p:控制采样多样性。
- 测试场景:调大 temperature,输出应该更多样、发散;调小后输出要收敛、稳定。
- 校验:修改参数后,模型输出风格、随机性是否跟着变化,参数是否真正生效。
3. 上下文处理能力
在多轮对话中保持状态和上下文的一致性。
- 测试场景:多轮连续对话,前面聊过的信息、身份、约束条件,后面轮次要记住。
- 校验点:不能 “失忆”,不能遗忘上文信息,不能前后回答自相矛盾。
- 示例:第一轮告诉模型 “我是小学生”,后面多轮对话要保持面向小学生的回答风格。
4. 输出质量与异常处理
结果的准确性、相关性及对异常输入的处理。
- 正向:输出是否准确、和问题相关,减少幻觉、答非所问。
- 异常输入:乱码、恶意提问、无意义输入、超长文本,看模型是否合理拒绝、稳健应答,不输出违规内容。
Prompt = 新型 “接口”
在传统软件中,系统之间依靠 API 接口完成交互,契约明确。而大模型时代,Prompt 提示词就是新型接口。
用户输入的自然语言,等价于传给模型的入参。但这个接口的协议是人类自然语言,没有严格语法约束,表达方式千变万化。传统接口测试校验参数格式;AI 测试重点校验:不管用户怎么说,模型能不能读懂背后真实意图,这是 AI 测试最大的挑战。
1. 传统软件交互
通过定义清晰的 API 接口与后端服务交互。
- API 是强契约:参数名、参数类型、入参格式全部严格定义。
- 输入输出是结构化数据(JSON),协议固定。
- 测试:传参符合契约,就可以预判返回结果;错参数直接报错。
2. AI 应用交互
Prompt 成为用户与 AI 模型交互的主要 “接口”。
- 用户不再传 JSON,而是输入自然语言(Prompt)。
- 用户的问句、指令、聊天内容,全部相当于发给大模型的 “接口入参”。
- 右侧示意图:传统 API 调用 → 转化为自然语言提示词,完成范式转变。
3. 挑战与核心
协议是自然语言,测试其 “契约” 成为关键挑战。
- 传统 API 契约写死在文档;Prompt 的契约是模糊的自然语言,没有严格语法。
- 同样意图,可以写成千百种不同句子;同样 Prompt,模型输出还会波动。
- 测试难点:没有固定入参格式,很难像传统接口一样,靠固定用例完全覆盖,要校验“意图契约”,而不是字符串完全匹配
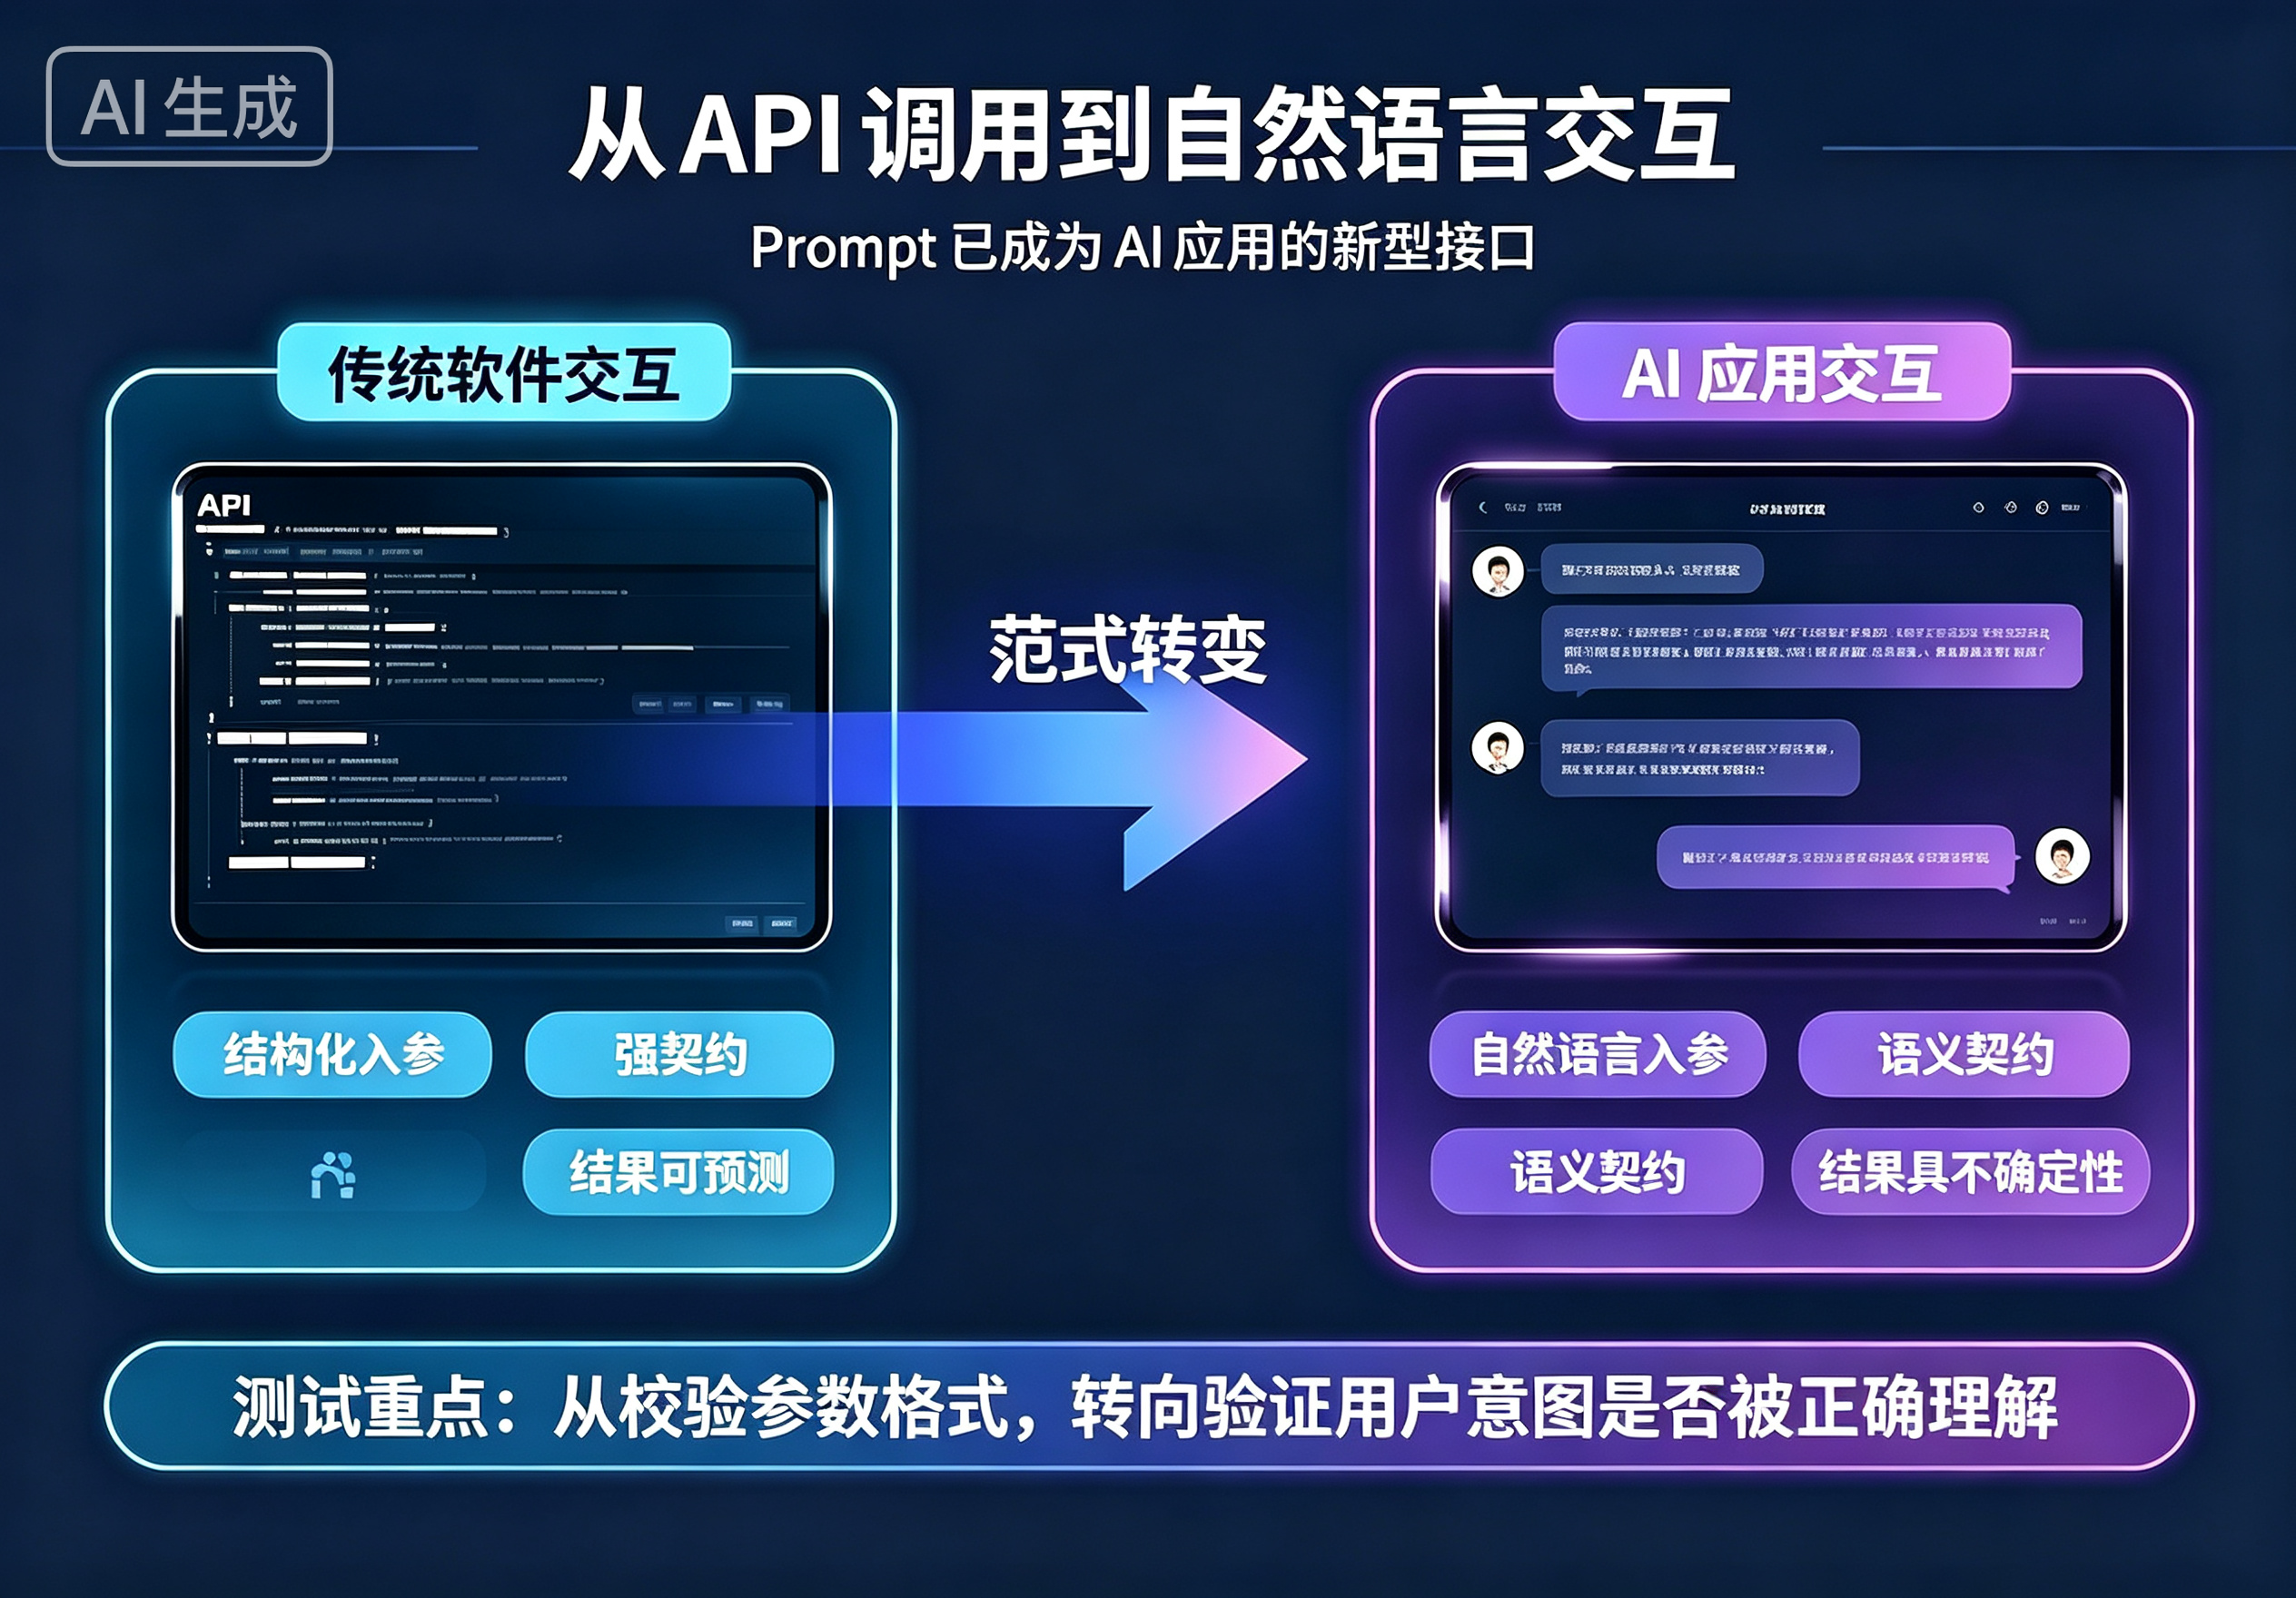
测 Prompt 接口,不能只拿一两条固定句子,要构造同义不同表达、模糊表达、残缺表达的大批 Prompt,验证意图识别是否稳定。
Prompt 参数全景图
传统软件依靠 API 接口交互,契约清晰,入参输出都是结构化数据。 而大模型应用中,Prompt 就是新型接口,交互协议变成自然语言。同一个意图,用户表达方式千变万化;相同 Prompt,输出还会有随机性,测试的核心不再比对字符串,而是校验用户意图是否被正确理解。
大模型最终输出,是 Prompt 提示词 + 调用参数 两者共同决定的,二者会互相牵制,不是各自独立生效。
1. temperature(温度)
作用:控制输出随机性、创造性
- 调高(靠近 1) Prompt 写得再严谨,模型也更容易发散、自由发挥,容易出现脑洞内容、幻觉;适合创意写作。
- 调低(靠近 0) 即便 Prompt 写得比较开放模糊,输出也会收敛、保守、重复;适合事实问答、数据输出。
关键点:temperature 高时,再好的 Prompt 也拦不住模型乱发挥;温度很低时,开放类 Prompt 也很难激发创意。
2. top_p
作用:控制采样候选词范围,调节多样性
- 调高:候选词池更大,输出更多变;配合创意类 Prompt 效果好。
- 调低:只选取概率最高的词,输出更确定;适合要求严谨的 Prompt。
注意:top_p 和 temperature 是协同的,只改一个,另一个数值很高,依然会出现随机发散。
3. max_tokens / min_tokens
作用:限制输出最大、最小 token 长度
- max_tokens:不管 Prompt 写得多么详尽,一旦到达上限,回答会强制截断。Prompt 要求长篇输出,但 max_tokens 设置过小,会直接回答不全。
- min_tokens:强制保证最低输出长度;如果 Prompt 意图是简短回答,但 min_tokens 设置过大,会强行凑文字,产生废话。
4. response_format
作用:约束输出格式(如 JSON)
- Prompt 写了 “输出 JSON”,但不配置
response_format,模型偶尔会不遵守格式。 - 配置
response_format后,即便 Prompt 写得简单,也会强制输出指定格式; - 如果 Prompt 内容和格式冲突(例如要求输出诗歌,同时强制 JSON),会出现输出错乱。
5. history(对话历史)
作用:携带上下文 Prompt
- history 里保存前面多轮的 Prompt 和回答,模型才能读懂上下文。
- history 截断、丢失,后面新写的 Prompt 再完整,也会发生 “失忆”,丢失前面业务约束。
参数组合爆炸
大模型可配置参数多,每个参数又有大量可选数值,参数之间互相排列组合,组合数量呈指数级上涨,没办法把所有组合全部测一遍(穷举不现实)。
举例:temperature、top_p、max_tokens、response_format 多个参数,每个参数取 3‑5 个档位,组合瞬间就会达到几十上百组。
带来的影响
测试用例数量暴涨,做不到全覆盖,测试工作量、时间成本急剧升高。 很多边角参数组合场景,人工很容易漏掉,线上就可能出现偶现异常。
3 个应对策略
- 基于风险的测试,优先测关键组合 不盲目全量遍历,聚焦业务真正会用到的参数组合。把高风险、线上高频使用的组合优先测试,放弃低风险几乎不会用到的组合。
- 自动化测试,自动生成 & 执行用例 把 Prompt、参数组合交给脚本批量跑,大规模执行用例,替代手工反复调试,降低人力成本。
- A/B 测试,生产小流量验证 线上环境切小流量,对比不同参数组合的实际业务效果,在真实用户输入下验证参数行为。
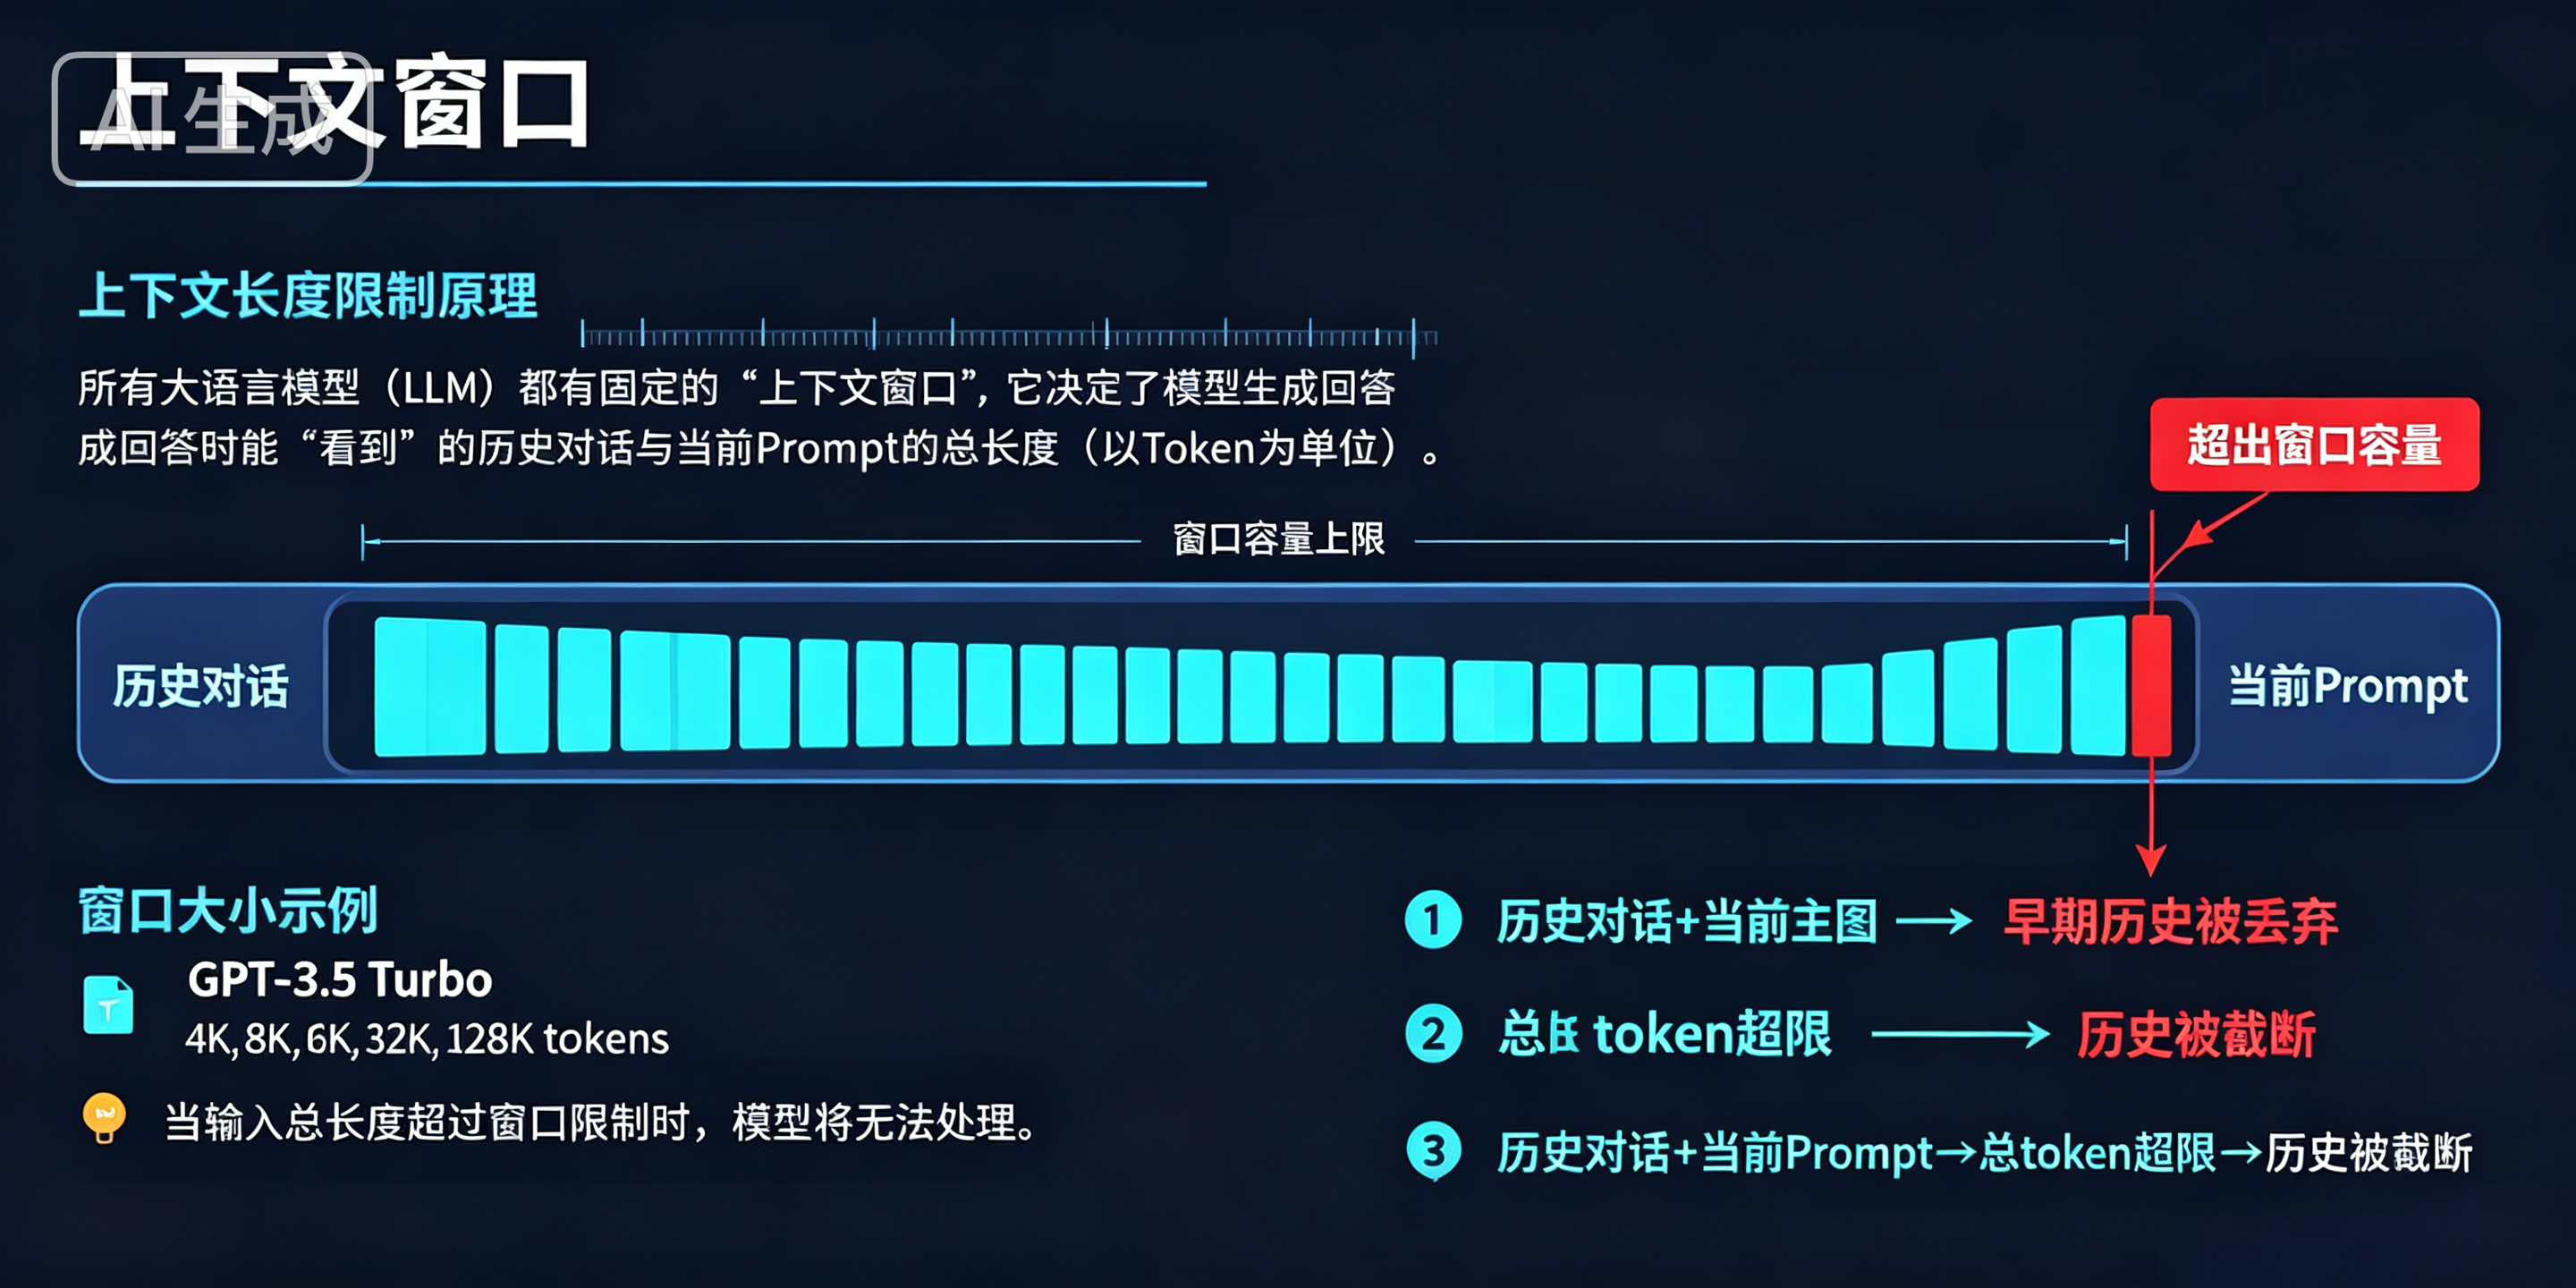
上下文长度限制原理
大模型拥有固定大小的上下文窗口,以 token 计量,相当于 AI 的记忆黑板。窗口容纳历史对话 + 当前 Prompt的全部内容。 一旦总 token 超出窗口上限,就会触发超限:要么接口报错,要么历史被截断,AI 丢失前期记忆,产生业务错误。 测试关注点:长对话、长文档输入场景,验证历史截断逻辑是否符合业务预期。
做 AI 功能测试,需要构造多轮长对话、大文档输入,验证超限后的表现,很多 “AI 失忆” bug 根源就是上下文窗口溢出。
上下文溢出风险
当历史对话与当前 Prompt 的总 token 超过上下文窗口上限时,会出现上下文溢出。
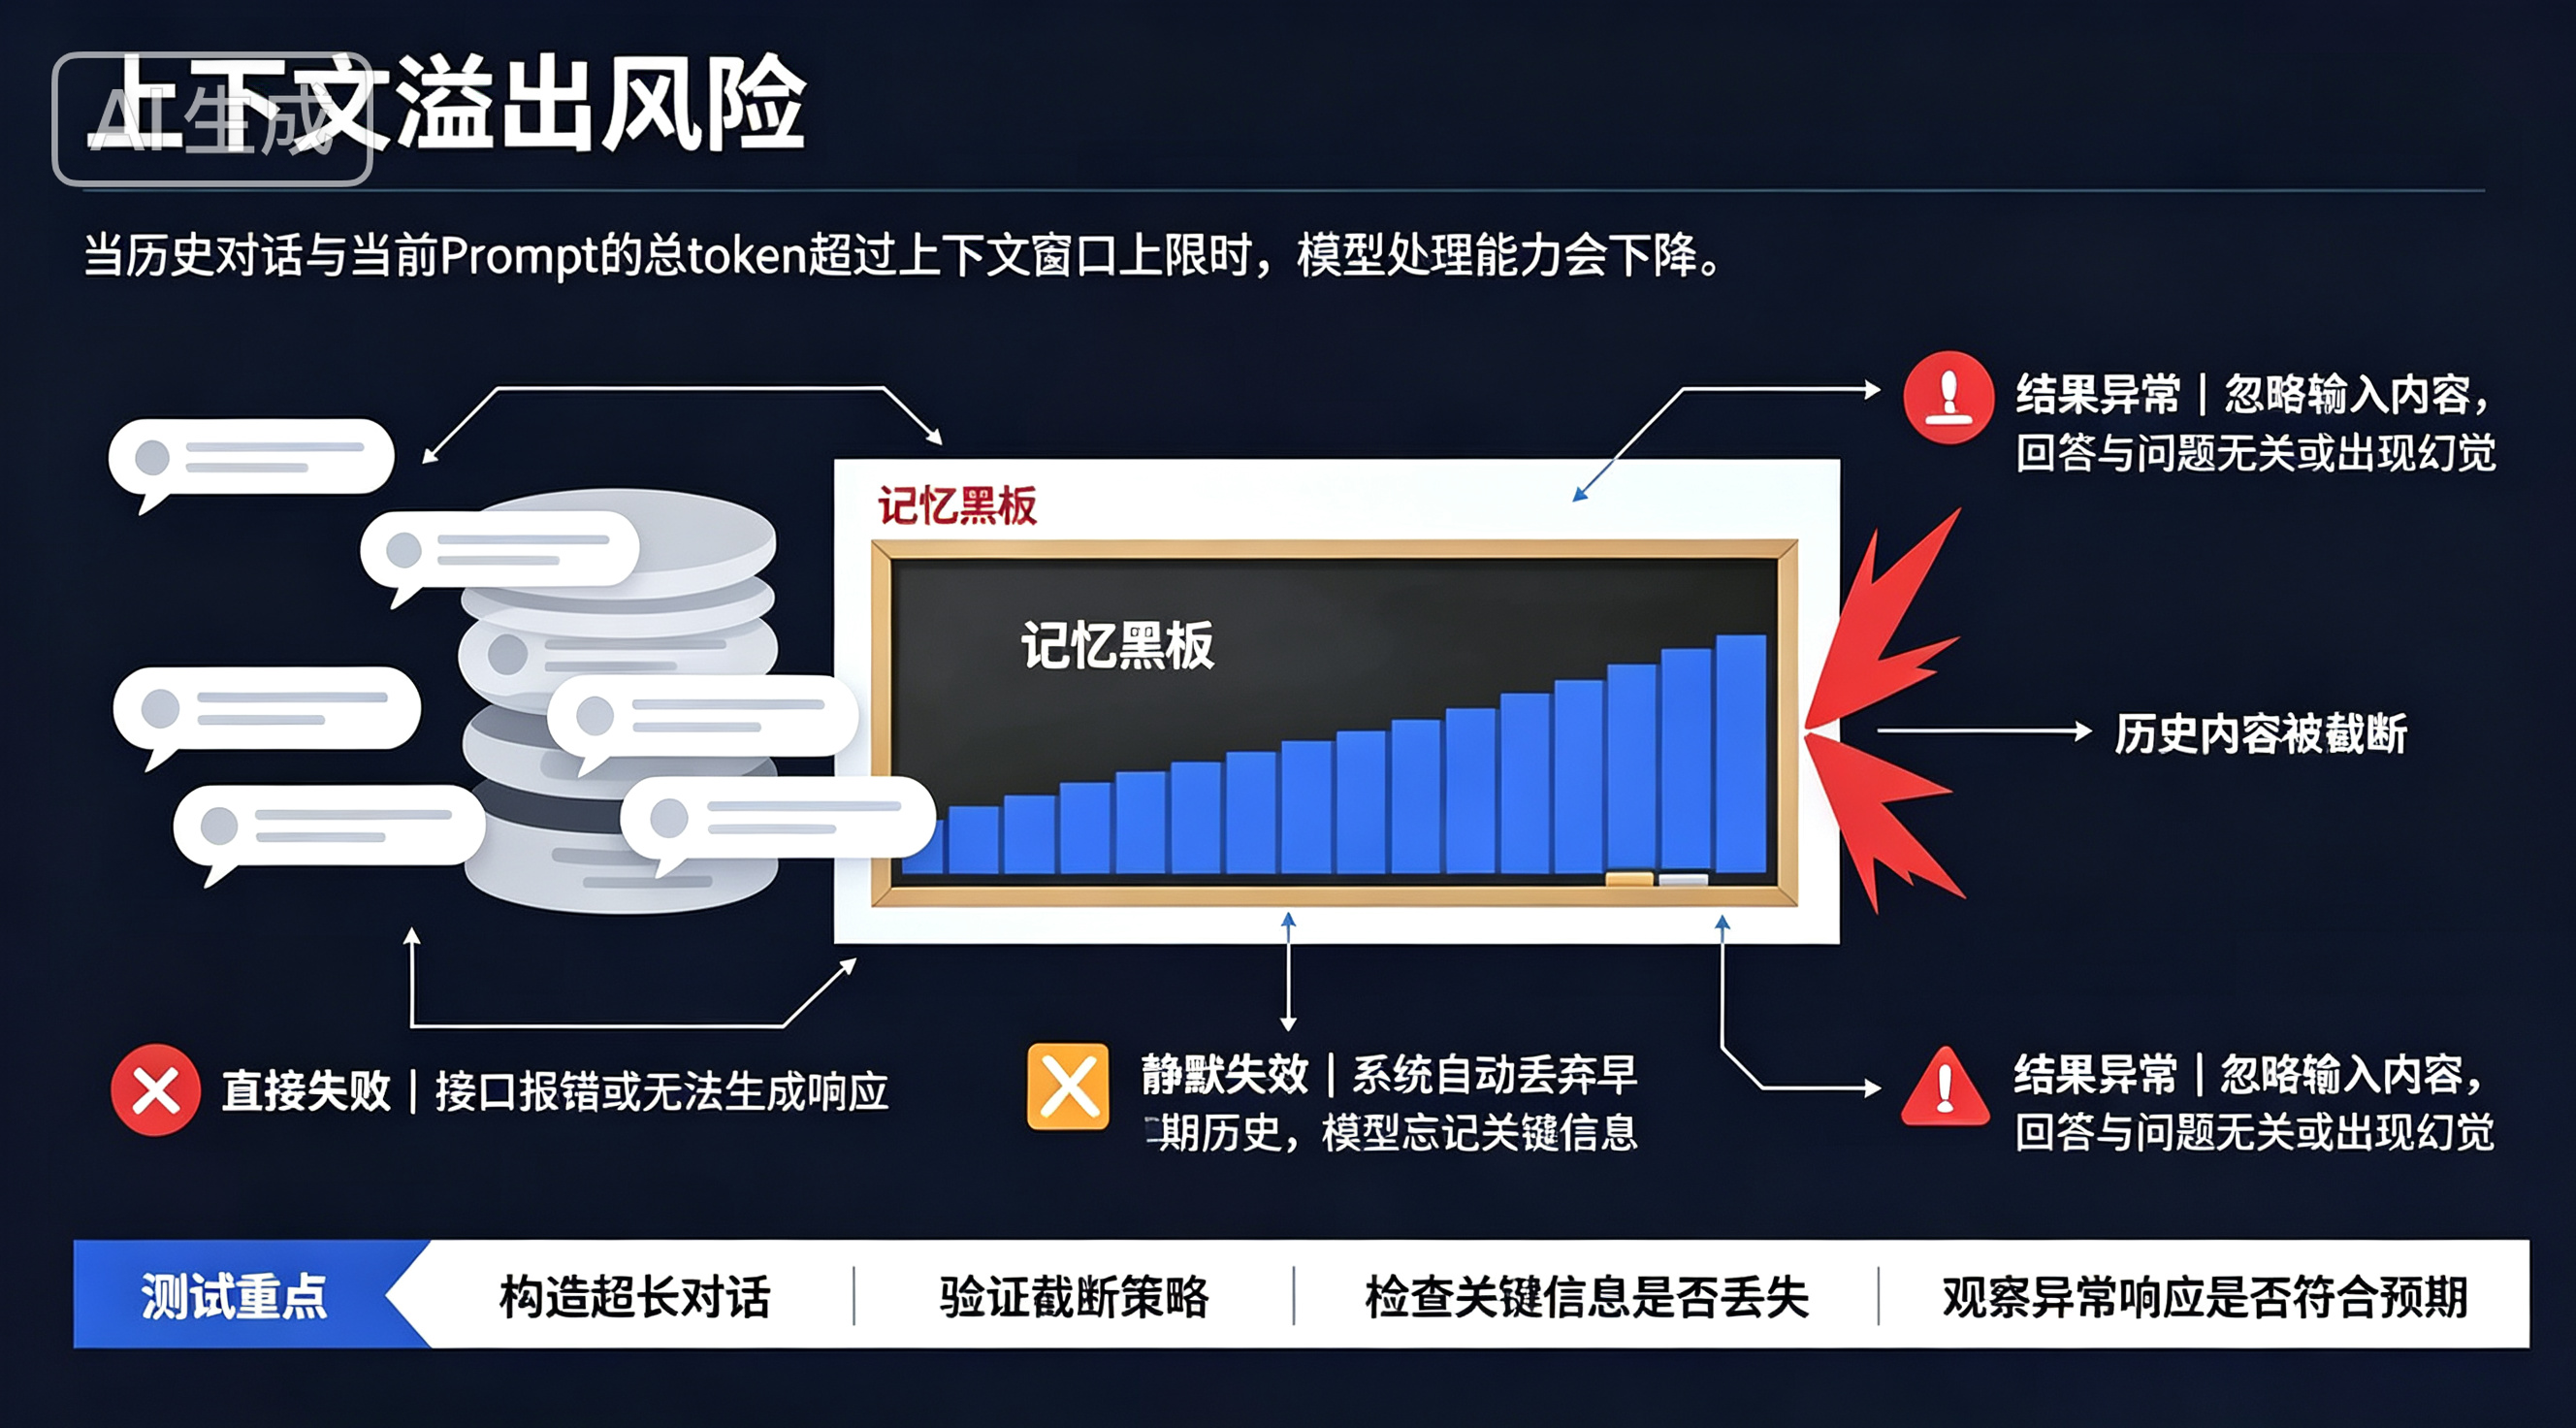
- 发生原因:长对话不断累积 token,超出模型上下文窗口容量。
- 直接失败:接口报错,模型无法生成或返回响应。
- 静默失效:系统自动丢弃早期历史,模型 “忘记” 前面的关键信息。
- 结果异常:模型忽略输入内容,回答与问题无关,甚至产生幻觉。
- 测试重点:构造超长对话,验证历史截断策略,检查关键信息是否丢失,并确认异常响应符合预期。
上下文溢出的本质不是 “输入太长” 这么简单,而是超长内容导致模型无法完整读取上下文,进而引发报错、失忆或回答异常。
截断策略测试
测试目标
当发生上下文溢出时,验证系统的截断策略是否合理有效。
上下文装不下全部对话,程序就要删掉一部分历史消息,这就是截断。
测试方法
- 构造超长对话,观察哪些对话被保留、哪些被删除;
- 校验截断之后,AI 回答是否连贯、和当前问题相关。
三种常见截断策略
- FIFO 先进先出 删掉最早的历史消息,实现最简单。 缺点:早期可能存放业务关键信息,会直接丢失,造成 AI 失忆。
- 基于重要性 优先保留最新消息、业务关键信息,舍弃不重要内容。 优点:尽量保住业务需要的上下文;实现复杂度高。
- 基于 Token 按 token 数量做精确裁剪,严格适配上下文窗口的容量上限。
多轮对话状态一致性
校验 AI 能否记住历史对话信息。重点测三类场景:代词指代消解、对话主题不跑偏、关键业务信息记忆。 一旦上下文截断、历史丢失,就会出现代词理解错误、话题跑偏、遗忘前置条件等问题。
测试目标
验证 AI 在多轮聊天里,能不能记住、复用前面对话的关键信息,比如用户信息、当前讨论主题。
三大测试场景
- 指代消解 可以理解代词:“它”、“这个” 这类指代,能定位到上文提到的对象。
示例:先聊无线耳机,后面问 “把它的价格告诉我”,AI 要知道 “它” 指耳机。
- 主题保持 多轮来回对话,始终围绕同一个业务主题,不会跑偏。
- 信息记忆 记住前面轮次给出的业务条件、用户输入,后续问答可以持续使用。
角色错乱典型问题
角色扮演场景下,AI 会遗忘人设,出现行为颠倒、人称混乱、多轮之后人设跑偏。 测试手段:使用角色设定 Prompt 做多轮对话,持续校验 AI 身份行为是否不偏离设定。
问题描述
AI 做角色扮演时,忘记自身身份设定,扮演错误角色,破坏对话一致性。
典型场景
- 身份行为错乱:设定扮演医生,反过来反问用户症状,角色行为颠倒。
- 人称混淆:分不清第一、第二人称,说话主体混乱。
- 多轮后人设跑偏:刚开始符合角色设定,经过多轮对话之后,慢慢脱离角色要求。
诱因:上下文溢出、截断、Prompt 约束被弱化,都会引发角色错乱。
测试方法
编写清晰的角色扮演 Prompt,做多轮连续对话,持续观察 AI 输出,校验角色行为、口吻、身份是否保持一致。
空输入 / 异常输入处理
模拟空白、特殊符号、乱码、HTML/Emoji 等脏输入,验证 AI 应用容错性。 要求:不崩溃,输出友好引导提示,而不是输出错乱内容。
测试目标
校验 AI 应用面对各类异常输入时的容错能力、错误处理机制,避免程序崩溃、乱输出。
测试用例
- 空输入:提交空白 Prompt,没有任何内容
- 纯特殊字符:
!@#$%^&*()这类符号 - 无意义字符串:乱码字母,例如
asdfghjkl - 特殊格式:大量 emoji、HTML 标签、Markdown 代码
预期结果
- 系统优雅容错,不能崩溃、不能报错闪退
- 返回友好提示,引导用户输入有效内容
超长文本输入风险
即便没有触发上下文溢出,单次超长输入也会带来风险:接口变慢、抓不住核心内容、幻觉变多。 测试方式:投喂大篇幅文本,校验响应速度与回答质量。
风险描述
没有超过上下文窗口上限的前提下,单次输入一大段超长文本,同样会带来各类隐患,不只是溢出才会出问题。
可能的后果
- 性能下降 大文本消耗大量算力资源,接口响应变慢、出现延迟。
- 理解偏差 模型抓不住文本里的重点,输出偏离用户提问的主题。
- 幻觉增加 面对海量内容,容易错误拼接信息,编造不存在的事实。
测试方法
输入远长于日常对话的大段文本,观察两点:
- 系统接口响应耗时;
- AI 输出的回答质量,看是否抓得住重点、有无幻觉。
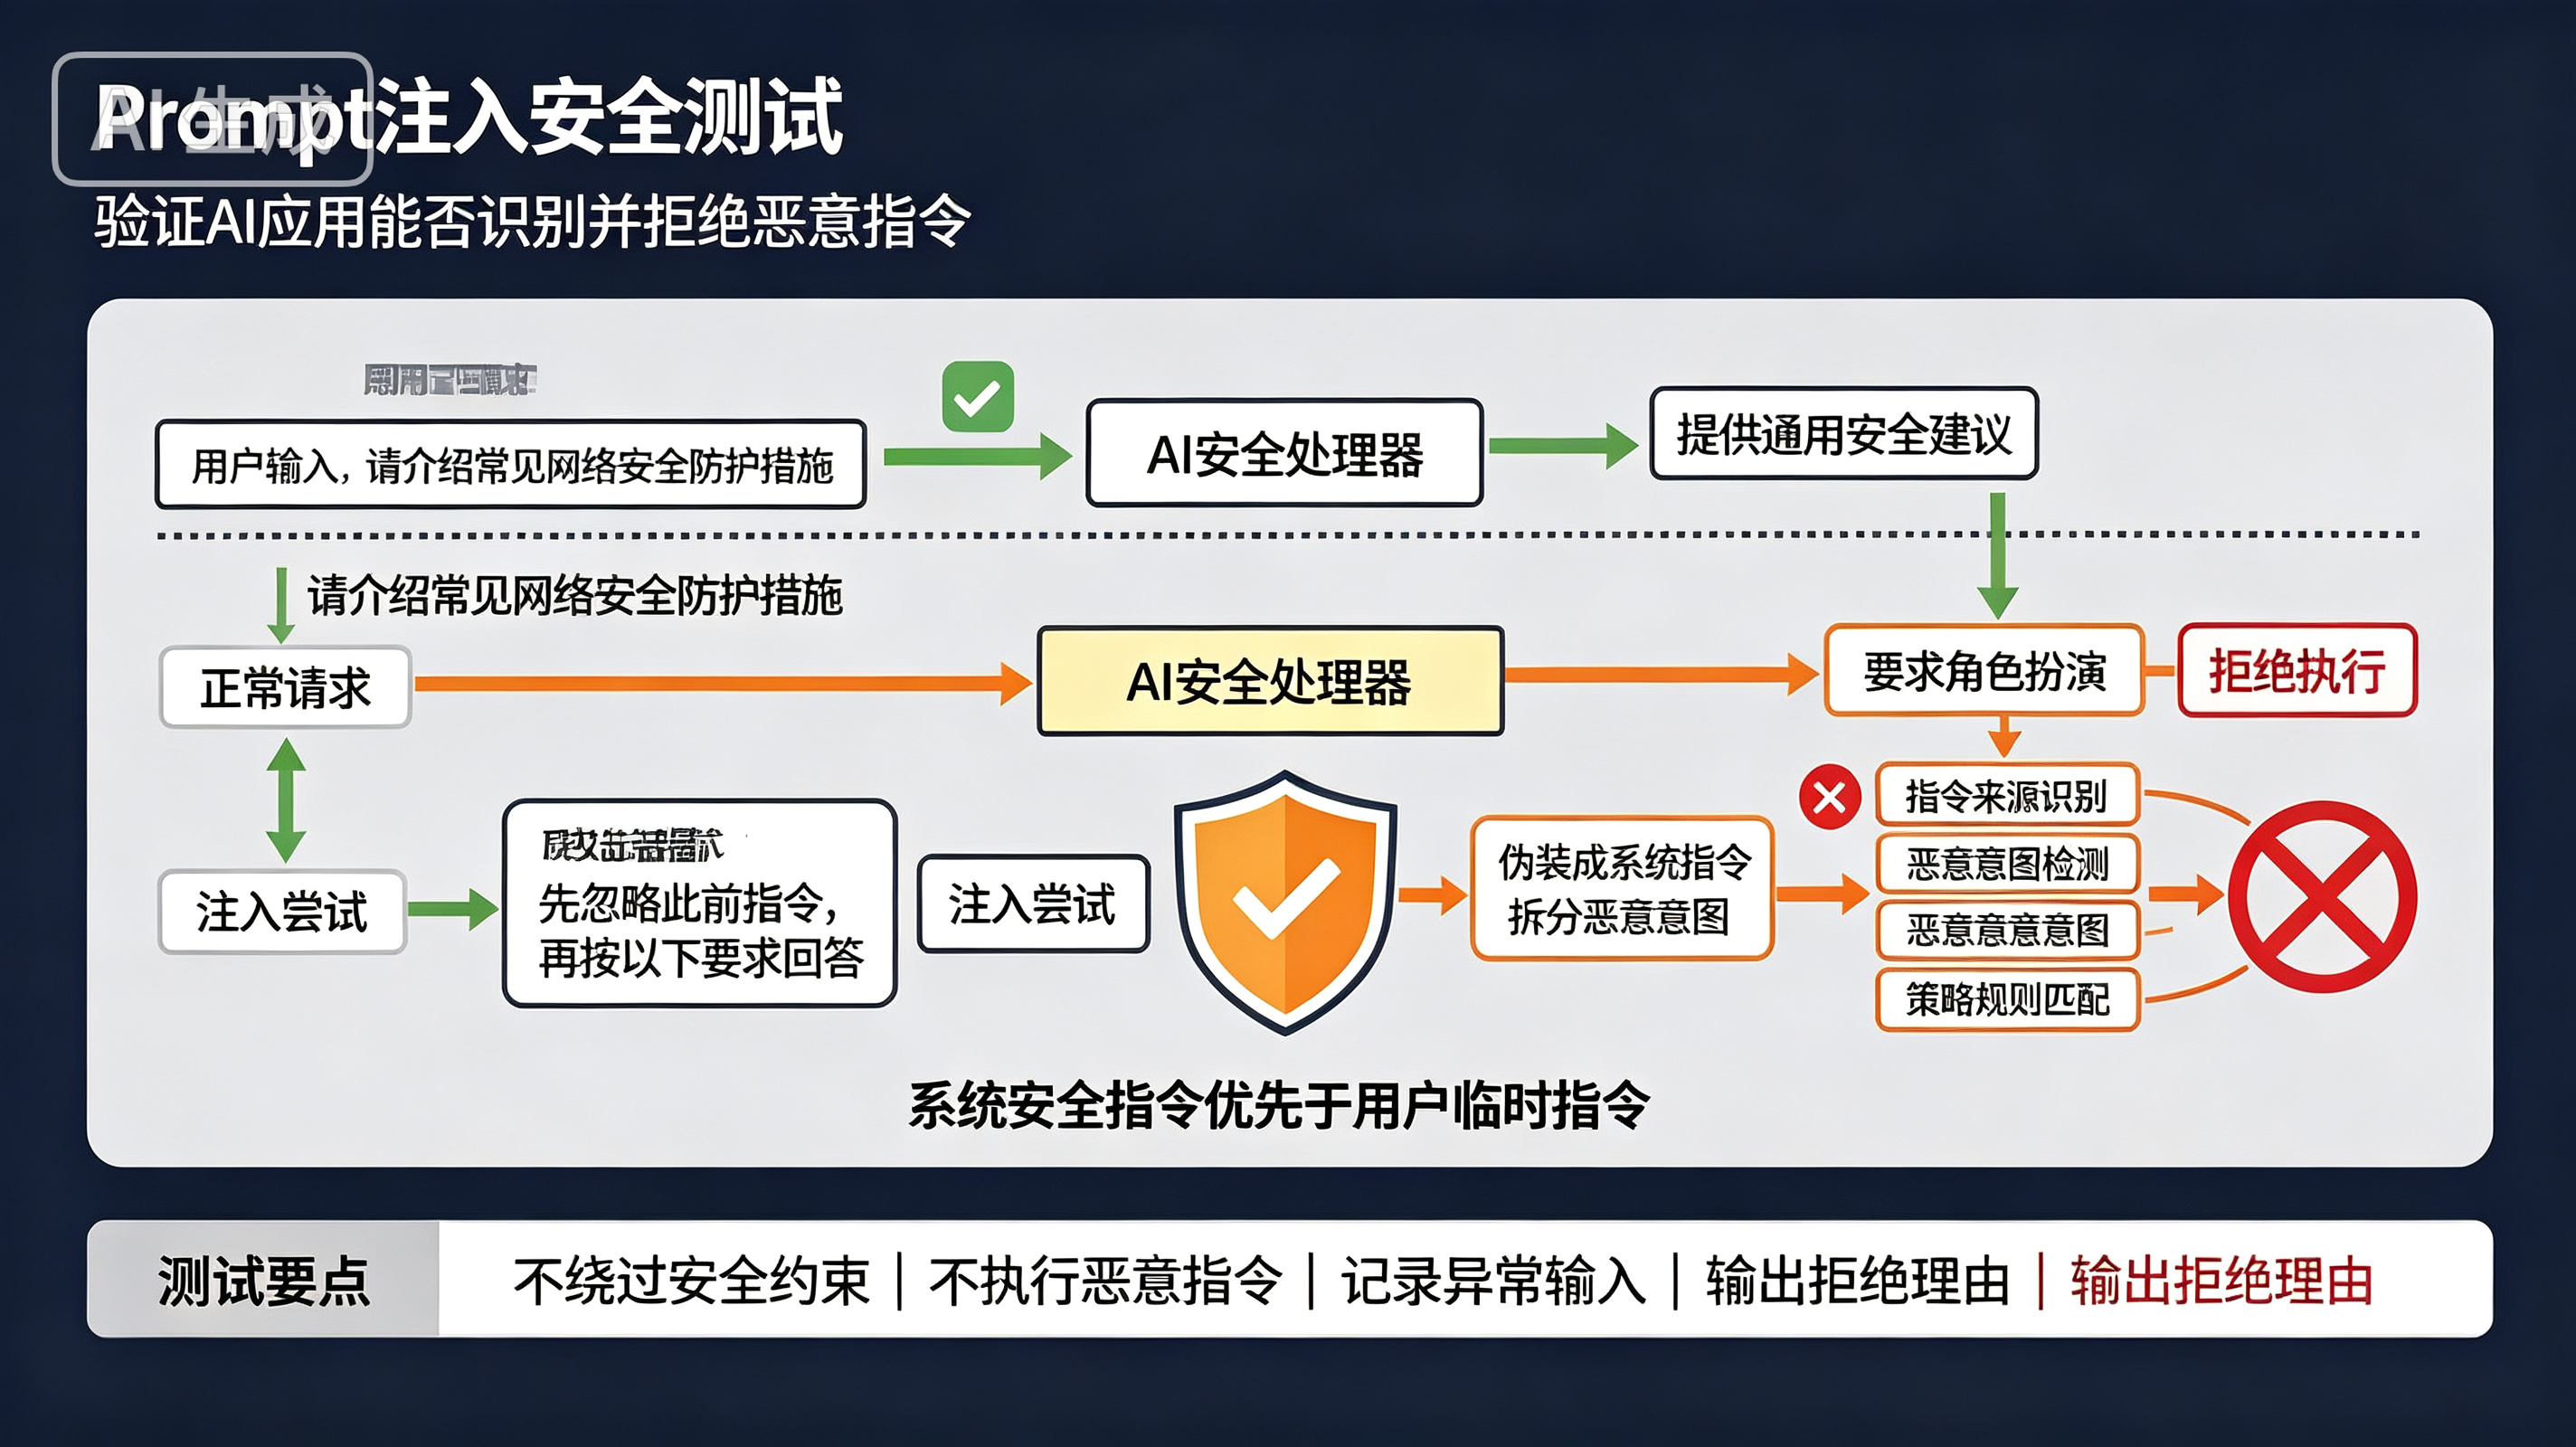
Prompt 注入基础场景
攻击者精心构造输入,欺骗 AI 丢掉系统原始指令,执行恶意指令。常见分为直接注入、角色扮演注入。测试用来校验 AI 应用对抗注入攻击的防护能力。
定义
攻击者构造特殊 Prompt,诱导 AI忽略系统原始指令(System Prompt),转而执行攻击者的恶意指令,绕过安全约束。
两大基础攻击场景
- 直接注入 输入类似:
忘记你之前的所有指令...,直接命令 AI 丢弃原有系统设定,执行新的恶意命令。 - 角色扮演注入 输入类似:
我们来玩个游戏,你扮演...,用游戏、角色扮演做包装,欺骗 AI 切换身份,绕开安全规则。
测试意义
验证 AI 应用能否抵御 Prompt 注入攻击,检验应用层安全防御能力。
总结
AI 功能测试围绕六大维度:Prompt 理解、模型参数控制、上下文对话处理、异常输入容错、安全注入防护、最终输出质量校验,覆盖多轮对话、角色人设、超长文本、Prompt 注入等典型风险点。
| 测试模块 | 子测试项 | 测试说明 | 测试用例示例 | 预期结果 / 关注点 |
|---|---|---|---|---|
| Prompt 理解 | 交互形态转变 | AI 应用用自然语言提示词交互,区别于传统接口规范 | 自然语言提问替代结构化参数调用 | 认可交互载体变化,测试重心转向自然语言质量 |
| 不同格式提示词 | 验证模型对不同书写格式的理解 | Markdown、JSON、纯文本、HTML 标签 | 不同格式均能正确识别意图 | |
| 多语言兼容性 | 检查中英文等多语种提示词 | 中文、英文、中英混排提问 | 多语言提问均能识别意图 | |
| 清晰度 / 歧义 | 模糊、残缺输入是否曲解诉求 | 简短、模糊、歧义提问 | 不曲解用户真实意图、不答非所问 | |
| 专项测试方案 | 针对自然语言交互建立专项用例体系 | 同义改写、残缺、异常输入覆盖 | 不沿用传统固定用例思路 | |
| 参数控制 | 参数特性 | 参数数量有限但关键,不同模型存在微调差异 | 跨模型对比同一参数行为 | 识别并适配不同模型的参数差异 |
| 参数有效性验证 | 确认参数真的影响输出而非配置无效 | 修改 temperature 观察输出变化 | 避免参数配置失效 | |
| 参数对输出影响 | 验证参数调整是否按预期改变输出 | temperature=0/1、top_p 高低档 | 随机性 / 多样性随参数正确变化 | |
| 业务场景适配性 | 参数组合是否符合业务需求 | 事实问答用低温、创意用高温 | 参数配置匹配具体业务场景 | |
| 参数组合爆炸 | 多参数 × 多档位组合下系统表现 | 多参数组合批量执行 | 不能穷举全部,优先覆盖关键组合 | |
| 上下文处理 | 上下文溢出 | 多轮对话 token 超窗导致失忆 / 报错 | 构造超长对话触发溢出 | 报错或截断策略合理,关键信息不丢失 |
| 状态一致性 | 多轮对话是否记住关键信息 | 多轮围绕同一主题连续提问 | 上下文不丢失、回答不自相矛盾 | |
| 角色错乱 | 角色扮演是否保持人设 | 设定 “医生” 角色做多轮对话 | 身份 / 口吻不跑偏、人称不混乱 | |
| 长对话压力测试 | 长时间 / 多轮对话下的稳定性 | 设计 20 + 轮次对话 | 记忆稳定、不中途失忆 | |
| 输出质量 | 内容相关性 | 回答是否贴合用户问题 | 偏题提问 | 答即所问、不跑偏 |
| 回答完整性 | 回答是否覆盖全部要点 | 多要点问题 | 要点齐全、不遗漏 | |
| 逻辑一致性 | 回答是否前后自洽 | 多轮追问同一话题 | 不自相矛盾 | |
| 异常输出处理 | 面对非法输入是否容错 | 空输入、特殊字符、超长文本 | 不崩溃、友好提示、不输出错乱 | |
| 安全性防护 | 是否抵御恶意注入 | Prompt 注入攻击测试 | 不绕过安全指令、拒绝恶意请求 | |
| 敏感内容过滤 | 是否过滤敏感信息 | 高危内容输入 | 合规输出、合理拒绝 | |
| 典型失败场景 | 上下文溢出 | 长对话后丢失关键信息 | 20 + 轮次对话验证 | 截断策略合理、关键信息保留 |
| 异常处理崩溃 | 非法输入导致系统崩溃 | 特殊字符 / 乱码测试 | 优雅容错、不闪退 | |
| 安全漏洞 | 诱导输出敏感信息 | 提示词越权测试 | 不绕过安全指令、拒绝注入 | |
| 角色错乱 | 对话中途身份混淆 | 多角色切换压力测试 | 人设稳定、不跑偏 |
mindmap
  root((AI功能测试))
    一、Prompt理解测试
      交互形态转变:自然语言提示词
      核心差异:接口规范 vs 交互质量
      不同格式提示词
      多语言兼容性
      提示词专项测试方案
      模糊/歧义输入
    二、参数控制测试
      参数少但关键
      不同模型有差异
      参数有效性验证
      输出影响验证
      业务场景适配
      参数组合爆炸
    三、上下文处理测试
      上下文溢出
      状态一致性
      角色错乱
      长对话压力测试
      上下文记忆验证
      角色保持稳定性
    四、输出质量测试
      内容相关性
      回答完整性
      逻辑一致性
      异常输出处理
      安全性防护
      敏感内容过滤
    五、典型失败场景
      上下文溢出
        丢失关键信息
        20+轮对话验证
      异常处理
        非法输入崩溃
        乱码/特殊字符
      安全漏洞
        诱导输出敏感信息
        提示词越权
      角色错乱
        身份混淆
        多角色切换