AI系统为何频繁“翻车“?强大的 AI,也有不可忽视的短板
现在 AI 能力越来越强,但我们时常能看到 AI 出错的新闻:自动驾驶撞车、大模型一本正经胡说八道、人脸识别认错人、刷短视频越刷越停不下来。
很多人以为 AI 无所不能,实际落地中却频繁 “翻车”,主要集中在 4 大典型问题:
🚗 1. 自动驾驶:复杂现实场景下的致命误判 AI 在训练环境表现优秀,但真实道路充满各种突发、非常规状况。当遇到训练数据没有充分覆盖的复杂路况,自动驾驶算法会发生识别误判,极端情况下会酿成交通事故。
🤖 2. 大模型幻觉:看似有理有据,实则全是编造 ChatGPT 这类生成式大模型,并不是真正 “理解” 知识,而是基于统计概率生成通顺文本。它经常输出逻辑通顺、格式完整,但事实完全错误的内容,虚构案例、文献、数据,很容易误导使用者。
👤 3. 算法偏见:AI 会继承人类数据里的歧视 AI 的能力来源于训练数据,如果数据集本身就带有现实世界的偏见,算法就会复刻这种不公。典型就是早期人脸识别,不同种族人群识别准确率差距巨大,带来公平性与伦理风险。
📱 4. 算法推荐:信息茧房与用户沉迷 个性化推荐算法以提升用户停留时长为目标,不断投喂同类偏好内容。长期下来把人困在信息茧房,视野越来越狭隘,同时催生过度沉迷等社会问题。
写在最后
AI “翻车” 本质来源于三点:
- 真实世界无穷复杂,训练数据永远无法穷尽全部场景;
- 模型底层机制自带缺陷,概率生成、数据偏见难以彻底根除;
- 商业目标导向的算法,会带来意料之外的社会副作用。
AI 是强大工具,但不能无条件信任。无论是开发者还是普通使用者,都要建立对 AI 输出结果的校验意识,AI 治理、AI 测试也会成为行业必不可少的一环。
传统软件测试的底层基础:确定性
核心思想:确定性流程
Input输入 → Process处理 → Output输出,整个链路行为是确定的。 三大核心特征:
- 明确可预测的逻辑 :软件是写死的代码、固定算法、业务规则驱动。程序逻辑是开发人员写死,没有随机,行为可以提前预判。
输入输出严格对应:相同的输入,无论跑多少次、什么时候跑,输出一定完全一样。 这就是确定性。同一个请求,反复执行,结果不会飘忽不定。
验证 “正确性” 为核心目标 :测试工作很清晰:给输入,算出预期正确结果,拿程序实际输出和预期对比。
flowchart LR
    subgraph 软件执行链路
        A["输入(给定、确定)
固定、已知的输入数据/指令"]
        C["软件处理(明确逻辑)
预设代码逻辑,无随机、无模糊运算"]
        D["输出(唯一、确定)
相同输入,必然得到相同结果"]
        A --> C --> D
        A --> B[处理模块]
    end

    B --> E{测试验证}
    D --> F[预期正确结果]
    F --> E

    E -- 一致 --> G["🟢测试通过
一致"]
    E -- 存在偏差 --> H["🔴测试不通过,
存在缺陷"]
传统软件测试建立在「确定性」基石之上。代码逻辑是开发预先定义完成,相同输入,无论执行多少次,都将得到完全一致的输出。测试工程师可以提前构造测试用例,明确预期结果,只要实际输出和预期不符,就是缺陷。
但是这套成熟的方法论,面对生成式 AI 就遇到巨大挑战:大模型具备概率性、非确定性。同样输入,每次输出都可能不一样,不存在唯一 “标准答案”,我们不能简单用 “对 / 错” 二元来判定结果。这也是 AI 测试和传统软件测试最本质的区别
Assert 思维在 AI 系统中的失效
在传统自动化测试中,我们依赖 assert(output == expected_output) 断言。给定输入,预期结果是确定值,程序输出只要和预期不完全相等,就判定为缺陷。
但是这套全等断言思维,面对 AI 系统直接失效。大模型输出是动态变化的,不存在唯一标准答案。我们想校验的变成:assert(output is "good enough"),可 “足够好” 本身是模糊概念,无法简单用一行等式表达。
AI 测试最大难题:如何把主观的 “足够好”,转化成客观、可自动化执行的判定标准。
| 项目 | 传统软件 Assert | AI 系统 |
|---|---|---|
| 断言表达式 | assert(output == expected_output) |
assert(output is "good enough") 无法直接实现 |
| 预期结果 | 唯一、固定标准答案 | 无唯一标准答案,只有好坏程度 |
| 判断逻辑 | 二元:对 / 错 | 多维度评估:是否足够好 |
| 自动化方式 | 字符串全等比对 | 需要评测指标、打分、LLM-as‑Judge 等手段 |
AI 系统的三大特征
1. 概率性
输出是一个概率分布,而非确定值。AI 系统给出的答案,其实是它认为可能性最高的选项。
- 大模型不是 “计算标准答案”,而是统计概率,从海量文本里预测下一个最可能出现的词。
- 它会生成多条潜在答案,最终返回概率最高的那一条,不是唯一正确答案。
举例:同一个问题,模型内部有很多种合理回答,只是挑了概率最大的输出。
2. 黑盒性
模型的决策过程难以解释。我们只知道输入和输出,却无法理解中间复杂的计算和推理过程。
- 神经网络是亿万参数矩阵运算,输入进去,结果出来,但中间为什么得出这个结论,人类很难拆解追踪。
- ✅传统软件:代码逻辑透明,每一步流程都可以看得到;
- ❌AI 模型:是黑盒子,只看得见输入 prompt 和输出文本,内部推理逻辑不可读。
问题:出现幻觉、偏见错误时,很难定位到底是哪一段参数、哪部分数据导致出错。
3. 非确定性
相同的输入可能产生不同的输出。这是由模型的随机性和概率性本质决定的。
- 即使是完全一模一样的提问 Prompt,多次请求,返回的回答也不完全一样。
- 模型内部采样存在随机参数(temperature 温度等),会从概率分布中抽样,每次抽出来的结果会有差异。
传统软件基于确定性代码逻辑,而 AI 的概率、黑盒、非确定三大特性,直接摧毁了传统测试的基础:
- 不能再用固定预期结果做全等断言;
- 不能简单用 “对 / 错” 二元判断;
- 错误难以复现、难以定位根源。
flowchart LR
    P["输入Prompt"] --> M["AI大模型(黑盒)"]
    M --> D["概率分布"]
    D -->|采样1|O1["输出结果A"]
    D -->|采样2|O2["输出结果B"]
    D -->|采样3|O3["输出结果C"]
同一输入,多次输出不一致
我们用一个简单例子来理解 AI 的非确定性:输入提示词 “写一首关于春天的诗”。
- 如果是传统软件:开发写死逻辑,每次只会返回同一首固定诗歌。测试用例可以写死预期结果字符串,直接做全等断言。输出不一样 = bug。
- 如果是 AI 大模型:同样输入,每次运行可能产出不同的古诗。《春晓》、《咏柳》都可以是正确答案。不存在唯一标准答案。
AI 测试的评判逻辑发生根本变化:不再判断输出 “等于某个固定结果”,而是校验输出是否落在可接受的预期范围之内。只要满足 “主题是春天” 这个约束条件,多种不同输出全部视为合格。
| 项目 | 传统软件(写春天的诗) | AI 大模型(写春天的诗) |
|---|---|---|
| 相同输入 | 每次输出完全相同 | 每次输出可以不一样 |
| 预期结果 | 唯一固定诗歌文本 | 预期范围:满足「春天主题」即可 |
| 测试判断 | assert(output == "固定诗歌") |
校验输出是否满足约束条件集合 |
| 测试结果 | 二元:通过 / 不通过 | 范围内即为合格,允许多种正确答案 |
flowchart LR
    subgraph 传统软件
        A_in["输入:春天主题诗"] --> B["传统软件处理"]
        B --> C["唯一输出:固定诗歌文本"]
        C --> D{测试验证}
        D --匹配--> D1["✅通过"]
        D --不匹配--> D2["❌不通过"]
    end

    subgraph AI模型
        A_in2["输入:春天主题诗"] --> M["AI模型处理
(非确定性逻辑)"]
        M --> O1["输出1:春晓"]
        M --> O2["输出2:咏柳"]
        M --> O3["输出3:早春呈水部张十八员外"]
        O1 --> V{测试验证}
        O2 --> V
        O3 --> V
        EXP["预期范围:符合春天主题,可接受"] --> V
        V --> OK["🟢符合主题 → 接受"]
    end
AI 测试:预期不再是单个标准答案,而是一个合格范围。只要落在范围内,全部算合格。
Temperature / Sampling 的影响
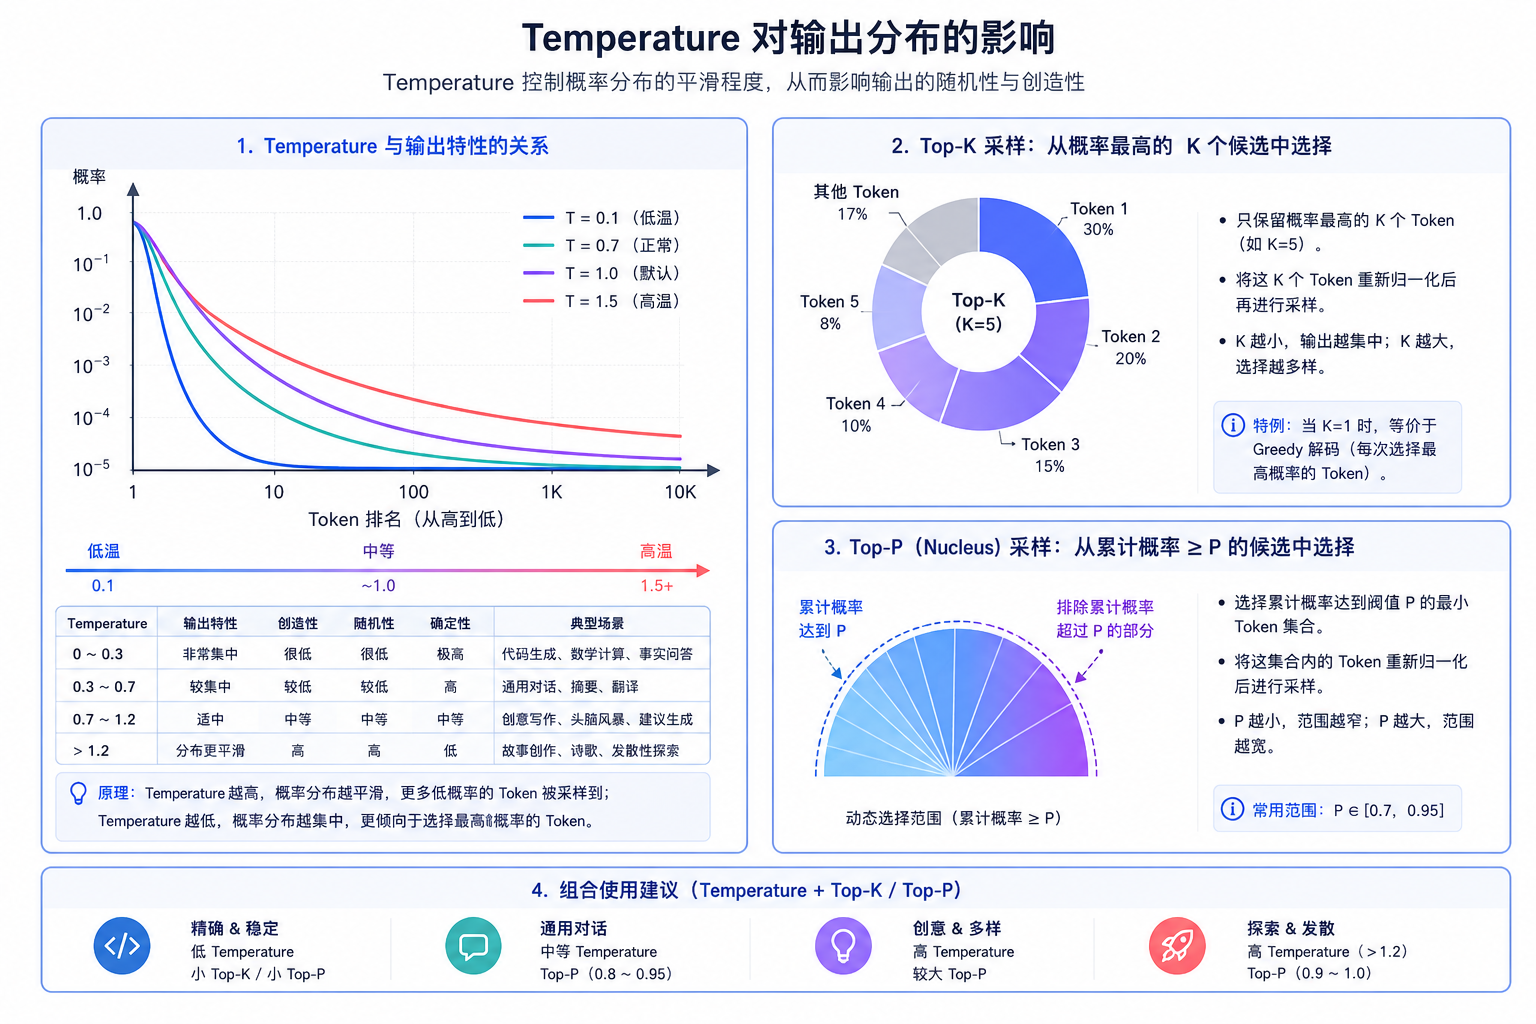
AI 输出的非确定性不是模型 bug,是由生成参数控制的特性。
Temperature(温度):调节随机性开关。低温模式,模型倾向选择概率最高结果,输出稳定准确;调高温度,模型会允许更多低概率候选词参与生成,内容更有创意,但幻觉风险同步增加。
Sampling 采样策略 Top‑K / Top‑P:决定模型如何从概率分布里挑选词语。
- Top‑K:始终从概率最高 K 个词中做选择;
- Top‑P:选取累计概率达到阈值 P 的候选词集合,候选池动态变化。
正是 Temperature + Sampling 共同作用,造成相同 Prompt,多次调用得到不一样的回答。
💡对 AI 测试的启示: 做 AI 系统测试的时候,temperature 是重要变量。
- 做事实类、准确性测试:建议调低 temperature,减少随机干扰,方便复现问题;
- 做创意场景测试:需要覆盖高温参数,验证模型在发散情况下会不会产出有害、错误内容。 测试用例不能只跑一套参数,不同温度、采样配置都要纳入测试范围。
| 参数 | 取值 | 效果 | 测试场景建议 |
|---|---|---|---|
| Temperature | 0.1‑0.5 低温 | 输出保守稳定,准确率高 | 事实问答、代码、需要可复现的评测 |
| Temperature | 1.0+ 高温 | 随机、创造力强,易幻觉 | 创意生成、故事,要重点校验安全性 |
| Top‑K | 固定 K 值 | 固定数量候选词采样 | 场景可控 |
| Top‑P | 0~1 概率阈值 | 动态候选词集合 | 工业界大模型常用 |
规则系统 vs 概率系统
传统软件本质是规则系统,由人编写大量 IF‑THEN 条件逻辑。行为确定可预测,出问题可以追踪代码,测试目标是验证结果的正确性。
AI 大模型属于概率系统,依靠统计模型,输出是概率驱动,行为无法完全预测。调试不能简单跟踪代码,需要分析数据与模型。
这带来测试理念的根本变革: 传统软件测试:验证正确性; AI 系统测试:评估风险与可接受性。
AI 测试不再追求 “每一次输出完全等于固定预期”,而是评估输出是否落在可接受区间,识别幻觉、偏见、安全等各类风险。
| 特征 | 规则系统(传统软件) | 概率系统(AI) |
|---|---|---|
| 核心 | IF‑THEN 逻辑(if 判断,硬编码分支) | 统计模型(海量数据学到的统计规律) |
| 输出 | 确定的,相同输入固定输出 | 概率性,同一输入可以产出多种输出 |
| 行为 | 可预测,逻辑写死,行为可控 | 不可完全预测,存在随机性 |
| 调试 | 追踪代码,断点、看堆栈,定位代码行 | 分析训练数据、模型权重,黑盒难以定位 |
| 测试 | 验证正确性:判断对 / 错,验证是否符合预期结果 | 评估风险和可接受性:不再追求绝对正确,评估输出是否落在可接受范围、风险高低 |
flowchart LR
    subgraph 规则系统[传统软件]
        direction TB
        IN1["输入"] --> CODE["IF‑THEN 代码逻辑"]
        CODE --> OUT1["确定输出"]
        OUT1 --> TEST1["测试:验证正确性 ✅/❌"]
    end

    subgraph 概率系统[AI]
        direction TB
        IN2["输入"] --> MODEL["统计模型(概率采样)"]
        MODEL --> OUT2["多种可能输出"]
        OUT2 --> TEST2["测试:评估风险、可接受范围"]
    end
测试目标发生根本转变
传统软件测试追求100% 正确性。基于明确业务规则,每个输入对应唯一确定的预期输出,测试是二元判断:要么通过,要么失败。
AI 大模型属于概率系统,不存在唯一标准答案。AI 测试不再追求绝对 100% 正确,而是追求风险可控的可接受性。
测试范式从简单二元 “通过 / 失败”,升级为多维度全面评估:综合考察模型准确性、鲁棒性、安全性、公平性等指标,做风险权衡,只要风险落在业务可接受阈值内,即可放行。
flowchart TD
    subgraph 底层系统本质
        direction TB
        R1[规则系统
传统软件]:::rule --> R2[IF‑THEN硬编码逻辑]
        A1[概率系统
AI大模型]:::ai --> A2[统计模型+概率采样
Temperature / Top‑K]
    end

    subgraph 输入输出特征
        direction TB
        R2 --> R3[相同输入 → 唯一确定输出]
        A2 --> A3[相同输入 → 多种合理输出
存在不确定性、幻觉]
    end

    subgraph 测试模式
        direction TB
        R3 --> R4[传统测试:二元判断
预期结果写死]
        A3 --> A4[AI测试:多维度综合评估
无唯一标准答案]
    end

    subgraph 判定逻辑
        direction TB
        R4 --> R5{断言:实际 == 预期}
        R5 -->|匹配| R6[Pass 通过]
        R5 -->|不匹配| R7[Fail 缺陷bug]

        A4 --> A8[多维度打分
准确性|鲁棒性|安全性|公平性]
        A8 --> A9{风险是否在业务阈值内}
        A9 -->|风险可控| A10[可接受放行]
        A9 -->|风险超标| A11[判定问题,需要优化]
    end

    subgraph 测试目标
        direction TB
        R6 & R7 --> R12[目标:追求100%正确性]
        A10 & A11 --> A12[目标:追求风险可控的可接受性]
    end

    classDef rule fill:#164e70,stroke:#40b8f0,color:#fff
    classDef ai fill:#502870,stroke:#c078ff,color:#fff
风险控制视角下的 AI 测试
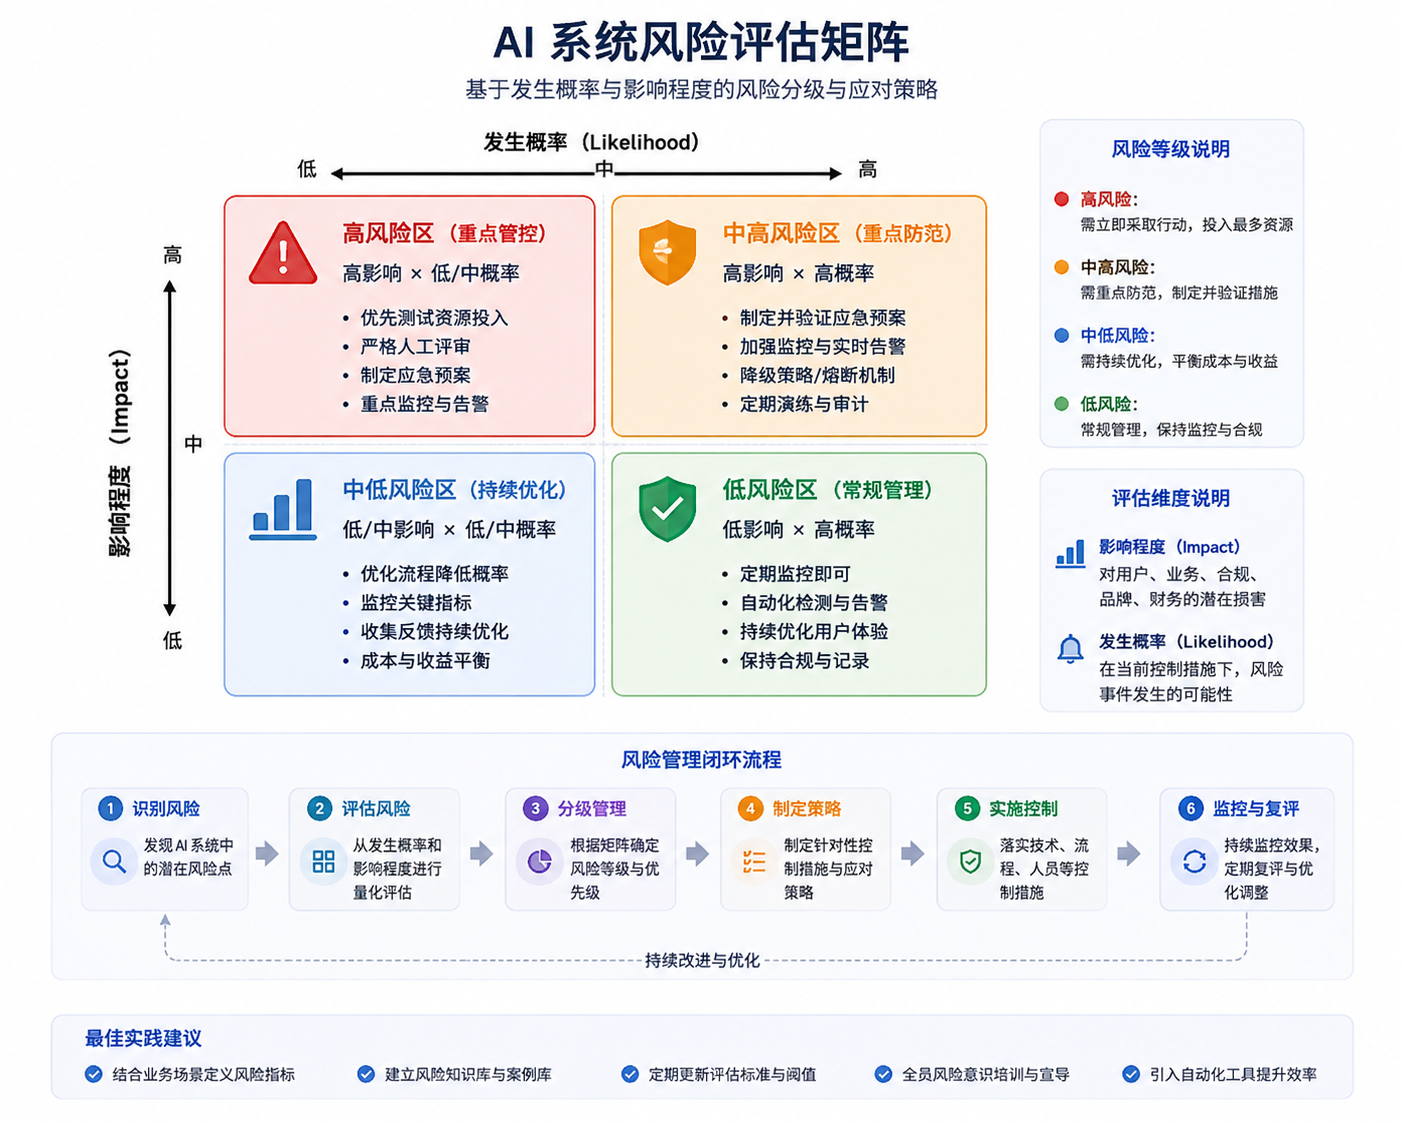
AI 测试的核心是识别、评估并管控 AI 系统落地的潜在风险。我们使用风险矩阵,从发生概率与影响程度两个维度量化风险。
- 高风险区:后果严重,优先投入测试资源;
- 中高风险区:容易触发且危害大,需要业务侧配套应急预案兜底;
- 中风险区:高频但危害有限,通过流程优化降低出现频次;
- 低风险区:影响很小,采取定期线上监控即可。
AI 测试讲究资源最优配置,把有限测试资源聚焦高风险场景,而不是追求全部场景 100% 覆盖。
AI测试的核心关注点
AI 测试包含六大核心关注点,每个维度结合实际例子理解:
- 功能性:系统是否能完成预期任务? 核心看核心功能准确性、任务目标达成度。
示例:文档摘要模型,输入一份会议纪要,检验输出摘要是否完整提炼会议决议,不编造不存在的信息。
- 鲁棒性:系统在异常输入下的表现? 关注对抗攻击处理、边缘案例稳定性。
示例:给模型输入满是错别字、无意义符号的文本(例如:政治、色情、事实不存在相关的信息),模型不能生成虚假答案,应做到识别异常输入,合理处理。
- 性能:系统的响应时间和吞吐量? 关注响应时间、吞吐量、资源利用率。
示例:在线客服大模型,高峰期大量用户同时访问,保证每个请求响应不超过 3 秒,GPU 资源不会耗尽。
- 安全性:系统是否容易受到攻击? 关注异常输入防御、数据隐私保护。
示例:测试提示词越狱攻击,模型不能被诱导输出暴力、诈骗内容;同时不能吐出训练数据中存储的用户手机号等隐私。
- 公平性:系统是否存在偏见? 关注无偏见决策、群体平等对待。
示例:AI 招聘打分工具,相同能力的简历,不会因为性别、籍贯得到差异巨大的评分。
- 可解释性:系统的决策是否可理解? 关注决策逻辑透明度、结果可追溯性。
示例:AI 信贷评估给出 “不予通过” 的结论,需要展示判断依据,比如参考了哪些流水数据,而不是只返回一个最终结果。
mindmap
  root((AI测试
核心关注点))
    功能性
      核心功能准确性、任务目标达成度
    鲁棒性
      对抗攻击处理、边缘案例稳定性
    性能
      响应时间、吞吐量、资源利用率
    安全性
      异常输入防御、数据隐私保护
    公平性
      无偏见决策、群体平等对待
    可解释性
      决策逻辑透明度、结果可追溯性
模型黑盒性与可解释性的冲突
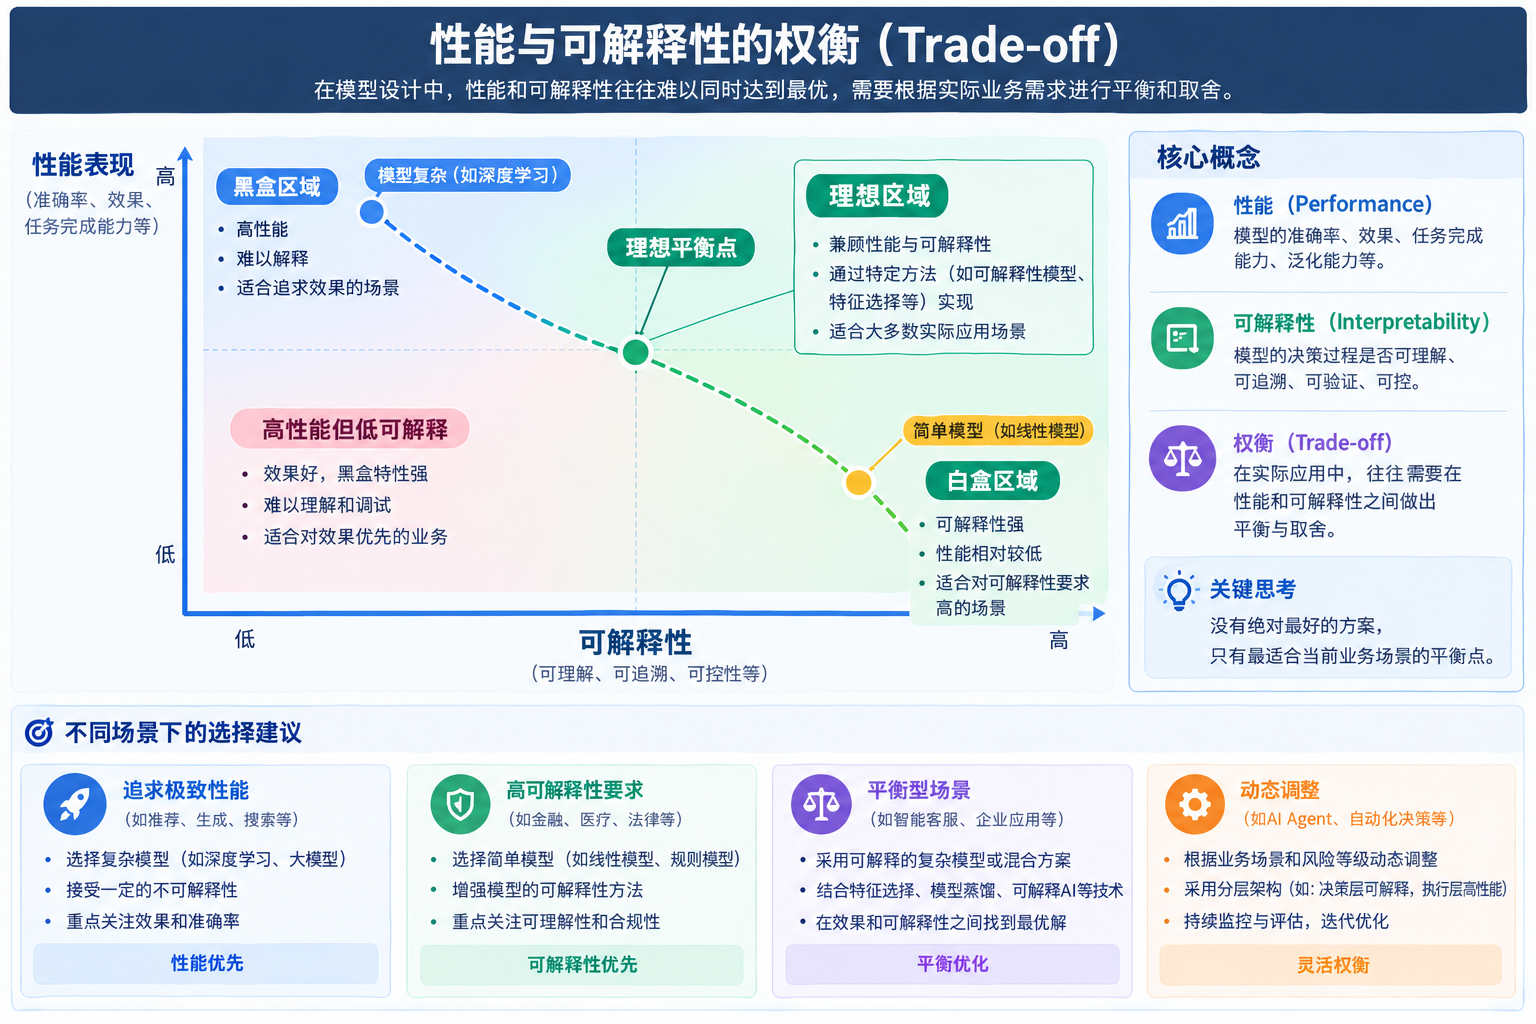
AI 模型存在一个经典矛盾:模型越复杂,预测、生成性能越好,但同时就会变成黑盒,决策逻辑越来越难解释。
简单模型如决策树是白盒,每一步判断都清晰,但能力上限不足;大语言模型这类复杂模型能力很强,但输出结果难以溯源。
AI 测试的核心不是二选一,而是做权衡:保障业务性能满足要求,同时借助技术手段,尽可能提高模型的透明度与可解释性。
- 性能与复杂度正相关
通常,模型结构越复杂,其预测精度等性能指标越高。
- 模型越复杂(大语言模型、深度神经网络),能力越强、预测效果越好。
- 可解释性的负相关
复杂模型如同 “黑盒”,决策过程晦涩难懂,可解释性随之降低。
- 模型复杂度越高,反而越说不清楚它为什么输出这个结果,可解释性变差。
- 测试的核心权衡
测试需在保证性能达标的同时,运用技术手段提升模型透明度。
- AI 测试不是二选一,目标:性能不能丢,同时尽量提升可解释性。
Human‑in‑the‑loop
在传统软件,人更多是使用者;但 AI 系统中,人深度参与完整闭环:提供标注数据训练模型,人工评估模型输出质量,标记错误给出修正,驱动模型迭代优化。依靠人机不断循环,缓解 AI 黑盒带来的输出不确定性问题,持续提高 AI 系统质量。
Human‑in‑the‑loop是 AI 测试与迭代非常重要的思想。
人类不再只是 AI 产品使用者,而是AI 迭代流程里的关键一环,深度介入训练、测试、迭代全流程,用来应对 AI 黑盒、输出不确定的问题。
- 提供标注数据 为模型训练提供高质量、精准的监督信号。
人打标签,给 AI 学习素材。
- 评估模型输出 对 AI 生成结果的质量、准确性进行判断。
AI 跑完结果,人来打分、评判好坏。
- 反馈并修正模型 标记错误并提供修正建议,驱动模型迭代。
指出 AI 哪里错了,给出正确答案,让模型优化。
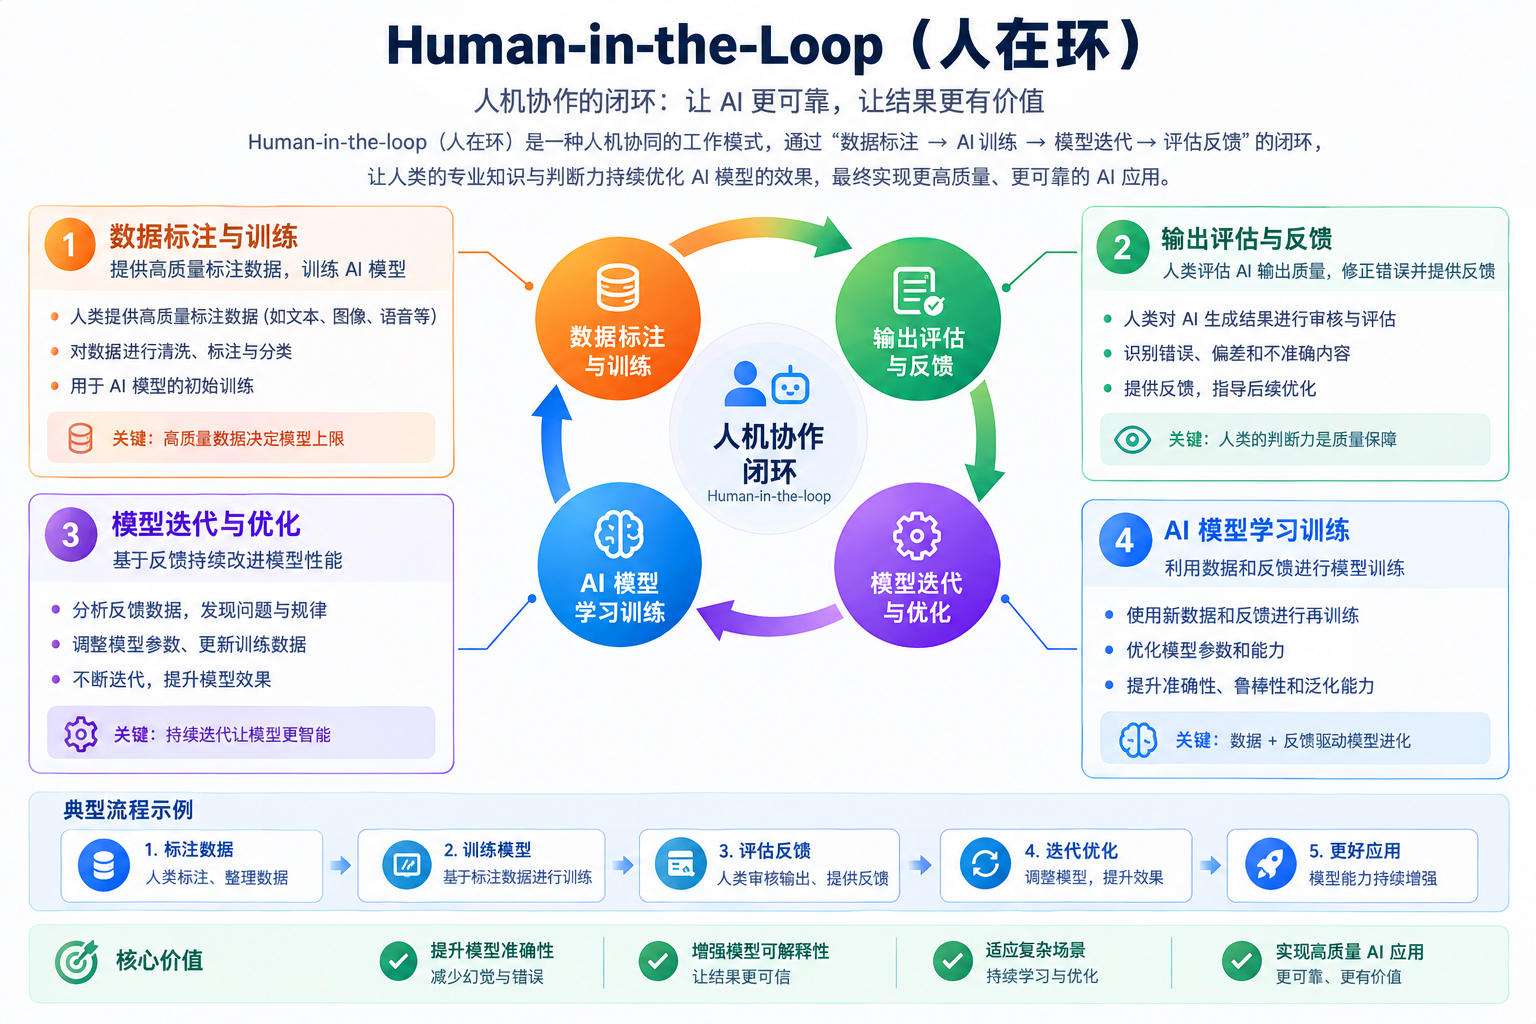
在 AI 测试的人在回路体系中,人工被拆分为三类关键角色:标注员、评估员、反馈者。
标注员负责生产高质量训练与测试数据集;评估员对模型输出做质量评测;反馈员针对错误给出分析和改进建议。三者分工协作,共同完成 AI 系统的质量保障。
- 标注员 Annotator
提供高质量的训练和测试数据。
- 工作:给数据打标签、制作数据集。既产出模型训练用数据,也产出测试集,为 AI 训练、AI 测试提供基准素材。
- 例子:对问答样本标注标准答案;给图片打标签;整理测试用例数据集。
- 评估员 Evaluator
主观或客观地评估模型输出的质量。
- 工作:拿到 AI 输出结果做评判打分,判断结果好不好、是否合规,不只是简单对错,包含主观质量判断。
- 例子:大模型输出的回答做 1‑5 分打分;检查回答是否存在幻觉、偏见;对比参考标准答案做质量评测。
- 反馈者 Feedback
提供错误分析和改进建议。
- 工作:不只指出 AI 错了,还要分析错在哪,给出修正方案,输出可用于模型迭代的反馈。
- 例子:识别模型幻觉,给出正确参考文本;分析模型偏见案例,给出优化方向;整理 badcase,给到微调流程。
三种角色共同构成了 AI 质量保障体系中不可或缺的 “人工智慧” 环节。
| 角色 | 对应Human‑in‑the‑loop环节 |
|---|---|
| 标注员 | 提供标注数据 |
| 评估员 | 评估模型输出 |
| 反馈者 | 反馈并修正模型 |
人工评测的价值与局限
人工评测在 AI 测试中有着不可替代的价值。它可以完成自动化很难做到的主观维度评估,同时捕捉很多长尾边缘场景问题。
但纯人工评测也有硬伤:人力成本昂贵,不适合大规模样本;评测受个人主观影响,很难做到标准统一。
工程实践上一般采用人工 + 自动化评测结合的方案:自动化做大规模初筛,人工聚焦重点样本、长尾 BadCase,互相弥补短板。
人工评测的独特价值
评估非量化指标
自动化工具很难对感性主观维度打分,人工可以判断对话流畅度、幽默感、情感匹配度这类主观体验。
发现长尾问题
自动化用例存在边界,人工更容易捕获边缘场景,比如隐晦偏见、隐蔽幻觉、特殊歧义输入带来的错误。
人工评测的明显局限
成本高、效率低
面对上万条的海量模型输出,全部人工评测人力消耗巨大,评测周期长,跟不上模型快速迭代。
主观性强、难标准化
评测受人员个体影响,同一份 AI 输出,不同评测者给出的判断、打分可以差异很大,很难统一标准。
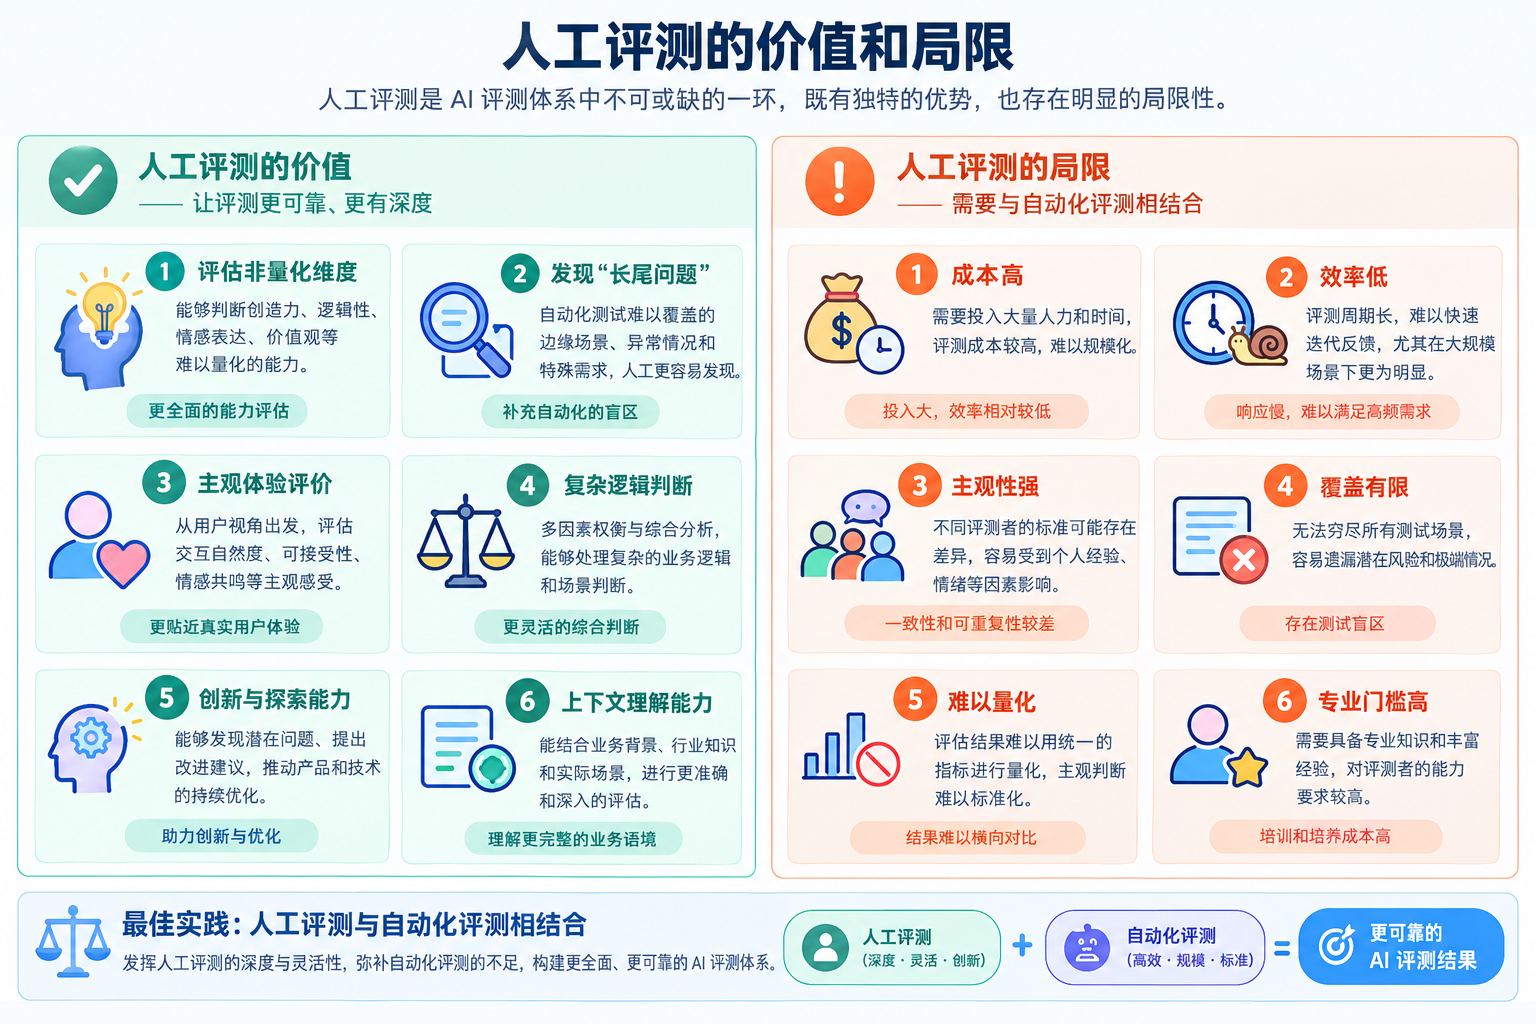
不单独依赖人工评测,也不放弃人工评测。采用自动化做大规模初筛 + 人工聚焦长尾 BadCase、主观体验校验的组合方案,互相弥补短板。
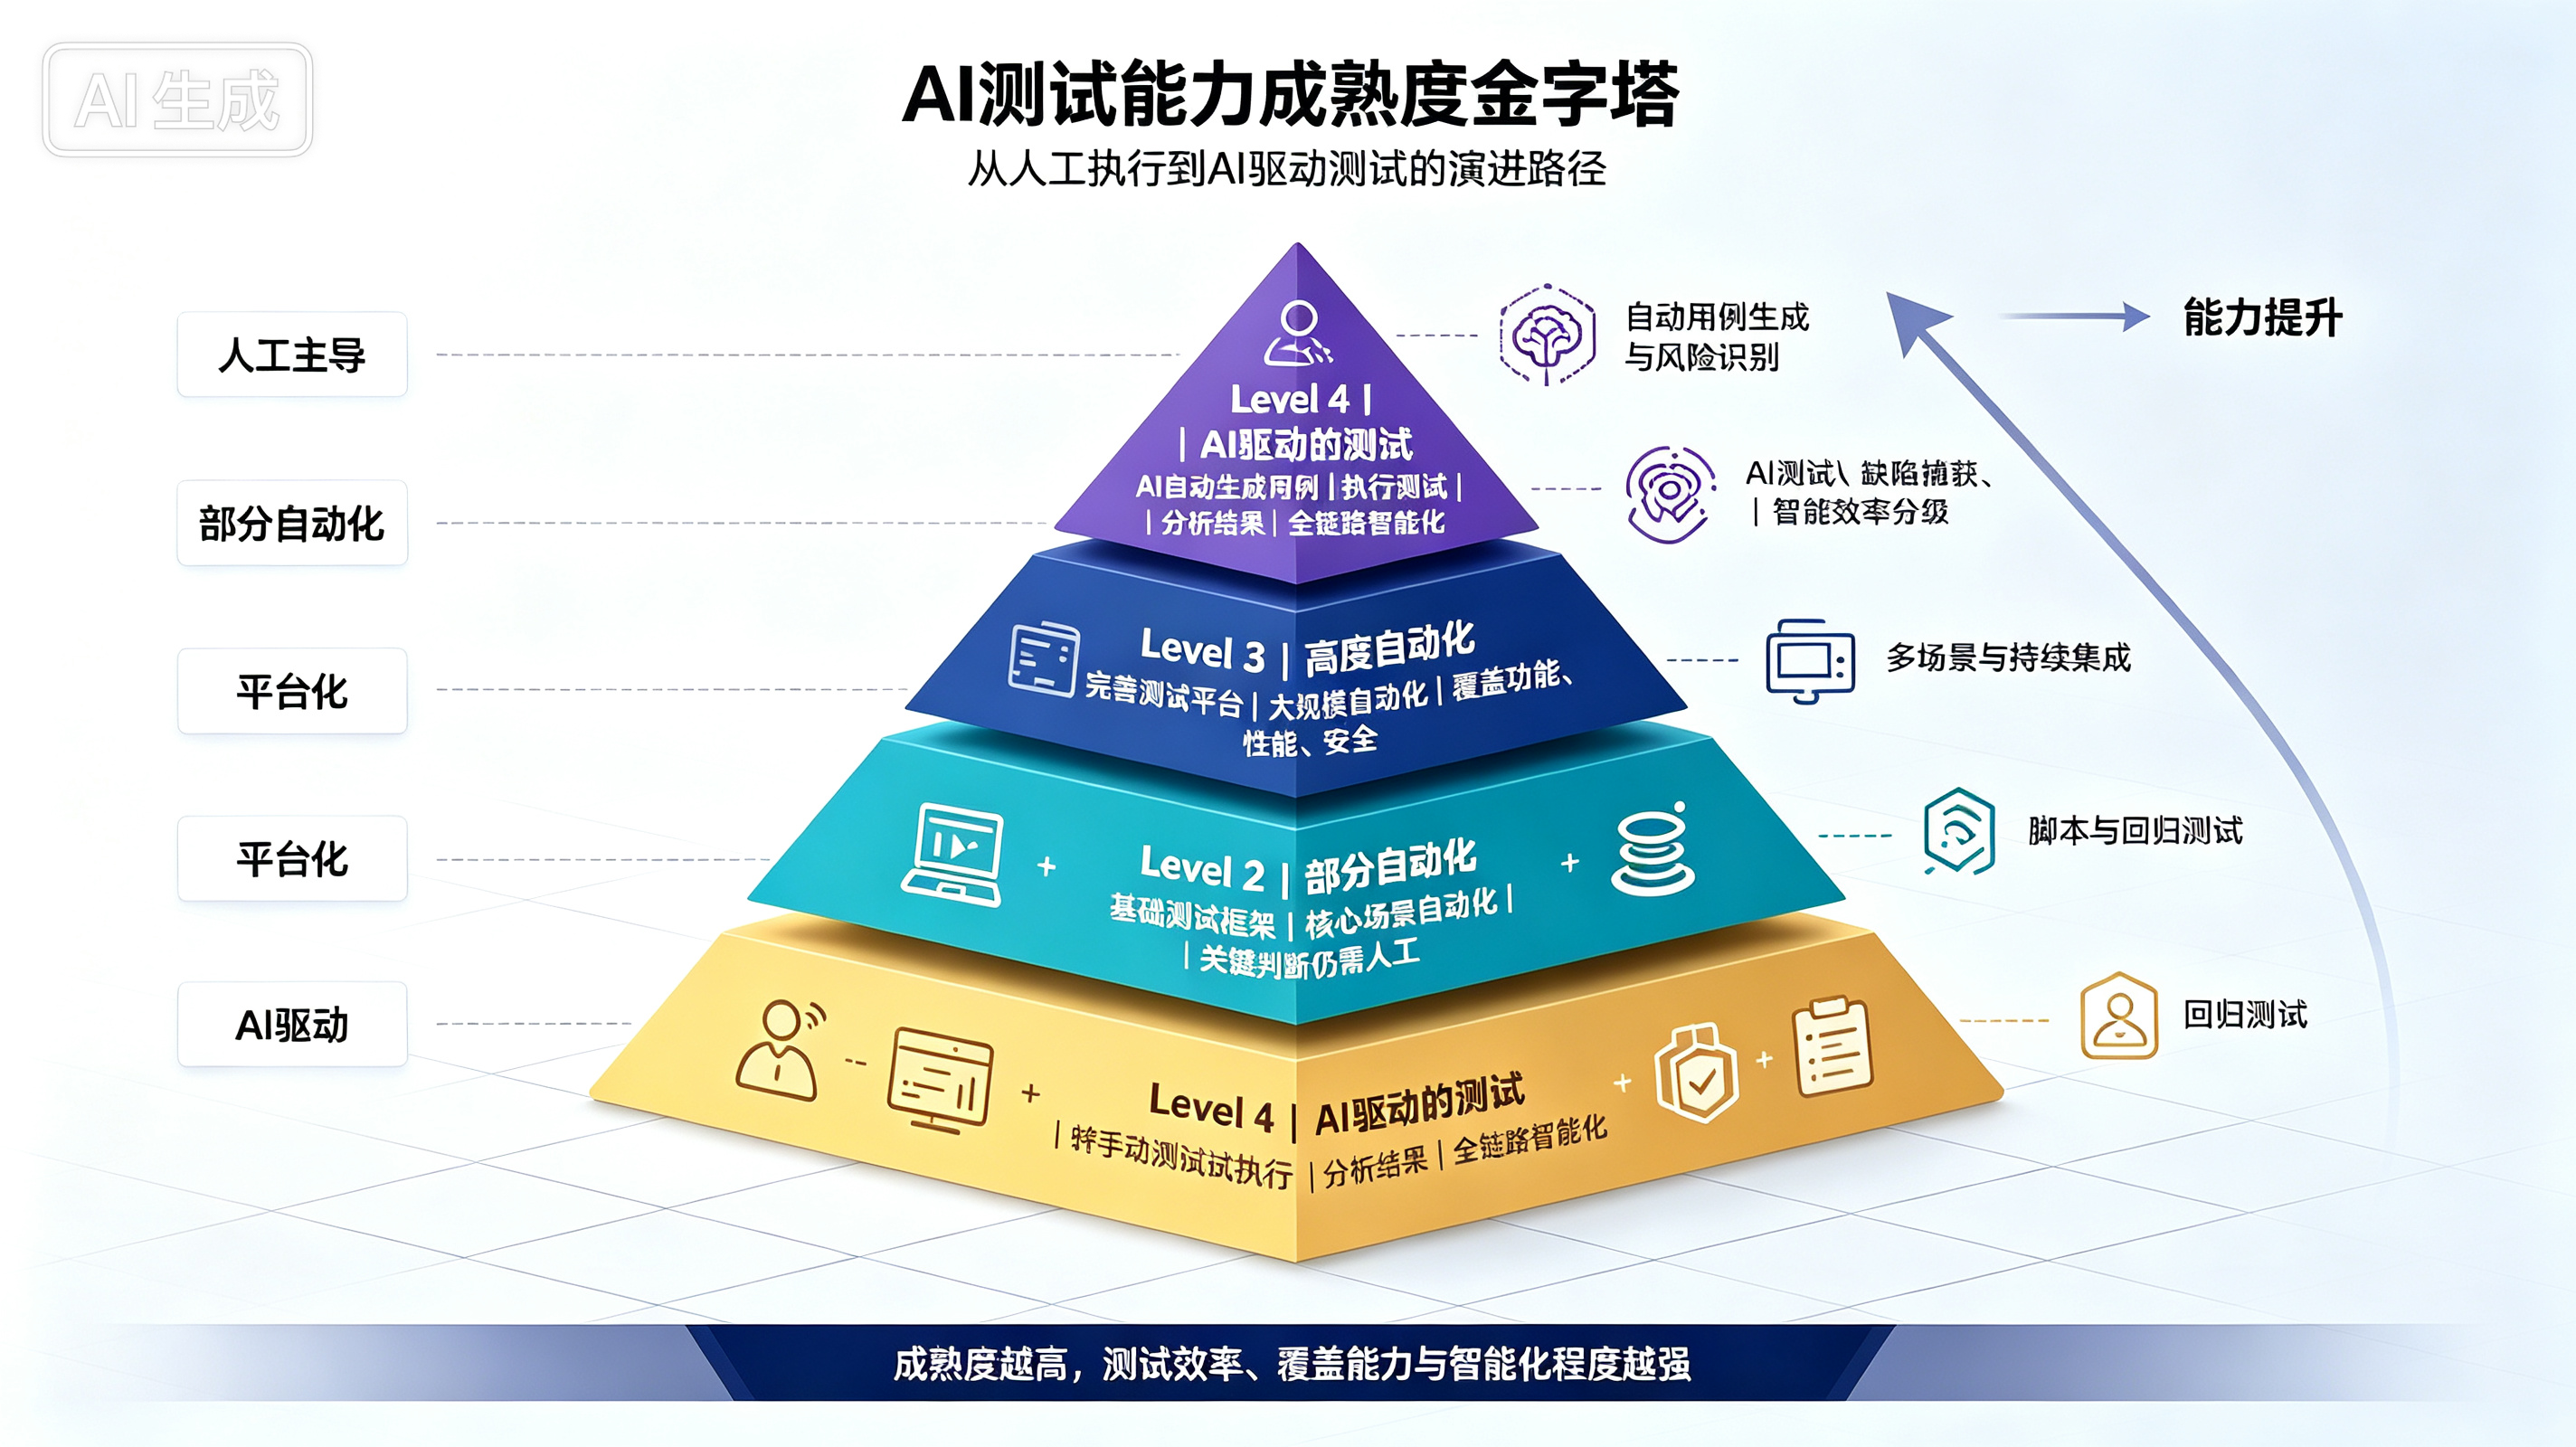
AI 测试能力成熟度
AI 测试能力成熟度金字塔,描述了团队 AI 测试能力的演进路径。
- Level1 完全依靠人工手工测试,成本高覆盖不足;
- Level2 完成部分场景自动化,但体系不完备;
- Level3 建设完整测试平台,实现大规模自动化,覆盖功能、性能、安全,对接持续集成;
- 最高等级 Level4 是AI 测试 AI,由 AI 自动生成用例、执行测试、分析结果,实现测试全链路智能化。
大多数企业目前处于 Level2~Level3,Level4 属于行业理想目标。
Level1:手动测试为主(底层)
主要依赖人工进行测试,效率低下,覆盖面有限。
- 现状:几乎全靠人手工跑测试用例,人工看模型输出好坏。
- 特点:只做基础功能验证;效率低、成本高;很难做大规模回归测试。
- 适用:AI 项目初期、小体量原型验证阶段。
Level2:部分自动化
有了基础的测试框架,实现了部分场景的自动化,但体系尚不完善。
- 现状:核心场景可以写脚本自动化执行,支持回归测试;关键判断依旧需要人工介入。
- 特点:部分场景解放人力,但没有完整平台,很多场景覆盖不到。
- 适用:业务逐步稳定,开始搭建 AI 测试基础能力。
Level3:高度自动化
拥有完善的测试体系和平台,能够支持大规模、高效率的自动化测试。
- 现状:建成完整自动化测试平台;覆盖功能、性能、安全;支持持续集成,测试结果可以反馈给模型迭代。
- 特点:大规模样本可以自动跑测;平台化、工程化;但测试用例还是人来设计维护。
Level4:AI 驱动的测试(AI 测试 AI,最高级)
用 AI 来测试 AI,实现测试用例的自动生成、执行和分析。
- 现状:AI 自动生成测试用例、自动执行、自动分析结果、预判潜在风险,测试全链路智能化。
- 特点:不再完全依赖人去编写用例;可以主动挖掘边界、风险 case;是 AI 测试的理想目标。